Google añade un TPU confidencial y un 8i Max de dos chips, su cuarto sistema este año
Google anunció el 9 de noviembre el TPU 8tx para inferencia confidencial y el TPU 8i Max con dos chips por paquete. Ninguno tiene aún precio ni fecha de envío.

En esta página
Puntos clave
- Google Cloud anunció el lunes 9 de noviembre de 2026 el TPU 8tx, para inferencia confidencial, y el TPU 8i Max, un paquete de dos chips para contextos largos.
- Ambos son configuraciones de sistema en torno al silicio TPU de octava generación que ya existe; Google dice que 2026 es el primer año en que ha presentado cuatro sistemas TPU.
- El TPU 8tx usa el mismo silicio que el TPU 8t con procesadores host AMD EPYC de quinta generación, y Google afirma hasta la mitad de la latencia del 8t con una penalización de rendimiento casi nula.
- El TPU 8i Max duplica la potencia de cálculo y el ancho de banda de SRAM y HBM del TPU 8i al colocar dos chips 8i en un solo paquete dentro del espacio de rack existente.
- Google no publicó precio, fecha de disponibilidad ni especificaciones absolutas; Bloomberg informó, citando a Amin Vahdat, de que ambos sistemas estarán disponibles en 2027.
Google Cloud sumó el lunes 9 de noviembre dos sistemas a su línea TPU de octava generación: el TPU 8tx, concebido para inferencia confidencial, y el TPU 8i Max, que empareja dos chips TPU 8i en un solo paquete para trabajo con contextos largos. Ambos son configuraciones de sistema construidas en torno a silicio que Google ya vende. Ninguno es un chip nuevo. La empresa dice que 2026 es el primer año en que ha presentado cuatro sistemas TPU, después del TPU 8t y el TPU 8i en Google Cloud Next en abril.
Lectura relacionada: Advanced Packaging: el nuevo campo de batalla de la industria de semiconductores · El DSX POD de Nvidia convierte una fábrica de IA en un contenedor marítimo.
Los dos sistemas responden a preguntas distintas del comprador. Una es si un cliente regulado puede ejecutar un modelo sobre datos que no está dispuesto a exponer. La otra es si una carga de agentes que se queda sin ancho de banda de memoria puede conseguir más dentro del mismo rack. La nota de Google no da precio ni fecha de disponibilidad para ninguno de los dos.
Amin Vahdat, director de tecnología y vicepresidente sénior de IA e infraestructura de Google, escribió la entrada. Bloomberg informó de que ambos sistemas se esperan para 2027 y de que Vahdat dijo al medio que estarían disponibles ese año (Quartz). El texto de Google no se compromete con una fecha.
Cuatro sistemas, dos dies
La familia de octava generación tiene ahora cuatro miembros, y descansa sobre dos piezas de silicio. El TPU 8t se ocupa del entrenamiento de escalado, con Google afirmando hasta 2,7 veces mejor rendimiento de entrenamiento que la generación anterior. El TPU 8i se ocupa del razonamiento de baja latencia, con una mejora del 80 % en la relación precio-rendimiento de inferencia, también según la medida de Google. El TPU 8tx toma el silicio del 8t y añade protección de hardware para los datos en uso. El TPU 8i Max pone dos chips 8i en un solo paquete.
Una configuración de sistema es todo lo que hay en una máquina y no es el die: el paquete, la placa, los procesadores host, la red de interconexión y el firmware de seguridad. Cambiar eso puede alterar lo que un centro de datos es capaz de hacer sin un nuevo nodo de proceso, y Google dice que ahora puede hacerlo en meses en lugar de años.
Dos dies que cubren cuatro sistemas es una cadencia más barata que cuatro ciclos de diseño. El riesgo está en lo que una nota de lanzamiento no puede mostrar, es decir, si el software trata las variantes como una sola plataforma.
El 8tx vende la confidencialidad como producto
El TPU 8tx es el tercer sistema de la generación y el que tiene el desencadenante comercial más claro. Usa el mismo silicio que el TPU 8t, con procesadores host AMD EPYC de quinta generación, y añade aislamiento a nivel de hardware para datos sensibles y pesos de modelos mientras están en uso activo. El cifrado convencional en la nube se detiene en el límite de la memoria: los datos se descifran mientras un procesador trabaja con ellos, y esa ventana es la que cierra la computación confidencial.
Google orienta el sistema a empresas reguladas y gobiernos que ejecutan modelos de frontera o propietarios y agentes autónomos junto a datos sensibles. Las cargas que menciona son el ajuste fino sobre datos privados, la destilación de un modelo grande en uno más pequeño y el entrenamiento de agentes mediante aprendizaje por refuerzo. La propuesta es que las tres puedan ocurrir en un solo sistema sin mover datos sensibles entre clústeres.
El 8tx también usa la red Boardfly de baja latencia que Google construyó para el razonamiento en tiempo real, y la empresa afirma hasta la mitad de la latencia del TPU 8t con una penalización de rendimiento casi nula. La protección en uso suele costar algo en rendimiento o en tiempo de respuesta; Google dice que aquí la factura es casi cero.
No se anunció ninguna auditoría de seguridad ni certificación independiente. El aislamiento lo describe Google y ningún tercero lo ha probado en público, que es el tipo de evidencia que los compradores regulados suelen pedir antes de poner datos sensibles en una nube compartida. Para esos compradores, el 8tx sigue siendo un candidato.
El 8i Max duplica el paquete
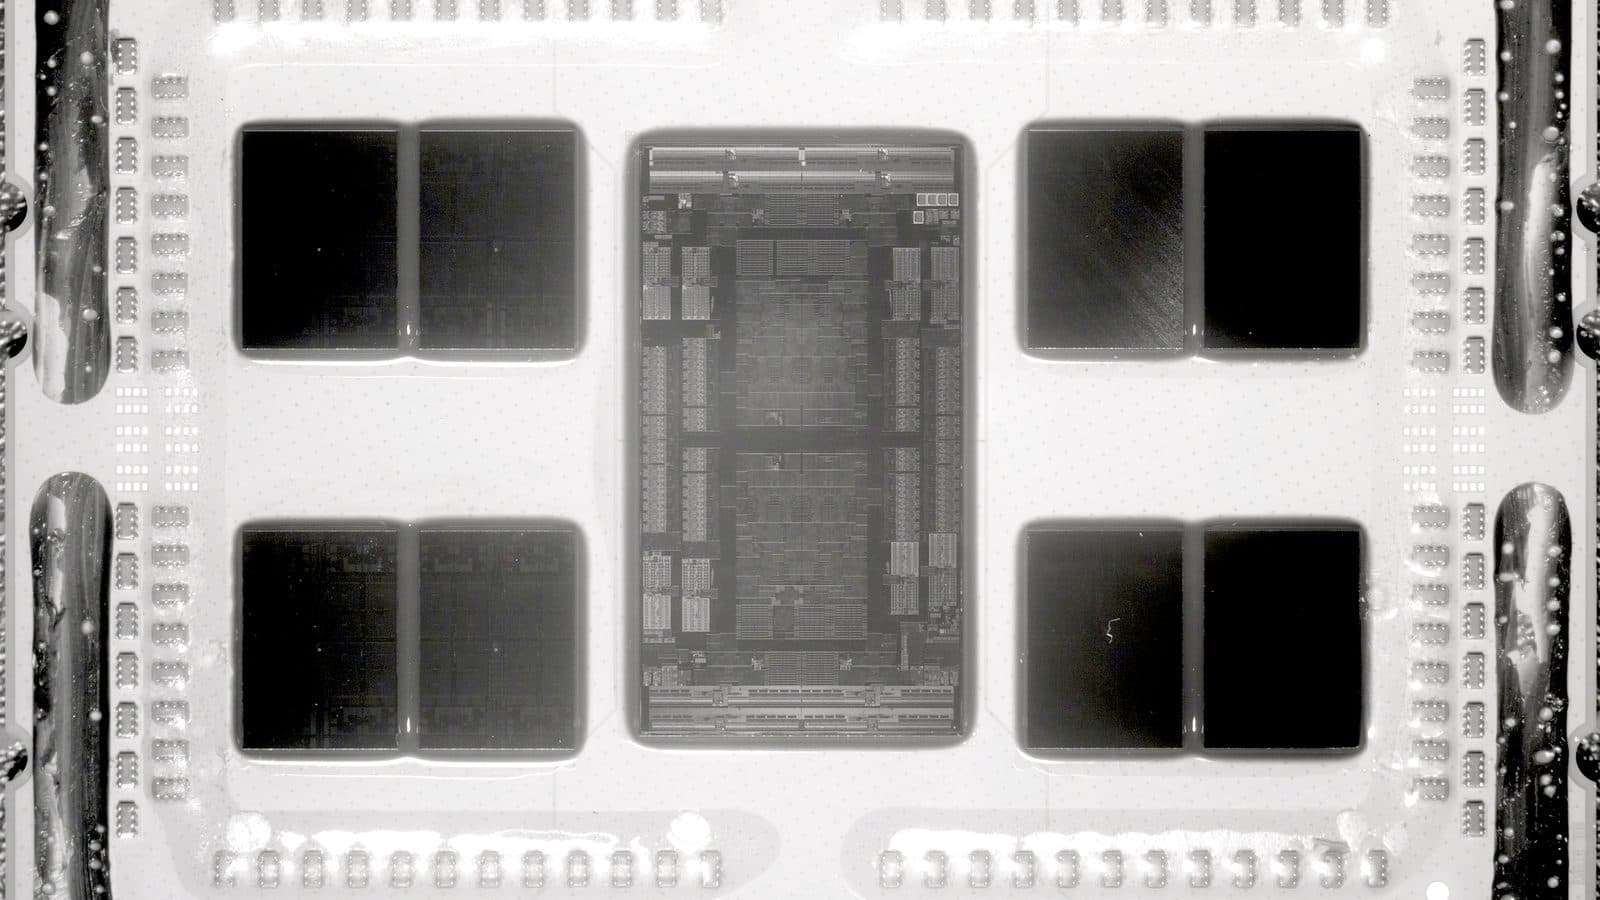
El TPU 8i Max es el cuarto sistema. Combina dos chips TPU 8i de baja latencia en un solo paquete, lo que según Google duplica la potencia de cálculo y el ancho de banda de SRAM y HBM frente a un único 8i. Como usa el espacio de rack existente, la empresa presenta la ganancia como más potencia de cálculo por pie cuadrado y por vatio. La carga a la que apunta es un agente que trabaja sobre una base de código completa o sobre horas de vídeo a la vez, donde el ancho de banda de memoria es la restricción.
Cada token que genera un modelo lee una caché que crece con la ventana de contexto, así que una sesión larga pasa el tiempo moviendo memoria en lugar de hacer aritmética. Dos chips en un paquete duplican el ancho de banda disponible para esa caché, siempre que el software pueda direccionar ambos dies como un solo dispositivo. Google no ha publicado los detalles que resolverían si puede.
Google tampoco publicó especificaciones absolutas, lo que no ha impedido que otros las produzcan. MarkTechPost tomó las cifras publicadas por chip del TPU 8i (10,1 PFLOPS en FP4, 288 GB de HBM, 8.601 GB/s de ancho de banda y 384 MB de SRAM) y las multiplicó por dos. Eso da unos 20,2 PFLOPS, 17,2 TB/s y 768 MB de SRAM. Es aritmética sobre los números de Google, no una hoja de datos de Google, y presupone que el paquete escala de forma lineal.
El escalado lineal es la suposición que conviene vigilar. Un paquete de dos chips comparte sustrato, envolvente de potencia y presupuesto de refrigeración, así que el segundo die no siempre entrega una duplicación limpia a nivel de rack.
Por qué el empaquetado se convirtió en la hoja de ruta
El año de cuatro sistemas es una afirmación sobre la cadencia, y la cadencia es la parte del negocio de TPU que Google más quiere contrastar con Nvidia. La propuesta de Google es que el empaquetado, la memoria, la red y la seguridad pueden recortarse de nuevo en torno al mismo silicio en un ciclo mucho más corto. Esa palanca es más barata de accionar que un nuevo nodo de proceso y atiende las restricciones con las que chocan los compradores: ancho de banda por rack, aislamiento y latencia.
El conjunto competitivo incluye la plataforma Rubin de Nvidia, Maia 200 de Microsoft y Trainium3 de AWS, entre otros. Nvidia sigue siendo el proveedor comercial dominante de aceleradores, y nada del anuncio del lunes cambia eso. Los TPU de Google se venden a través de Google Cloud y, cada vez más, se despliegan directamente en los centros de datos de los propios clientes, según el blog.
Google describe los TPU como «un negocio en rápido crecimiento con cerca de 100 clientes». — Amin Vahdat, director de tecnología y vicepresidente sénior de IA e infraestructura de Google, 9 de noviembre de 2026
Esa cifra de clientes no está auditada y llega sin desglose de ingresos, así que mide amplitud y no escala. Google cita entre sus usuarios laboratorios de frontera, firmas de trading, minoristas y universidades. No dice qué parte del negocio es externa, qué parte es entrenamiento propio de Gemini ni cuánto paga cada uno de esos clientes por chip-hora.
Los proveedores de todo el mercado de aceleradores están añadiendo memoria y ancho de banda alrededor de silicio existente. Para el lado chino de esa carrera, véase nuestro informe sobre los planes de preentrenamiento de DeepSeek con Huawei Ascend.
La pila de software es donde se movió el coste de cambio
Google también anunció cambios de software que pesan más en el coste total de un comprador que cualquier especificación aislada. TorchTPU se liberó el mes pasado, de modo que el código de PyTorch y los modelos de Hugging Face se ejecutan de forma nativa en TPU, con backends de TPU para vLLM y SGLang. Una nueva suite de agentes TPU de código abierto, en versión preliminar, se conecta a Claude Code, Cursor y Google Antigravity para automatizar la incorporación, diagnosticar cuellos de botella y ajustar kernels automáticamente en lenguaje natural.
También hay un nuevo XLA Serving Engine de código abierto, que permite a los equipos entrenar en Python y servir en un entorno de ejecución C++ de baja latencia a través de TPU, GPU y CPU. Agent Compute Engine suspende y reanuda sesiones de agentes inactivas para recortar el gasto en infraestructura. TPU Sync, una capa de estado de modelo de código abierto, organiza las cachés KV por niveles entre HBM, DRAM del host, almacenamiento compartido y la red del centro de datos, y Google dice que reduce más del 90 % la latencia de transferencia de KV y el tiempo hasta el primer token. Cloud Pathways, el entorno de ejecución distribuido que hay detrás de Gemini, ya está disponible de forma general en GKE, y el slicing dinámico de GKE también, con Google afirmando hasta 5 veces más rapidez en el arranque de trabajos y hasta 4,5 veces más rapidez en la recuperación de fallos.
Google cita un rendimiento por precio líder en los benchmarks InferenceX y AgentX con su pila nativa vLLM-TorchTPU, con nuevas evaluaciones de SemiAnalysis. Son los benchmarks que Google ha elegido, ejecutados sobre la propia pila de software de Google. Son evidencia de que la pila ya no es el eslabón débil, no una comparación homogénea con el rack de un competidor en una carga que ninguna de las dos empresas eligió.
El coste de cambio se ha trasladado a esa pila. Un rival puede igualar la especificación de un chip en una hoja de datos. Igualar un compilador, un conjunto de kernels ajustados, un motor de servicio y una capa de orquestación lleva más tiempo, y eso es lo que Google está construyendo. Las ganancias van a los equipos que están dentro de la pila de Google; un equipo que use otro framework, o sus propios kernels, recibe menos de la mejora.
Lo que Google no dijo
La nota de Google es extensa en arquitectura y escasa en lo que un comprador necesita para firmar un contrato. No hay precio, ni fecha de disponibilidad, ni lista de regiones, ni tipo de instancia, ni hoja de datos. La mayoría de las cifras de rendimiento son ratios frente a productos anteriores de Google, que dicen cuánto mejor debería ser el nuevo sistema que el viejo y nada sobre cómo se compara con un rack de Nvidia.
Las cifras que faltan
Las cifras de la mitad de la latencia, el doble de cálculo, el doble de SRAM y el doble de ancho de banda son de Google, medidas contra sus propias piezas anteriores, y ninguna se ha verificado de forma independiente. El resultado de TPU Sync, una reducción de más del 90 % en la latencia de transferencia de KV, se midió en Ironwood, la generación anterior, no en el 8tx ni en el 8i Max. Ningún tercero ha publicado un benchmark ni una auditoría de seguridad de ninguno de los dos sistemas nuevos.
La fecha de 2027 viene de Bloomberg y no de Google. Vahdat dijo al medio que los sistemas estarían disponibles ese año, y la nota de la empresa no repite el compromiso (Gizmodo). Los compradores que planifiquen capacidad para el año que viene tendrán que tratar la fecha como una información periodística y no como un compromiso.
La computación confidencial tiene una laguna parecida. Google dice que el 8tx protege los datos en uso a nivel de hardware, y ningún organismo de certificación lo ha confirmado. La función es un requisito de compra en finanzas, sanidad y sector público, y esos compradores suelen pedir un informe de atestación más que un diagrama de arquitectura.
Un precio por chip-hora, y si el 8i Max se vende como rack completo o como una porción de uno, convertiría una afirmación de capacidad en un dato para el presupuesto. Un cliente con nombre ejecutando el 8i Max en producción, con la factura antes y después, valdría más que un gráfico de benchmark. Una prueba independiente contra Rubin o Trainium3 con el mismo modelo zanjaría la comparación que Google evita, y una certificación de terceros decidiría si los compradores regulados pueden usar el 8tx.
Hasta que llegue una de esas cosas, los dos sistemas existen como especificaciones y demostraciones. Google tiene cuatro sistemas TPU para 2026 y ninguna fecha de envío propia para los dos más recientes.
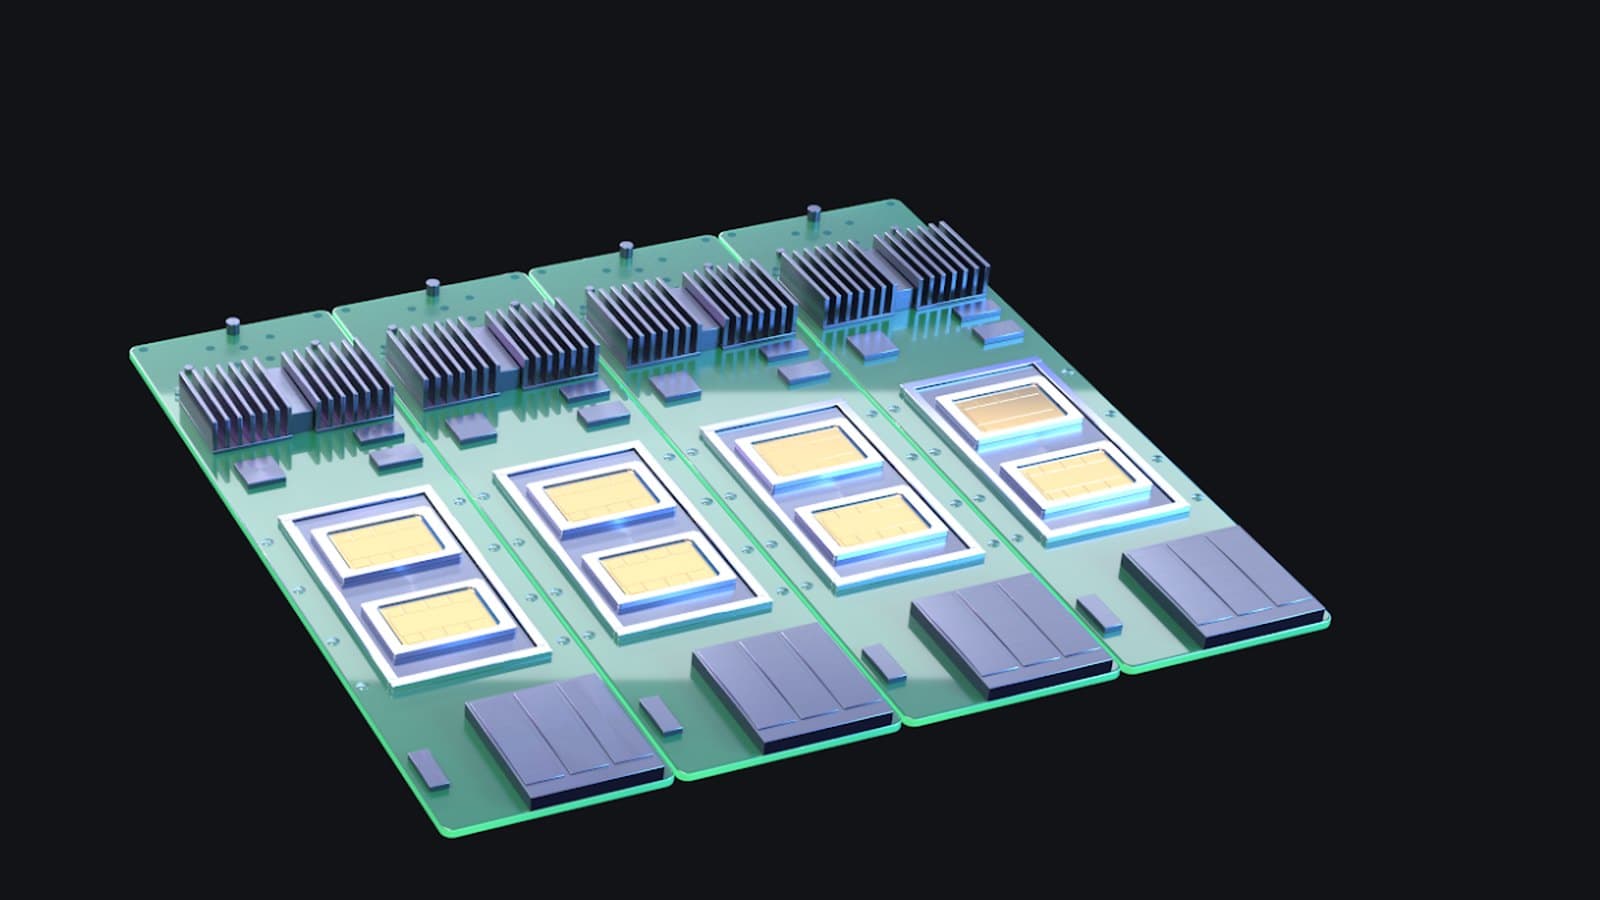
Imagen de portada: render oficial de Google de las placas TPU 8tx y TPU 8i Max.
Etiquetas
Preguntas frecuentes
- ¿Qué es el Google TPU 8tx?
- El TPU 8tx es un sistema de Google Cloud para inferencia segura y confidencial. Usa el mismo silicio que el TPU 8t, lo combina con procesadores host AMD EPYC de quinta generación y añade protección a nivel de hardware que mantiene aislados los datos y los pesos del modelo mientras están en uso. Google lo orienta a empresas reguladas y gobiernos que ejecutan modelos y agentes propietarios junto a datos sensibles.
- ¿Qué es el TPU 8i Max?
- El TPU 8i Max es un paquete que contiene dos chips TPU 8i de baja latencia. Google dice que duplica la potencia de cálculo y el ancho de banda de SRAM y HBM frente a un único chip 8i y que mete el doble de silicio en el mismo espacio de rack, pensado para agentes que trabajan sobre una base de código completa o sobre horas de vídeo.
- ¿Cuándo estarán disponibles el TPU 8tx y el TPU 8i Max?
- El anuncio de Google no da fecha de disponibilidad. Bloomberg informó de que ambos sistemas se esperan en 2027, y Amin Vahdat, director de tecnología de IA e infraestructura de Google, dijo al medio que estarían disponibles ese año. Es la información de Bloomberg, no un compromiso de la entrada de blog de Google.
- ¿Son oficiales las cifras de rendimiento de los nuevos TPU?
- Las ratios de rendimiento que publicó Google son afirmaciones propias y no se han verificado de forma independiente para estos sistemas. Las cifras absolutas que circulan sobre el TPU 8i Max, unos 20,2 PFLOPS en FP4 y 17,2 TB/s de ancho de banda, las calculó MarkTechPost duplicando los números publicados por chip del TPU 8i, y no son especificaciones de Google.

TPW Editorial
Redacción
El equipo editorial de TechPastWeek investiga y edita cada artículo que publicamos. Cada historia se contrasta con fuentes primarias y secundarias fiables, y un editor la revisa antes de publicarse.