Advanced Packaging: el nuevo campo de batalla de la industria de semiconductores
Los transistores más pequeños ya no bastan. Cómo el empaquetado avanzado, chiplets, apilado 2,5D/3D, HBM, se convirtió en el campo de batalla de los chips.

En esta página
Durante medio siglo, la industria de los semiconductores funcionó con un solo pacto: haz el transistor más pequeño y todo será más rápido, más denso y más barato. Ese pacto se ha roto. El trabajo físico de encoger transistores continúa, pero la recompensa económica se ha estrechado hasta tal punto que las mayores ganancias de rendimiento provienen cada vez más de otro lugar: de cómo se ensamblan los chips, no de cómo se dibujan sus transistores.
Lectura relacionada: Samsung abre un laboratorio de empaquetado en Yokohama para cerrar su brecha en HBM · Los ingresos de Micron casi se quintuplican hasta un récord de 54.23 mil millones de dólares por la demanda de memoria para IA.
El empaquetado avanzado, antaño el poco glamuroso back end de la fabricación de chips, se ha convertido en el verdadero campo de batalla de la industria. Es donde hoy se deciden el ancho de banda de memoria, el rendimiento del sistema, el rendimiento de fabricación y el coste por cómputo. Es un cambio duradero, no pasajero, y entenderlo exige entender por qué la vieja palanca dejó de funcionar.
Por qué la escala por sí sola dejó de bastar
La ley de Moore nunca fue solo una predicción tecnológica. Era un motor económico. Como la densidad de transistores se duplicaba aproximadamente cada dos años mientras el coste de procesamiento de obleas por unidad de área se mantenía más o menos plano, el coste de fabricar un transistor caía de forma constante, históricamente una media de 20 a 30 por ciento al año. Esa caída hizo que la informática fuera lo bastante barata para meterla en todas partes.
El motor se ha atascado. El trabajo de Zvi Or-Bach en MonolithIC 3D, corroborado después por Milind Shah en Google, indicaba que el coste por transistor dejó de caer en el nodo de 28 nm y desde entonces se ha mantenido plano o ligeramente al alza. En la vanguardia, los análisis de la economía de nodos avanzados describen ya algo más parecido a una inversión: las obleas de 2 nm se han reportado a unos 30.000 dólares, alrededor de un 50 por ciento más que las de 3 nm, frente a costes de fábrica de vanguardia de 15.000 a 20.000 millones de dólares o más.
Tres restricciones se refuerzan mutuamente:
- El límite del retículo. Las herramientas de litografía solo pueden exponer cierta área en una pasada. En la práctica, eso limita una matriz monolítica a unos 800 mm²: un techo duro para cuánta cómputo cabe en una sola pieza de silicio.
- La economía del rendimiento. Las matrices grandes tienen una probabilidad exponencialmente mayor de capturar un defecto letal, de modo que una matriz mayor implica una fracción menor de piezas buenas por oblea.
- El problema del nodo equivocado. No todas las funciones necesitan el transistor más caro. Lo analógico, la RF, la E/S y la SRAM a menudo obtienen poco o nada de la vanguardia, pero se arrastran si comparten matriz con la lógica que sí lo hace.
«Podría resultar más económico construir grandes sistemas a partir de funciones más pequeñas, empaquetadas e interconectadas por separado.» — Gordon Moore, 1965
El propio Moore anticipó la respuesta hace décadas. La industria ha pasado los años transcurridos convirtiendo esa observación en una disciplina de fabricación.
Qué es realmente el empaquetado avanzado
El empaquetado avanzado es el conjunto de técnicas para integrar múltiples matrices (y a veces otros componentes, como pilas de memoria, dispositivos pasivos o motores ópticos) en un único encapsulado, conectados por un cableado mucho más denso del que jamás podría ofrecer una placa de circuito convencional. La vieja visión trataba el encapsulado como una carcasa protectora. La nueva visión lo trata como el sistema.
La familia abarca un espectro que va de «2D» (matrices una al lado de otra sobre un sustrato) a «2,5D» (matrices sobre un interposer o capa puente compartidos) y «3D» (matrices apiladas verticalmente y conectadas a través del silicio), con gradaciones más finas entre medias que los ingenieros etiquetan 2,3D, 3,3D y 3,5D según qué capas portan el cableado de alta densidad.
        ┌─────────────────────────────────────────────┐
        │              System board (PCB)              │
        └─────────────────────────────────────────────┘
                   │  package-to-board solder balls
        ┌─────────────────────────────────────────────┐
        │              Package substrate               │
        │      (organic / glass-core / RDL-based)      │
        └─────────────────────────────────────────────┘
             │  C4 bumps · microbumps · hybrid bond
        ┌────────────┬───────────────┬────────────────┐
        │  HBM stack │  Compute die  │   I/O chiplet  │
        │ (DRAM × N) │    (logic)    │                │
        └────────────┴───────────────┴────────────────┘
              └──── interposer / bridges (2.5D) ────┘
Cuanto más alto se sube en esa pila, más cortos son los hilos, menor es la energía por bit y más difícil la fabricación. Casi todos los compromisos del empaquetado avanzado son una versión de eso.
La caja de herramientas
Interposers y puentes: el caballo de batalla 2,5D
La arquitectura dominante para la computación de alto rendimiento coloca matrices lógicas y memoria una al lado de otra sobre un interposer de silicio compartido: una pieza de silicio cuyo único trabajo es enrutar conexiones densas entre ellas. El CoWoS de TSMC (Chip-on-Wafer-on-Substrate) es el ejemplo canónico. Su variante de interposer de silicio soporta áreas de hasta 3,3 veces el retículo (unos 2.700 mm²); las variantes más nuevas basadas en RDL y en puentes cambian algo de densidad por coste, flexibilidad y la capacidad de escalar aún más. En lugar de enrutar todo a través de un único interposer gigante, algunos diseños incrustan pequeños chips «puente» o interconexiones de silicio locales solo donde se necesita ancho de banda: una vía intermedia consciente del coste.
HBM: la memoria como problema de apilado
La High-Bandwidth Memory es en sí misma un producto de empaquetado avanzado: una pila de matrices DRAM conectadas mediante vías de silicio (TSV), situada junto a una matriz lógica. Los aceleradores de IA viven o mueren según la rapidez con que alimentan sus unidades de cómputo, lo que ha convertido la HBM en uno de los componentes más estratégicos de la industria.
Apilar HBM más alto choca con la física y la economía. Las piezas actuales de HBM apilan 8–12 matrices; empujar hacia 20 o más implica que los diminutos microbumps de soldadura entre capas consuman demasiada altura y añadan resistencia térmica, como ha documentado IEEE Spectrum. La ruta de migración pasa por el hybrid bonding y matrices más delgadas, junto con interfaces más anchas: las generaciones de HBM han pasado de unas 1.024 conexiones a unas 2.048, según presentaciones de la industria sobre hybrid bonding.
Hybrid bonding: ir a la vertical de verdad
El hybrid bonding une dos matrices con conexiones directas de cobre a cobre, sin soldadura. Eso permite que el paso entre conexiones se reduzca drásticamente: densidades de 10.000 a un millón de conexiones por milímetro cuadrado, con una energía inferior a 0,05 picojulios por bit, frente a menos de mil por mm² en los microbumps de soldadura. El beneficio son caminos más cortos, menos potencia y la capacidad de colocar caché o memoria directamente sobre la lógica. Los costes son un control de proceso severo, preparación de superficies, sensibilidad a las partículas y precisión de alineación, razón por la cual las matrices que pasan el test se unen típicamente die-a-wafer en lugar de wafer-a-wafer.
UCIe: hacer que los chiplets sean plug-and-play
Para que las arquitecturas de chiplets cumplan su promesa de reutilización, una matriz de un proveedor tiene que hablar con una matriz de otro. UCIe es el estándar abierto que intenta lograrlo, y define una capa física die-a-die, una capa de enlace y una pila de protocolos que se mapea sobre PCI Express y Compute Express Link. La especificación abarca deliberadamente dos clases de empaquetado (un encapsulado estándar de bajo coste para integración 2D y encapsulados avanzados para 2,5D y 3D eficientes en energía), de modo que un único diseño de interfaz pueda reutilizarse en distintos productos. Las revisiones posteriores añaden test, depuración y gestionabilidad para sistemas multi-chiplet, así como mayores velocidades de enlace.
Empaquetado a nivel de panel: la búsqueda de escala
El empaquetado avanzado se construye hoy sobre todo en obleas redondas de 300 mm, pero el coste del fan-out de gran área empuja a la industria hacia paneles cuadrados, que desperdician menos material y procesan más área por paso. Yole Group espera que el empaquetado a nivel de panel crezca más del 40 por ciento anual hasta 2031, impulsado por el fan-out y la integración 2,5D para IA y HPC. Los procesos a nivel de panel son un candidato destacado para mantener asequibles los grandes interposers a medida que crecen.
Los actores y una nueva división del trabajo
El empaquetado avanzado redibuja la cadena de suministro de semiconductores porque se sitúa entre la fabricación de obleas front-end y el ensamblaje clásico.
- Foundries. TSMC, Intel y Samsung han hecho del empaquetado parte de sus ofertas de plataforma, agrupándolo con la lógica de vanguardia para que los clientes obtengan un módulo validado de cómputo, memoria e interconexión. Es una fuente significativa de apalancamiento: la lógica de vanguardia y el empaquetado que la hace utilizable vienen cada vez más como un solo paquete.
- OSATs y fabricantes de equipos. Las casas de ensamblaje y test subcontratados y las empresas que suministran sus herramientas (sistemas de unión por termocompresión, equipos de hybrid bonding, metrología y equipos de manejo de paneles) poseen buena parte del know-how práctico. La demanda de equipos se desplaza hacia matrices compuestas mayores, herramientas chip-on-panel y hybrid bonding.
- EDA e IP. El diseño multi-die es hoy un problema de co-diseño que abarca la matriz, el interposer, el encapsulado y la placa. Exige un modelo de datos compartido y nuevas herramientas de verificación y análisis térmico, y las interfaces estándar como UCIe son lo que permite reutilizar bloques de IP como chiplets en lugar de rediseñarlos.
La frontera entre «foundry», «OSAT» y «empresa de sistemas» se difumina. Quien controla la interconexión de alta densidad controla el punto de integración, y el margen.
La economía: matrices buenas conocidas, rendimiento y coste por transistor
La razón por la que el empaquetado se volvió estratégico es aritmética.
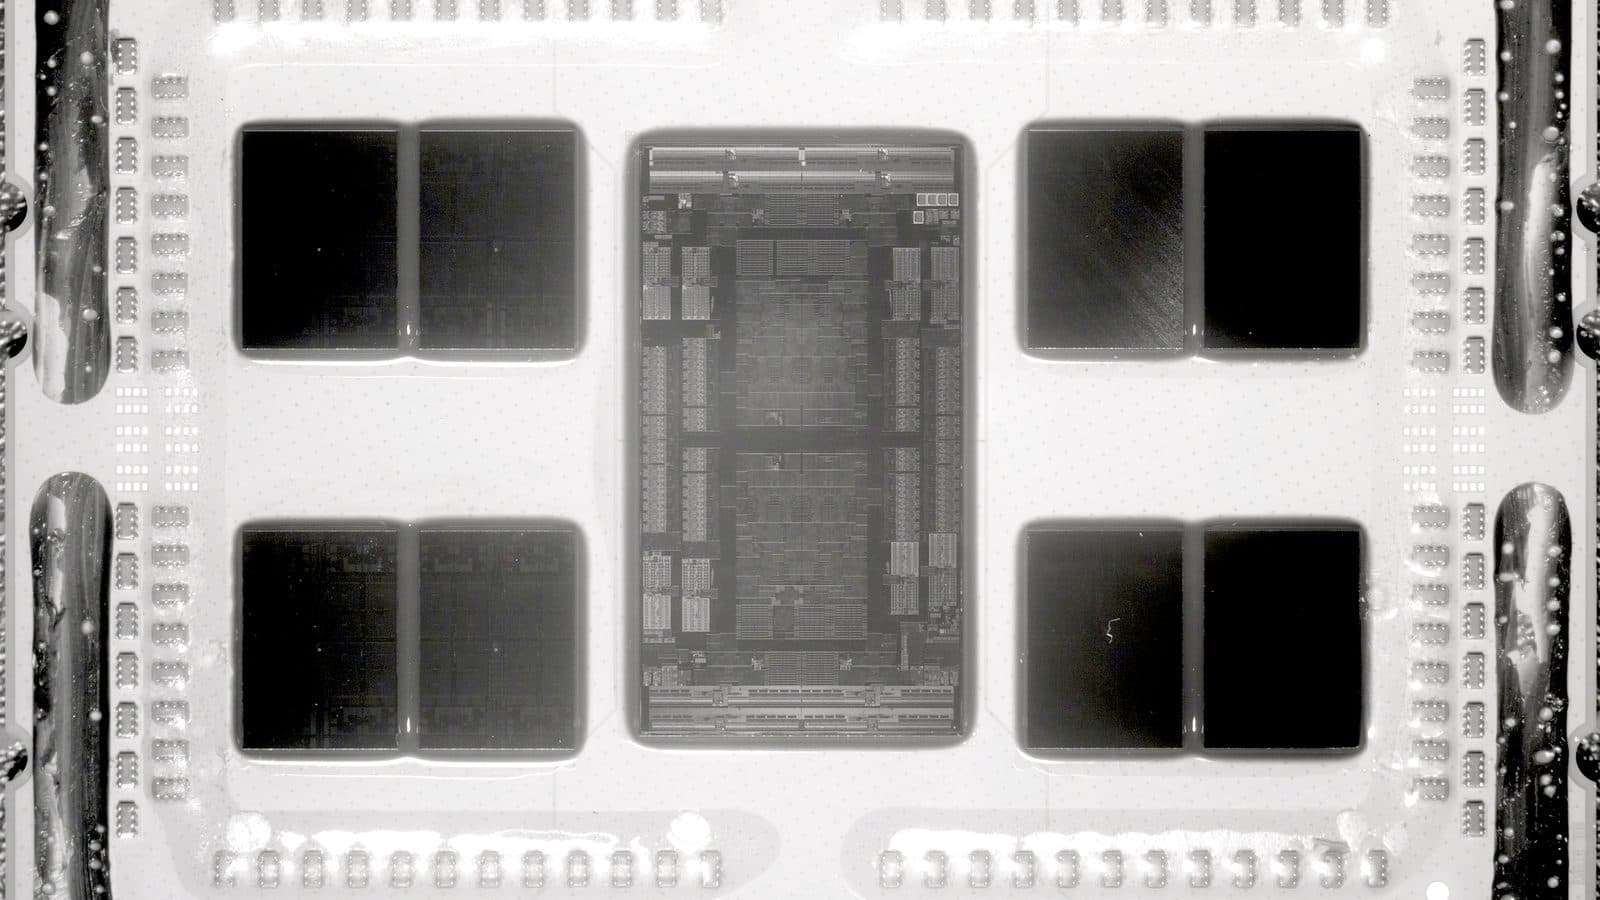
Una matriz monolítica es tan buena como su punto más débil. Divídela en cuatro matrices más pequeñas y un único defecto letal arruina solo un cuarto del silicio; cada matriz puede probarse antes del ensamblaje y los supervivientes reensamblarse. Los ingenieros de AMD modelaron exactamente esto para una CPU chiplet temprana y estimaron que el diseño de cuatro chiplets costaba aproximadamente 0,59 veces la hipotética versión monolítica, aunque usaba algo más de silicio total.
Ese es el lado positivo. El negativo es que el empaquetado introduce sus propias capas de rendimiento y coste:
- Test de matrices buenas conocidas (KGD). Cada chiplet debe probarse antes de comprometerlo a un encapsulado caro. Ese test añade coste y tiempo de ciclo, pero evita que una sola matriz muerta destruya un ensamblaje de alto valor.
- Rendimiento a nivel de encapsulado. Defectos de unión, defectos del interposer, alabeo y partículas pueden matar un módulo totalmente ensamblado. El hybrid bonding die-a-wafer ayuda al permitir que matrices verificadas se unan a matrices base verificadas.
- Coste de integración. El propio libro blanco de AMD enumera la complejidad del empaquetado, el menor rendimiento global del sistema y la latencia como penalizaciones reales de la desagregación. Dividir un diseño no es gratis.
- Disponibilidad de sustratos. Los sustratos orgánicos y de vidrio grandes y resistentes al alabeo son un recurso finito, y su demanda se ha convertido en un cuello de botella por derecho propio.
El resultado neto es que el «coste por transistor» (la métrica que una vez justificó cada nodo) es ahora solo parte de la historia. Lo que importa es el coste por encapsulado, el coste por vatio y el coste por unidad de rendimiento entregado, y esos dependen en gran medida de lo bien que se integren las matrices.
Qué significa para CPUs, GPUs y aceleradores
El manual de los chiplets ya es visible en toda la industria, pero no se aplica igual en todas partes.
En las CPU, la desagregación tiene que ver sobre todo con coste y modularidad. Un procesador de servidor puede combinar muchas matrices de cómputo idénticas con una matriz de E/S separada fabricada en un proceso más antiguo y barato, y luego escalar el número de núcleos y la caché simplemente añadiendo matrices. Las generaciones modernas de EPYC de AMD llevan hasta 16 chiplets de cómputo alrededor de una sola matriz de E/S, compartiendo silicio entre familias de productos y aprovechando las matrices buenas de forma mucho más eficiente de lo que lo haría un diseño monolítico.
En los aceleradores de IA, el empaquetado está más cerca del producto mismo. Nvidia y AMD ilustran dos filosofías distintas: un análisis de analistas contrasta el B200 de Nvidia (208.000 millones de transistores en dos chiplets) con el MI350 de AMD, con 185.000 millones de transistores en ocho, enmarcándolo como rendimiento primero frente a coste primero. Ambos enfoques conceden el mismo punto: los aceleradores más grandes ya no pueden construirse como matrices únicas, así que es el encapsulado (no el transistor) el que fija los límites de ancho de banda de memoria, entrega de energía y escala.
Por eso también la capacidad de empaquetado se ha convertido en un cuello de botella estratégico. Un diseño puede estar listo y las obleas lógicas pueden estar disponibles, pero el producto sigue sin poder enviarse sin capacidad de interposer, HBM y ensamblaje. En ese sentido, el centro de gravedad de la industria se ha desplazado de la fábrica al encapsulado.
Advertencias y problemas abiertos
El empaquetado avanzado no es una panacea, e introduce nuevos modos de fallo a la vez que resuelve los antiguos.
- Calor. Las matrices apiladas atrapan el calor, y las pilas de memoria-sobre-lógica y lógica-sobre-lógica dificultan la refrigeración justo donde la densidad de potencia es mayor. La gestión térmica, y no solo el diseño eléctrico, condiciona ahora el rendimiento.
- Tensión mecánica. Materiales con coeficientes de expansión térmica distintos se unen a escala, creando alabeo y retos de fiabilidad que crecen con el tamaño del encapsulado.
- Entrega de energía. Los encapsulados grandes con altas corrientes transitorias someten a la red de distribución de energía; sostener la tensión ante cambios rápidos de carga es tanto un problema de empaquetado como de circuito.
- Test y depuración. Una vez unidas las matrices, son difíciles de sondear. El acceso de test, la telemetría y la depuración en múltiples chiplets son áreas activas de estandarización.
- Madurez del ecosistema. Las interfaces estándar y los chiplets interoperables mejoran, pero el mercado plug-and-play de chiplets sigue siendo más aspiración que realidad. Muchos diseños de gran volumen usan enlaces die-a-die propietarios.
- El propio impuesto de la desagregación. Repartir el trabajo entre matrices cuesta latencia y rendimiento por vatio. Para productos sensibles a la latencia o al coste, los diseños monolíticos aún pueden ganar.
Qué observar
La dirección es clara: más matrices, conexiones más densas, encapsulados más grandes y más valor del sistema capturado en la capa de integración. Las preguntas interesantes son qué técnicas pasan de premium a mainstream.
- Sustratos de vidrio e interposers de vidrio, que prometen encapsulados grandes más planos y dimensionalmente estables y podrían aliviar el problema de alabeo que limita los sustratos orgánicos.
- Empaquetado a nivel de panel, que debe demostrar su rendimiento y uniformidad antes de desplazar los flujos a nivel de oblea para productos de gran volumen.
- Hybrid bonding en memoria, que determina si la HBM puede seguir apilando más alto sin romper los presupuestos térmicos y de altura.
- UCIe y el ecosistema de chiplets, donde las funciones de test, gestionabilidad y cumplimiento importan tanto como el ancho de banda bruto.
- Óptica co-empaquetada, que traslada los enlaces de alta velocidad de las pistas de cobre al encapsulado y podría reconfigurar la interconexión de los centros de datos.
- Capacidad y coste del empaquetado avanzado, el límite práctico de la rapidez con que todo esto escala.
Nada de esto hace irrelevante la escala de transistores. La lógica de vanguardia sigue siendo donde vive la computación más rápida y eficiente, y los nodos siguen avanzando. Pero los retornos vienen ahora de combinar las matrices adecuadas en el encapsulado adecuado, no de encoger una matriz indefinidamente. Las contiendas decisivas de la industria (por el rendimiento, por el coste, por quién controla la pila) se libran a nivel del encapsulado. Ese es el nuevo campo de batalla, y lo será durante mucho tiempo.
La versión de una frase
Los transistores siguen importando, pero las ganancias vienen ahora de la integración: chiplets, interconexión die-a-die densa y memoria apilada empaquetados en un solo sistema, y por eso el empaquetado, no solo la litografía, decide qué pueden hacer los chips y cuánto cuestan.
Etiquetas

TPW Editorial
Redacción
El equipo editorial de TechPastWeek investiga y edita cada artículo que publicamos. Cada historia se contrasta con fuentes primarias y secundarias fiables, y un editor la revisa antes de publicarse.