Google ajoute un TPU confidentiel et un 8i Max à deux puces, son quatrième système cette année
Google a annoncé le 9 novembre le TPU 8tx pour l'inférence confidentielle et le TPU 8i Max à deux puces par boîtier, sans prix ni date de commercialisation.

Sur cette page
À retenir
- Google Cloud a annoncé le TPU 8tx, pour l'inférence confidentielle, et le TPU 8i Max, un boîtier à deux puces pour les contextes longs, le lundi 9 novembre 2026.
- Les deux sont des configurations système autour d'un silicium TPU de huitième génération existant ; Google affirme que 2026 est la première année où il a introduit quatre systèmes TPU.
- Le TPU 8tx utilise le même silicium que le TPU 8t avec des processeurs hôtes AMD EPYC de 5e génération, et Google revendique jusqu'à 2 fois moins de latence que le 8t avec une pénalité de performance quasi nulle.
- Le TPU 8i Max double le calcul, la SRAM et la bande passante HBM du TPU 8i en plaçant deux puces 8i dans un seul boîtier, dans l'encombrement d'armoire existant.
- Google n'a publié ni prix, ni date de disponibilité, ni spécifications absolues ; Bloomberg a rapporté, en citant Amin Vahdat, que les deux systèmes seront disponibles en 2027.
Google Cloud a ajouté deux systèmes à sa gamme de TPU de huitième génération le lundi 9 novembre : le TPU 8tx, conçu pour l'inférence confidentielle, et le TPU 8i Max, qui associe deux puces TPU 8i dans un seul boîtier pour les charges de travail à contexte long. Tous deux sont des configurations système construites autour d'un silicium que Google commercialise déjà. Aucun des deux n'est une puce nouvelle. L'entreprise affirme que 2026 est la première année où elle a introduit quatre systèmes TPU, après le TPU 8t et le TPU 8i lors de Google Cloud Next en avril.
À lire aussi: Le packaging avancé : le nouveau champ de bataille de l'industrie des semi-conducteurs · Le DSX POD de Nvidia transforme une usine d'IA en conteneur maritime.
Les deux systèmes répondent à des questions d'acheteurs différentes. L'une est de savoir si un client réglementé peut exécuter un modèle sur des données qu'il ne veut pas exposer. L'autre est de savoir si une charge de travail d'agent à court de bande passante mémoire peut en obtenir davantage dans la même armoire. Le billet de Google ne donne ni prix ni date de disponibilité pour l'un comme pour l'autre.
Amin Vahdat, directeur de la technologie et vice-président senior pour l'IA et les infrastructures chez Google, a rédigé le billet. Bloomberg a rapporté que les deux systèmes devraient être disponibles en 2027 et que Vahdat avait déclaré au média qu'ils le seraient cette année-là (Quartz). Le texte de Google ne s'engage sur aucune date.
Quatre systèmes, deux puces
La famille de huitième génération compte désormais quatre membres, et ils reposent sur deux pièces de silicium. Le TPU 8t traite l'entraînement à grande échelle, Google revendiquant jusqu'à 2,7 fois de meilleures performances d'entraînement que la génération précédente. Le TPU 8i traite le raisonnement à faible latence, avec une amélioration de 80 % du rapport performance-prix en inférence, toujours selon la mesure de Google. Le TPU 8tx reprend le silicium du 8t et y ajoute une protection matérielle des données en cours d'utilisation. Le TPU 8i Max place deux puces 8i dans un seul boîtier.
Une configuration système, c'est tout ce qui, dans une machine, n'est pas la puce : le boîtier, la carte, les processeurs hôtes, la fabrique réseau et le micrologiciel de sécurité. En changer peut modifier ce qu'un centre de données peut faire sans nouveau nœud de gravure, et Google affirme pouvoir désormais le faire en quelques mois plutôt qu'en années.
Deux puces pour quatre systèmes, c'est une cadence moins coûteuse que quatre cycles de conception. Le risque se situe dans ce qu'un billet de lancement ne peut pas montrer, à savoir si le logiciel traite les variantes comme une seule plateforme.
Le 8tx vend la confidentialité comme un produit
Le TPU 8tx est le troisième système de la génération et celui dont le déclencheur commercial est le plus clair. Il utilise le même silicium que le TPU 8t, associé à des processeurs hôtes AMD EPYC de 5e génération, et ajoute une isolation matérielle pour les données sensibles et les poids de modèle pendant leur utilisation active. Le chiffrement cloud ordinaire s'arrête à la frontière de la mémoire : les données sont déchiffrées pendant qu'un processeur les traite, et c'est cette fenêtre que l'informatique confidentielle referme.
Google destine le système aux entreprises réglementées et aux gouvernements qui exécutent des modèles de pointe ou propriétaires et des agents autonomes à côté de données sensibles. Les charges de travail citées sont le réglage fin sur données privées, la distillation d'un grand modèle vers un modèle plus petit et l'entraînement d'agents par apprentissage par renforcement. L'argument est que les trois peuvent se dérouler sur un seul système sans déplacer de données sensibles entre des clusters.
Le 8tx utilise aussi le réseau Boardfly à faible latence que Google a construit pour le raisonnement en temps réel, et l'entreprise revendique jusqu'à 2 fois moins de latence que le TPU 8t avec une pénalité de performance quasi nulle. La protection des données en cours d'utilisation coûte généralement quelque chose en débit ou en temps de réponse ; Google affirme que la facture est ici proche de zéro.
Aucun audit de sécurité ni aucune certification indépendante n'a été annoncé. L'isolation est décrite par Google et n'a pas été testée publiquement par un tiers, le type de preuve que les acheteurs réglementés demandent habituellement avant de placer des données sensibles sur un cloud partagé. Pour ces acheteurs, le 8tx reste un candidat.
Le 8i Max double le boîtier
Le TPU 8i Max est le quatrième système. Il combine deux puces TPU 8i à faible latence dans un seul boîtier, ce qui, selon Google, double la puissance de calcul, la SRAM et la bande passante HBM par rapport à un seul 8i. Comme il reprend l'encombrement d'armoire existant, l'entreprise présente le gain comme plus de puissance de calcul au mètre carré et au watt. La charge de travail visée est un agent qui parcourt toute une base de code ou plusieurs heures de vidéo d'un coup, là où la bande passante mémoire est la contrainte.
Chaque token qu'un modèle génère lit un cache qui grandit avec la fenêtre de contexte, si bien qu'une longue session passe son temps à déplacer de la mémoire plutôt qu'à faire de l'arithmétique. Deux puces dans un boîtier doublent la bande passante disponible pour ce cache, à condition que le logiciel sache adresser les deux puces comme un seul dispositif. Google n'a pas publié les détails qui permettraient de trancher.
Google n'a pas non plus publié de spécifications absolues, ce qui n'a pas empêché d'autres d'en produire. MarkTechPost a pris les chiffres publiés par puce du TPU 8i, 10,1 PFLOPS en FP4, 288 Go de HBM, 8 601 Go/s de bande passante et 384 Mo de SRAM, et les a multipliés par deux. Cela donne environ 20,2 PFLOPS, 17,2 To/s et 768 Mo de SRAM. Ce sont des calculs sur les chiffres de Google, pas une fiche technique de Google, et ils supposent que le boîtier passe à l'échelle de façon linéaire.
La mise à l'échelle linéaire est l'hypothèse à surveiller. Un boîtier à deux puces partage un substrat, une enveloppe de puissance et un budget de refroidissement, si bien que la seconde puce n'offre pas toujours un doublement net à l'échelle de l'armoire.
Pourquoi le packaging est devenu la feuille de route
L'année à quatre systèmes est une affirmation sur la cadence, et la cadence est l'élément du métier TPU que Google veut le plus opposer à Nvidia. L'argument de Google est que le packaging, la mémoire, le réseau et la sécurité peuvent être redécoupés autour du même silicium selon un cycle bien plus court. Ce levier est moins coûteux à actionner qu'un nouveau nœud de gravure, et il répond aux contraintes que rencontrent les acheteurs : bande passante par armoire, isolation et latence.
L'ensemble concurrent comprend la plateforme Rubin de Nvidia, la Maia 200 de Microsoft et Trainium3 d'AWS, entre autres. Nvidia reste le fournisseur dominant d'accélérateurs sur le marché, et rien dans l'annonce de lundi ne change cela. Les TPU de Google sont vendus via Google Cloud et, de plus en plus, déployés directement dans les centres de données de clients, selon le billet.
Google décrit les TPU comme « une activité en croissance rapide, avec près de 100 clients ». — Amin Vahdat, directeur de la technologie et vice-président senior de l'IA et des infrastructures, Google, 9 novembre 2026
Ce chiffre de clients n'est pas audité et ne s'accompagne d'aucune ventilation du chiffre d'affaires, si bien qu'il mesure l'étendue plutôt que l'échelle. Google cite parmi les utilisateurs des laboratoires de pointe, des sociétés de trading, des détaillants et des universités. Il ne dit pas quelle part de l'activité est externe, quelle part correspond à l'entraînement de ses propres modèles Gemini, ni combien ces clients paient par heure-puce.
Les fournisseurs de l'ensemble du marché des accélérateurs ajoutent de la mémoire et de la bande passante autour d'un silicium existant. Pour le versant chinois de cette course, voir notre enquête sur les projets d'entraînement préalable de DeepSeek sur Huawei Ascend.
La pile logicielle, nouveau lieu du coût de changement
Google a aussi annoncé des changements logiciels qui comptent davantage pour le coût total d'un acheteur que n'importe quelle spécification isolée. TorchTPU a été publié en open source le mois dernier, de sorte que le code PyTorch et les modèles Hugging Face tournent nativement sur les TPU, avec des backends TPU pour vLLM et SGLang. Une nouvelle suite d'agents TPU open source, en aperçu, se branche sur Claude Code, Cursor et Google Antigravity pour automatiser l'intégration, diagnostiquer les goulots d'étranglement et régler automatiquement les kernels en langage naturel.
Il y a aussi un nouveau XLA Serving Engine open source, qui permet aux équipes d'entraîner en Python et de servir dans un environnement d'exécution C++ à faible latence sur TPU, GPU et CPU. Agent Compute Engine suspend et reprend les sessions d'agents inactives pour réduire les dépenses d'infrastructure. TPU Sync, une couche open source d'état de modèle, hiérarchise les caches KV entre HBM, DRAM hôte, stockage partagé et réseau du centre de données, et Google affirme qu'elle réduit de plus de 90 % la latence de transfert KV et le temps jusqu'au premier token. Cloud Pathways, l'environnement d'exécution distribué derrière Gemini, est désormais disponible en général sur GKE, et le découpage dynamique de GKE l'est aussi, Google revendiquant un démarrage des tâches jusqu'à 5 fois plus rapide et une reprise après panne jusqu'à 4,5 fois plus rapide.
Google cite des performances-prix de pointe sur les benchmarks InferenceX et AgentX avec sa pile native vLLM-TorchTPU, avec de nouvelles évaluations de SemiAnalysis. Ce sont les benchmarks choisis par Google, exécutés sur la propre pile logicielle de Google. Ils prouvent que la pile n'est plus le maillon faible, pas qu'elle se compare à armes égales avec l'armoire d'un concurrent sur une charge de travail que ni l'une ni l'autre entreprise n'a choisie.
Le coût de changement s'est déplacé vers cette pile. Un rival peut égaler une spécification de puce sur une fiche technique. Égaler un compilateur, un ensemble de kernels optimisés, un moteur de service et une couche d'orchestration prend plus de temps, et c'est ce que Google construit. Les gains reviennent aux équipes qui travaillent dans la pile de Google ; une équipe qui utilise un autre framework, ou ses propres kernels, en obtient moins.
Ce que Google n'a pas dit
Le billet de Google est long sur l'architecture et court sur ce dont un acheteur a besoin pour signer un contrat. Il n'y a ni prix, ni date de disponibilité, ni liste de régions, ni type d'instance, ni fiche technique. La plupart des chiffres de performance sont des ratios face à des produits Google antérieurs, qui disent de combien le nouveau système devrait être meilleur que l'ancien et rien de sa comparaison avec une armoire Nvidia.
Les chiffres manquants
Les facteurs de 2 sur la latence, le calcul, la SRAM et la bande passante sont ceux de Google, mesurés face à ses propres composants antérieurs, et aucun n'a été vérifié indépendamment. Le résultat de TPU Sync, une réduction de plus de 90 % de la latence de transfert KV, a été mesuré sur Ironwood, la génération précédente, et non sur le 8tx ou le 8i Max. Aucun tiers n'a publié de benchmark ni d'audit de sécurité pour l'un ou l'autre des nouveaux systèmes.
La date de 2027 vient de Bloomberg et non de Google. Vahdat a déclaré au média que les systèmes seraient disponibles cette année-là, et le billet de l'entreprise ne reprend pas cet engagement (Gizmodo). Les acheteurs qui planifient leur capacité pour l'an prochain devront traiter cette date comme une information rapportée.
L'informatique confidentielle présente un manque comparable. Google affirme que le 8tx protège les données en cours d'utilisation au niveau matériel, et aucun organisme de certification ne l'a confirmé. La fonction est une exigence d'achat dans la finance, la santé et le secteur public, et ces acheteurs demandent généralement un rapport d'attestation plutôt qu'un schéma d'architecture.
Un prix par heure-puce, et la question de savoir si le 8i Max est vendu comme une armoire entière ou comme une fraction d'armoire, transformeraient une promesse de capacité en donnée budgétaire. Un client nommé faisant tourner le 8i Max en production, facture avant et après à l'appui, pèserait plus qu'un graphique de benchmark. Un test indépendant face à Rubin ou Trainium3 sur le même modèle trancherait la comparaison que Google évite, et une certification tierce déciderait si les acheteurs réglementés peuvent utiliser le 8tx.
Tant qu'aucun de ces éléments n'arrive, les deux systèmes existent à l'état de spécifications et de démonstrations. Google a quatre systèmes TPU pour 2026 et aucune date de livraison de son propre chef pour les deux plus récents.
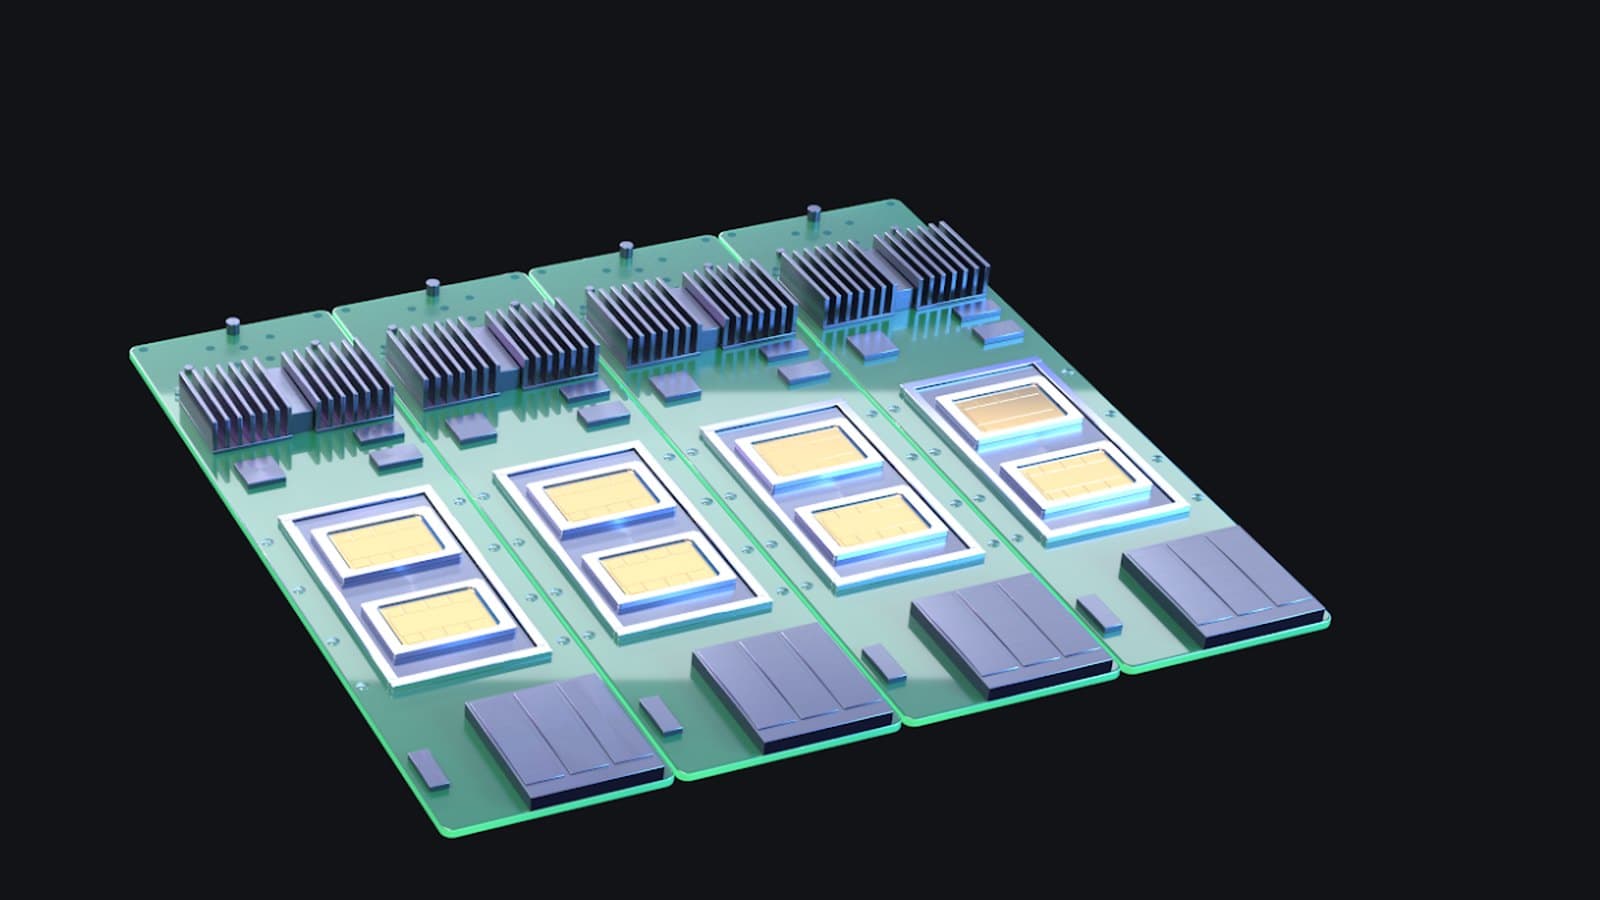
Image de couverture : rendu officiel de Google des cartes TPU 8tx et TPU 8i Max.
Étiquettes
Questions fréquentes
- Qu'est-ce que le TPU 8tx de Google ?
- Le TPU 8tx est un système Google Cloud pour l'inférence sécurisée et confidentielle. Il utilise le même silicium que le TPU 8t, l'associe à des processeurs hôtes AMD EPYC de 5e génération et ajoute une protection matérielle qui maintient les données et les poids de modèle isolés pendant leur utilisation. Google le destine aux entreprises réglementées et aux gouvernements qui exécutent des modèles et des agents propriétaires à côté de données sensibles.
- Qu'est-ce que le TPU 8i Max ?
- Le TPU 8i Max est un boîtier contenant deux puces TPU 8i à faible latence. Google affirme qu'il double le calcul, la SRAM et la bande passante HBM par rapport à une seule puce 8i et qu'il fait tenir deux fois plus de silicium dans le même encombrement d'armoire, à destination des agents qui travaillent sur toute une base de code ou plusieurs heures de vidéo.
- Quand les TPU 8tx et 8i Max seront-ils disponibles ?
- L'annonce de Google ne donne aucune date de disponibilité. Bloomberg a rapporté que les deux systèmes sont attendus en 2027, et Amin Vahdat, directeur de la technologie de Google pour l'IA et les infrastructures, a déclaré au média qu'ils seraient disponibles cette année-là. C'est une information de Bloomberg, pas un engagement du billet de blog de Google.
- Les chiffres de performance des nouveaux TPU sont-ils officiels ?
- Les ratios de performance publiés par Google sont ses propres affirmations et n'ont pas été vérifiés indépendamment pour ces systèmes. Les chiffres absolus qui circulent pour le TPU 8i Max, environ 20,2 PFLOPS en FP4 et 17,2 To/s de bande passante, ont été calculés par MarkTechPost en doublant les chiffres publiés par puce du TPU 8i, et ne sont pas des spécifications de Google.

TPW Editorial
Rédaction
L'équipe éditoriale de TechPastWeek enquête et édite chaque article publié. Chaque sujet est recoupé avec des sources primaires et secondaires fiables, et un éditeur le relit avant publication.