Google ergänzt einen vertraulichen TPU und einen Doppelchip-8i Max, das vierte System in diesem Jahr
Google hat am 9. November TPU 8tx für vertrauliche Inferenz und TPU 8i Max mit zwei Chips pro Paket vorgestellt. Preis und Lieferdatum fehlen weiterhin.

Auf dieser Seite
Die wichtigsten Punkte
- Google Cloud hat am Montag, 9. November 2026, TPU 8tx für vertrauliche Inferenz und TPU 8i Max vorgestellt, ein Paket mit zwei Chips für lange Kontexte.
- Beide sind Systemkonfigurationen um vorhandenes Silizium der achten TPU-Generation; Google sagt, 2026 sei das erste Jahr mit vier eingeführten TPU-Systemen.
- TPU 8tx nutzt dasselbe Silizium wie TPU 8t mit Host-Prozessoren der fünften Generation AMD EPYC, und Google beansprucht bis zu 2-mal niedrigere Latenz als 8t bei nahezu keinem Leistungsverlust.
- TPU 8i Max verdoppelt Rechenleistung, SRAM und HBM-Bandbreite von TPU 8i, indem zwei 8i-Chips in der bestehenden Rack-Fläche auf einem Paket sitzen.
- Google veröffentlichte weder Preis noch Verfügbarkeitsdatum noch absolute Spezifikationen; Bloomberg berichtete unter Berufung auf Amin Vahdat, beide Systeme kämen 2027.
Google Cloud hat am Montag, 9. November, zwei Systeme zur achten TPU-Generation hinzugefügt: TPU 8tx, gebaut für vertrauliche Inferenz, und TPU 8i Max, das zwei TPU-8i-Chips auf einem Paket für Long-Context-Arbeit kombiniert. Beide sind Systemkonfigurationen, die um Silizium herum gebaut sind, das Google bereits verkauft. Keines ist ein neuer Chip. Das Unternehmen sagt, 2026 sei das erste Jahr, in dem es vier TPU-Systeme eingeführt hat, nach TPU 8t und TPU 8i auf dem Google Cloud Next im April.
Zum Weiterlesen: Advanced Packaging: Das neue Schlachtfeld der Halbleiterindustrie · Nvidias DSX POD macht aus einer KI-Fabrik einen Frachtcontainer.
Die beiden Systeme beantworten unterschiedliche Käuferfragen. Die eine lautet, ob ein regulierter Kunde ein Modell auf Daten laufen lassen kann, die er nicht offenlegen will. Die andere, ob eine Agenten-Workload, die an Speicherbandbreite anstößt, innerhalb desselben Racks mehr davon bekommen kann. Googles Beitrag nennt weder Preis noch Verfügbarkeitsdatum.
Amin Vahdat, Googles Cheftechnologe und Senior Vice President für KI und Infrastruktur, schrieb den Beitrag. Bloomberg berichtete, beide Systeme würden voraussichtlich 2027 verfügbar, und Vahdat habe der Nachrichtenagentur gesagt, sie würden in jenem Jahr verfügbar sein (Quartz). Googles eigener Text legt sich auf kein Datum fest.
Vier Systeme, zwei Dies
Die Familie der achten Generation hat jetzt vier Mitglieder, und sie ruht auf zwei Stücken Silizium. TPU 8t übernimmt Scale-up-Training, wobei Google bis zu 2,7-mal bessere Trainingsleistung als bei der Vorgängergeneration beansprucht. TPU 8i übernimmt latenzarmes Reasoning, mit 80% Verbesserung bei der Preis-Leistung der Inferenz, ebenfalls nach Googles Maßstab. TPU 8tx nimmt das 8t-Silizium und ergänzt Hardwareschutz für Daten in Verwendung. TPU 8i Max packt zwei 8i-Chips in ein Paket.
Eine Systemkonfiguration ist alles in einer Maschine, was nicht der Die ist: das Paket, die Platine, die Host-Prozessoren, das Netzwerk-Fabric und die Sicherheits-Firmware. Daran zu drehen kann verändern, was ein Rechenzentrum leisten kann, ohne neuen Fertigungsprozess; Google sagt, das gelinge jetzt in Monaten statt Jahren.
Zwei Dies für vier Systeme sind ein günstigerer Takt als vier Designzyklen. Das Risiko liegt in dem, was ein Launch-Beitrag nicht zeigen kann: ob die Software die Varianten als eine Plattform behandelt.
Der 8tx verkauft Vertraulichkeit als Produkt
TPU 8tx ist das dritte System der Generation und das mit dem klarsten kommerziellen Auslöser. Er nutzt dasselbe Silizium wie TPU 8t, kombiniert mit Host-Prozessoren der fünften Generation AMD EPYC, und ergänzt Isolation auf Hardwareebene für sensible Daten und Modellgewichte, während sie aktiv genutzt werden. Gewöhnliche Cloud-Verschlüsselung endet an der Speichergrenze: Daten werden entschlüsselt, während ein Prozessor sie verarbeitet, und genau dieses Fenster schließt Confidential Computing.
Google positioniert das System für regulierte Unternehmen und Regierungen, die Frontier- oder proprietäre Modelle und autonome Agenten neben sensiblen Daten betreiben. Als Workloads nennt es Feintuning auf privaten Daten, die Destillation eines großen Modells in ein kleineres und das Training von Agenten per Reinforcement Learning. Das Versprechen: Alle drei laufen auf einem System, ohne sensible Daten zwischen Clustern zu verschieben.
Der 8tx nutzt zudem das latenzarme Boardfly-Netzwerk, das Google für Echtzeit-Reasoning gebaut hat, und das Unternehmen beansprucht bis zu 2-mal niedrigere Latenz als TPU 8t bei nahezu keinem Leistungsverlust. Schutz während der Verwendung kostet üblicherweise Durchsatz oder Antwortzeit; Google sagt, die Rechnung sei hier nahe null.
Ein unabhängiges Sicherheitsaudit oder eine Zertifizierung wurde nicht angekündigt. Die Isolation ist von Google beschrieben und nicht öffentlich von Dritten getestet, also genau die Art Beleg, die regulierte Käufer üblicherweise verlangen, bevor sie sensible Daten in eine geteilte Cloud geben. Für diese Käufer bleibt der 8tx ein Kandidat.
Der 8i Max verdoppelt das Paket
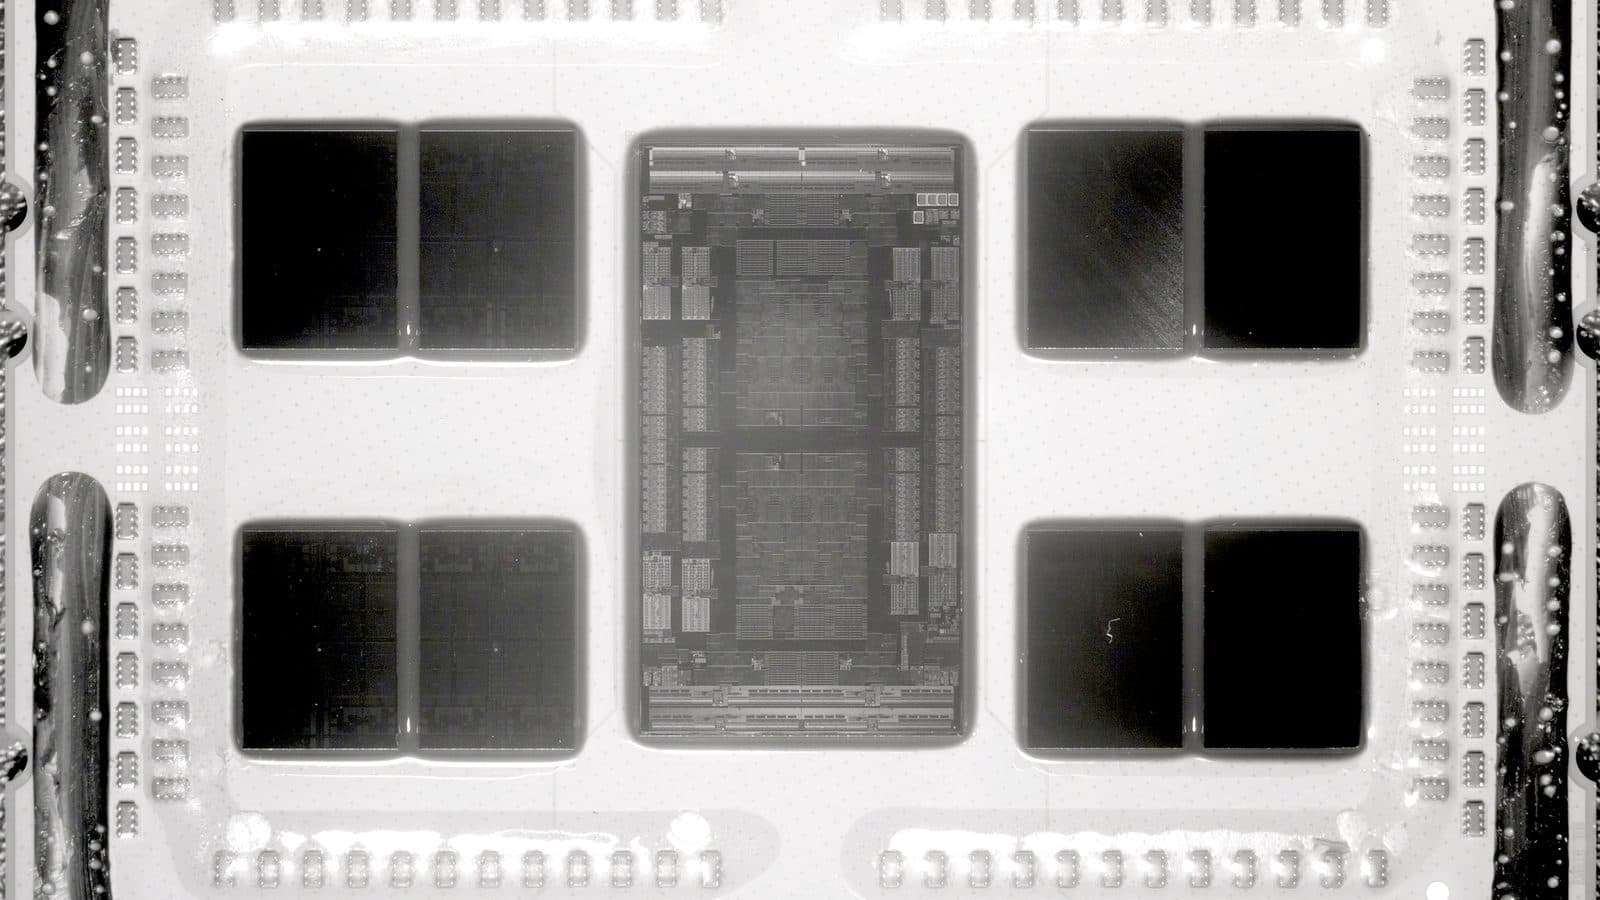
TPU 8i Max ist das vierte System. Es kombiniert zwei latenzarme TPU-8i-Chips auf einem Paket, was laut Google Rechenleistung, SRAM und HBM-Bandbreite gegenüber einem einzelnen 8i verdoppelt. Da es die bestehende Rack-Fläche nutzt, beschreibt das Unternehmen den Gewinn als mehr Rechenleistung pro Quadratfuß und pro Watt. Die Ziel-Workload ist ein Agent, der über eine ganze Codebasis oder stundenlanges Video auf einmal arbeitet, wo Speicherbandbreite die Beschränkung ist.
Jedes Token, das ein Modell erzeugt, liest einen Cache, der mit dem Kontextfenster wächst; eine lange Sitzung verbringt ihre Zeit also mit Speicherbewegung statt mit Rechenarbeit. Zwei Chips auf einem Paket verdoppeln die Bandbreite für diesen Cache, sofern die Software beide Dies als ein Gerät adressieren kann. Google hat die Details nicht veröffentlicht, die das klären würden.
Google veröffentlichte auch keine absoluten Spezifikationen, was andere nicht davon abhielt, welche zu produzieren. MarkTechPost nahm die veröffentlichten Werte pro TPU-8i-Chip, 10,1 PFLOPS bei FP4, 288 GB HBM, 8.601 GB/s Bandbreite und 384 MB SRAM, und verdoppelte sie. Das ergibt rund 20,2 PFLOPS, 17,2 TB/s und 768 MB SRAM. Das ist Arithmetik auf Googles Zahlen, kein Google-Datenblatt, und setzt lineare Skalierung des Pakets voraus.
Lineare Skalierung ist die Annahme, die man beobachten sollte. Ein Doppelchip-Paket teilt sich ein Substrat, ein Leistungsbudget und ein Kühlbudget, der zweite Die liefert also nicht immer eine saubere Verdopplung auf Rack-Ebene.
Warum Packaging zur Roadmap wurde
Das Vier-Systeme-Jahr ist eine Aussage über den Takt, und der Takt ist der Teil des TPU-Geschäfts, den Google am stärksten gegen Nvidia abheben will. Googles Argument: Packaging, Speicher, Netzwerk und Sicherheit lassen sich in viel kürzerem Zyklus um dasselbe Silizium herum neu zuschneiden. Dieser Hebel ist billiger zu ziehen als ein neuer Fertigungsprozess und adressiert die Beschränkungen, auf die Käufer stoßen: Bandbreite pro Rack, Isolation und Latenz.
Zum Wettbewerbsumfeld gehören unter anderem Nvidias Rubin-Plattform, Microsofts Maia 200 und AWS Trainium3. Nvidia bleibt der dominierende Merchant-Anbieter von Beschleunigern, und nichts an der Ankündigung vom Montag ändert das. Googles TPUs werden über Google Cloud verkauft und laut Blog zunehmend direkt in Rechenzentren von Kunden eingesetzt.
Google beschreibt TPUs als „ein schnell wachsendes Geschäft mit fast 100 Kunden“. — Amin Vahdat, Cheftechnologe und SVP für KI und Infrastruktur, Google, 9. November 2026
Diese Kundenzahl ist ungeprüft und kommt ohne Umsatzaufteilung; sie misst also Breite, nicht Größe. Google nennt Frontier-Labore, Handelsfirmen, Einzelhändler und Universitäten unter den Nutzern. Das Unternehmen sagt nicht, wie viel des Geschäfts extern ist, wie viel Googles eigenes Gemini-Training ausmacht oder was diese Kunden pro Chip-Stunde zahlen.
Anbieter im gesamten Beschleunigermarkt ergänzen Speicher und Bandbreite um bestehendes Silizium. Für die chinesische Seite dieses Rennens siehe unseren Bericht zu DeepSeeks Huawei-Ascend-Pretraining-Plänen.
Der Software-Stack ist der neue Wechselkostenfaktor
Google kündigte außerdem Softwareänderungen an, die für die Gesamtkosten eines Käufers wichtiger sind als jede einzelne Spezifikation. TorchTPU wurde im vergangenen Monat als Open Source veröffentlicht, sodass PyTorch-Code und Hugging-Face-Modelle nativ auf TPUs laufen, mit TPU-Backends für vLLM und SGLang. Eine neue Open-Source-Agentensuite für TPU, in der Vorschau, verbindet sich mit Claude Code, Cursor und Google Antigravity, um das Onboarding zu automatisieren, Engpässe zu diagnostizieren und Kernel in einfacher Sprache automatisch zu optimieren.
Es gibt außerdem eine neue Open-Source-XLA-Serving-Engine, mit der Teams in Python trainieren und in einer latenzarmen C++-Laufzeit über TPUs, GPUs und CPUs ausliefern können. Die Agent Compute Engine setzt inaktive Agentensitzungen aus und nimmt sie wieder auf, um Infrastrukturkosten zu senken. TPU Sync, eine Open-Source-Schicht für den Modellzustand, verteilt KV-Caches stufenweise auf HBM, Host-DRAM, gemeinsamen Speicher und das Rechenzentrumsnetz, und Google sagt, das senke die KV-Übertragungslatenz und die Zeit bis zum ersten Token um mehr als 90%. Cloud Pathways, die verteilte Laufzeit hinter Gemini, ist jetzt allgemein auf GKE verfügbar, und GKE Dynamic Slicing ist allgemein verfügbar, wobei Google bis zu 5-mal schnelleren Job-Start und bis zu 4,5-mal schnellere Fehlerbehebung beansprucht.
Google verweist auf Spitzenwerte bei der Preis-Leistung in den Benchmarks InferenceX und AgentX mit seinem nativen vLLM-TorchTPU-Stack, mit neuen Auswertungen von SemiAnalysis. Das sind Googles ausgewählte Benchmarks, ausgeführt auf Googles eigenem Software-Stack. Sie belegen, dass der Stack nicht mehr das schwache Glied ist, keinen direkten Vergleich mit dem Rack eines Wettbewerbers bei einer Workload, die keines der beiden Unternehmen ausgewählt hat.
Die Wechselkosten sind in diesen Stack gewandert. Ein Rivale kann bei einer Chipspezifikation auf dem Datenblatt mithalten. Einen Compiler, eine Reihe abgestimmter Kernel, eine Serving-Engine und eine Orchestrierungsschicht nachzuziehen dauert länger, und genau das baut Google. Die Gewinne fallen Teams innerhalb von Googles Stack zu; ein Team mit einem anderen Framework oder eigenen Kernels bekommt weniger von der Verbesserung.
Was Google nicht sagte
Googles Beitrag ist lang in der Architektur und kurz in dem, was ein Käufer zum Vertragsabschluss braucht. Es gibt keinen Preis, kein Verfügbarkeitsdatum, keine Regionsliste, keinen Instanztyp und kein Datenblatt. Die meisten Leistungszahlen sind Verhältnisse zu früheren Google-Produkten; sie sagen, wie viel besser das neue System gegenüber dem alten sein soll, und nichts darüber, wie es gegen ein Nvidia-Rack abschneidet.
Die fehlenden Zahlen
Die Angaben 2-mal Latenz, 2-mal Rechenleistung, 2-mal SRAM und 2-mal Bandbreite stammen von Google, gemessen gegen eigene frühere Teile, und keine wurde unabhängig bestätigt. Das TPU-Sync-Ergebnis, eine Senkung der KV-Übertragungslatenz um mehr als 90%, wurde auf Ironwood gemessen, der vorherigen Generation, nicht auf 8tx oder 8i Max. Kein Dritter hat einen Benchmark oder ein Sicherheitsaudit für eines der neuen Systeme veröffentlicht.
Das Datum 2027 stammt von Bloomberg, nicht von Google. Vahdat sagte der Nachrichtenagentur, die Systeme würden in jenem Jahr verfügbar sein, und der Beitrag des Unternehmens wiederholt die Zusage nicht (Gizmodo). Käufer, die Kapazität für das nächste Jahr planen, müssen das Datum als Bericht behandeln.
Confidential Computing hat eine ähnliche Lücke. Google sagt, der 8tx schütze Daten in Verwendung auf der Hardwareebene, und keine Zertifizierungsstelle hat das bestätigt. Die Funktion ist eine Beschaffungsanforderung in Finanzen, Gesundheitswesen und öffentlichem Sektor, und diese Käufer verlangen tendenziell einen Attestierungsbericht statt eines Architekturdiagramms.
Ein Preis pro Chip-Stunde und die Frage, ob 8i Max als ganzes Rack oder als Teil eines Racks verkauft wird, würden aus einer Fähigkeitsbehauptung einen Budgetposten machen. Ein namentlich genannter Kunde, der 8i Max produktiv betreibt, mit der Rechnung davor und danach, hätte mehr Gewicht als ein Benchmark-Diagramm. Ein unabhängiger Test gegen Rubin oder Trainium3 mit demselben Modell würde den Vergleich entscheiden, den Google vermeidet, und eine Zertifizierung durch Dritte würde entscheiden, ob regulierte Käufer den 8tx überhaupt nutzen können.
Bis eines davon vorliegt, existieren die beiden Systeme als Spezifikationen und Demonstrationen. Google hat vier TPU-Systeme für 2026 und kein eigenes Lieferdatum für die beiden neuesten.
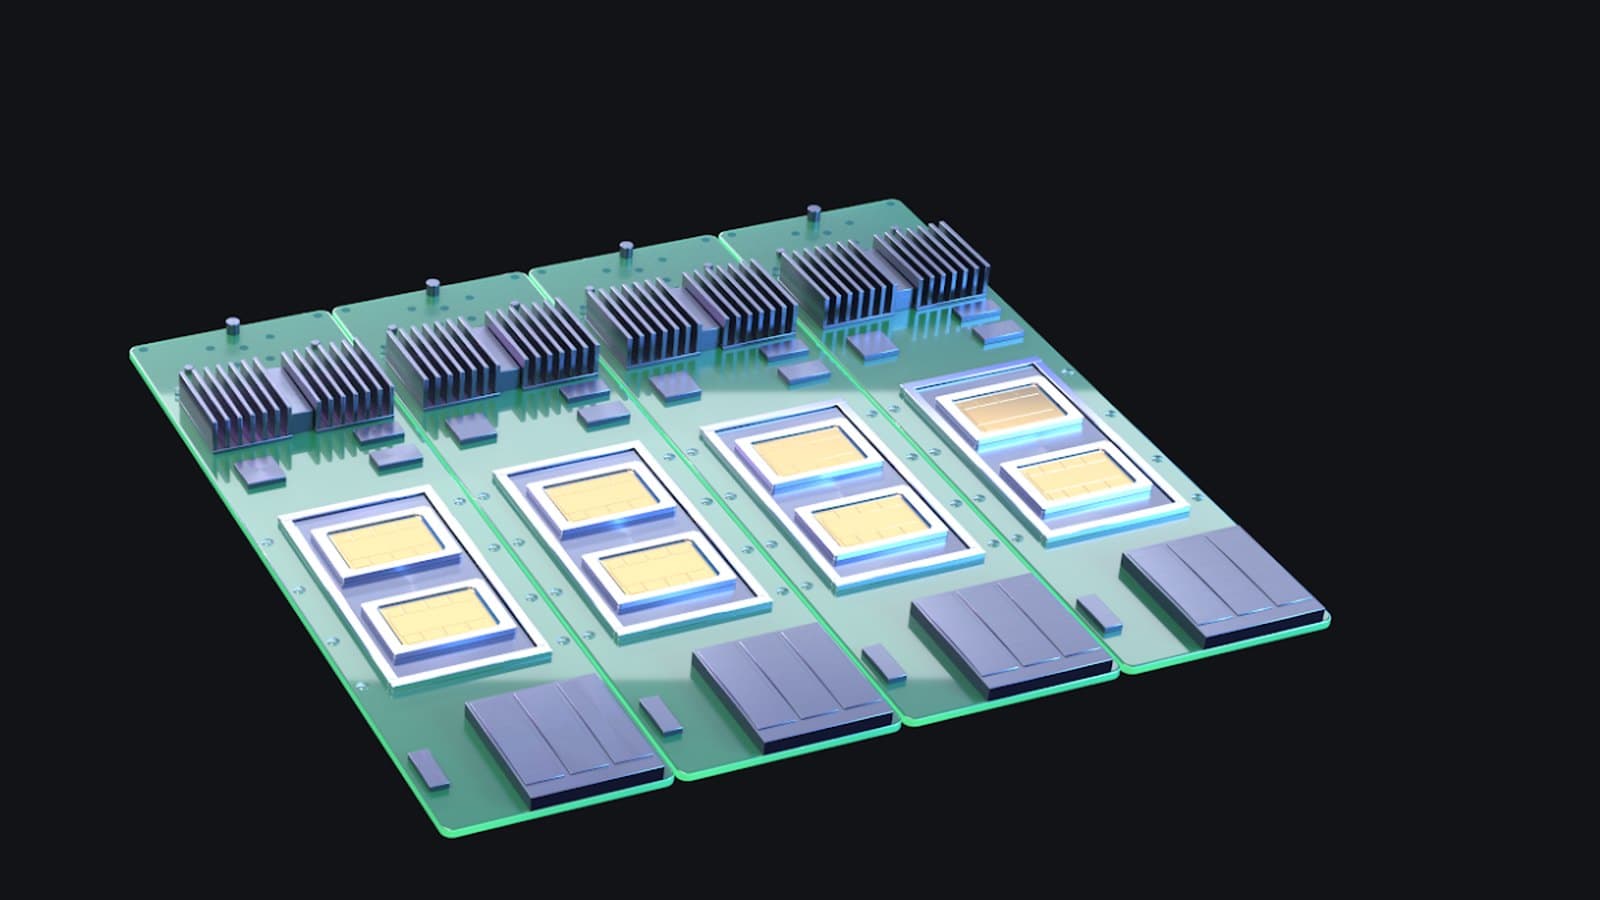
Titelbild: Googles offizieller Render der Platinen TPU 8tx und TPU 8i Max.
Tags
Häufige Fragen
- Was ist Google TPU 8tx?
- TPU 8tx ist ein Google-Cloud-System für sichere und vertrauliche Inferenz. Es nutzt dasselbe Silizium wie TPU 8t, kombiniert es mit Host-Prozessoren der fünften Generation AMD EPYC und ergänzt Schutz auf Hardwareebene, der Daten und Modellgewichte isoliert, während sie verwendet werden. Google positioniert es für regulierte Unternehmen und Regierungen, die proprietäre Modelle und Agenten neben sensiblen Daten betreiben.
- Was ist TPU 8i Max?
- TPU 8i Max ist ein Paket mit zwei latenzarmen TPU-8i-Chips. Google sagt, es verdoppele Rechenleistung, SRAM und HBM-Bandbreite gegenüber einem einzelnen 8i-Chip und bringe doppelt so viel Silizium in derselben Rack-Fläche unter, gedacht für Agenten, die über eine ganze Codebasis oder stundenlanges Video arbeiten.
- Wann sind TPU 8tx und TPU 8i Max verfügbar?
- Googles Ankündigung nennt kein Verfügbarkeitsdatum. Bloomberg berichtete, beide Systeme würden 2027 erwartet, und Amin Vahdat, Googles Cheftechnologe für KI und Infrastruktur, habe der Nachrichtenagentur gesagt, sie würden in jenem Jahr verfügbar sein. Das ist Bloombergs Berichterstattung, keine Zusage in Googles Blogbeitrag.
- Sind die Leistungszahlen der neuen TPUs offiziell?
- Die von Google veröffentlichten Leistungsverhältnisse sind eigene Angaben und für diese Systeme nicht unabhängig geprüft. Die kursierenden absoluten Werte für TPU 8i Max, rund 20,2 PFLOPS bei FP4 und 17,2 TB/s Bandbreite, hat MarkTechPost durch Verdopplung der veröffentlichten TPU-8i-Werte pro Chip berechnet; es sind keine Google-Spezifikationen.

TPW Editorial
Redaktion
Die Redaktion von TechPastWeek recherchiert und betreut jeden veröffentlichten Artikel. Jede Geschichte wird anhand von Primär- und glaubwürdigen Sekundärquellen geprüft und vor der Veröffentlichung redaktionell freigegeben.