Advanced Packaging: Das neue Schlachtfeld der Halbleiterindustrie
Kleinere Transistoren bringen kaum noch Gewinne. Wie Advanced Packaging – Chiplets, 2,5D/3D-Stapelung, HBM – zum Schlachtfeld der Chipindustrie wurde.

Auf dieser Seite
Ein halbes Jahrhundert lang lief die Halbleiterindustrie auf einem einzigen Geschäft: Machen wir den Transistor kleiner, wird alles schneller, dichter und billiger. Dieser Handel ist zerbrochen. Die physikalische Arbeit, Transistoren zu verkleinern, geht weiter, doch der wirtschaftliche Ertrag ist so weit geschrumpft, dass die größten Leistungsgewinne zunehmend von ganz woanders kommen – davon, wie Chips zusammengebaut werden, nicht davon, wie ihre Transistoren gezeichnet werden.
Zum Weiterlesen: Samsung eröffnet Verpackungslabor in Yokohama, um seine HBM-Lücke zu schließen · Microns Umsatz steigt fast auf das Fünffache auf einen Rekord von 54,23 Milliarden Dollar dank KI-Speichernachfrage.
Advanced Packaging, einst das unglamouröse Backend der Chipfertigung, ist zum eigentlichen Schlachtfeld der Branche geworden. Hier entscheiden sich heute Speicherbandbreite, Systemleistung, Fertigungsausbeute und Kosten pro Rechenleistung. Das ist ein dauerhafter Wandel, kein vorübergehender, und wer ihn versteht, versteht auch, warum der alte Hebel nicht mehr wirkt.
Warum Skalierung allein nicht mehr reichte
Moores Gesetz war nie nur eine technologische Vorhersage. Es war ein wirtschaftlicher Motor. Weil sich die Transistordichte etwa alle zwei Jahre verdoppelte, während die Waferverarbeitungskosten pro Flächeneinheit nahezu konstant blieben, sanken die Kosten für die Herstellung eines Transistors stetig – historisch um durchschnittlich 20 bis 30 Prozent pro Jahr. Dieser Rückgang machte Computing billig genug, um in alles hineinzukommen.
Der Motor ist ins Stocken geraten. Arbeiten von Zvi Or-Bach bei MonolithIC 3D, später bestätigt von Milind Shah bei Google, deuteten darauf hin, dass die Kosten pro Transistor ab dem 28-nm-Knoten nicht mehr fielen und seither flach bis leicht steigend sind. An der Leading Edge beschreiben Analysen der Ökonomie fortgeschrittener Knoten inzwischen eher eine Umkehrung: 2-nm-Wafer wurden mit rund 30.000 US-Dollar berichtet, etwa 50 Prozent mehr als 3-nm-Wafer, bei Fabkosten an der Spitze von 15–20 Milliarden Dollar oder mehr.
Drei Zwänge verstärken sich gegenseitig:
- Das Retikel-Limit. Lithografieanlagen können in einem Durchgang nur eine begrenzte Fläche belichten. In der Praxis begrenzt das einen monolithischen Die auf rund 800 mm² – eine harte Obergrenze dafür, wie viel Rechenleistung auf einem Stück Silizium sitzen kann.
- Die Ausbeuteökonomie. Große Dies fangen exponentiell wahrscheinlicher einen tödlichen Defekt ein, ein größerer Die bedeutet also einen kleineren Anteil guter Teile pro Wafer.
- Das Falscher-Knoten-Problem. Nicht jede Funktion braucht den teuersten Transistor. Analog, HF, I/O und SRAM profitieren oft kaum oder gar nicht von der Leading Edge, werden aber mitgeschleppt, wenn sie sich einen Die mit der Logik teilen, die es tut.
„Es könnte sich als wirtschaftlicher erweisen, große Systeme aus kleineren Funktionen aufzubauen, die getrennt verpackt und miteinander verbunden werden.“ — Gordon Moore, 1965
Moore selbst hat die Antwort Jahrzehnte zuvor vorweggenommen. Die Branche hat die dazwischenliegenden Jahre damit verbracht, diese Beobachtung in eine Fertigungsdisziplin zu verwandeln.
Was Advanced Packaging tatsächlich ist
Advanced Packaging ist die Gesamtheit der Techniken, um mehrere Dies – und manchmal weitere Komponenten wie Speicherstapel, passive Bauelemente oder optische Engines – in ein einziges Package zu integrieren, verbunden durch weit dichtere Verdrahtung, als eine konventionelle Leiterplatte je bieten könnte. Die alte Sicht behandelte das Package als schützendes Gehäuse. Die neue Sicht behandelt es als das System.
Die Familie reicht von „2D“ (Dies nebeneinander auf einem Substrat) über „2,5D“ (Dies auf einem gemeinsamen Interposer oder einer Brückenschicht) bis „3D“ (Dies vertikal gestapelt und durch Silizium verbunden) – mit feineren Abstufungen dazwischen, die Ingenieure je nachdem, welche Schichten die hochdichte Verdrahtung tragen, als 2,3D, 3,3D und 3,5D bezeichnen.
        ┌─────────────────────────────────────────────┐
        │              System board (PCB)              │
        └─────────────────────────────────────────────┘
                   │  package-to-board solder balls
        ┌─────────────────────────────────────────────┐
        │              Package substrate               │
        │      (organic / glass-core / RDL-based)      │
        └─────────────────────────────────────────────┘
             │  C4 bumps · microbumps · hybrid bond
        ┌────────────┬───────────────┬────────────────┐
        │  HBM stack │  Compute die  │   I/O chiplet  │
        │ (DRAM × N) │    (logic)    │                │
        └────────────┴───────────────┴────────────────┘
              └──── interposer / bridges (2.5D) ────┘
Je höher man in diesem Stapel geht, desto kürzer die Drähte, desto geringer die Energie pro Bit und desto schwieriger die Fertigung. Nahezu jeder Kompromiss im Advanced Packaging ist eine Variante davon.
Der Werkzeugkasten
Interposer und Brücken: das 2,5D-Arbeitspferd
Die dominierende Architektur für Hochleistungs-Computing platziert Logik-Dies und Speicher nebeneinander auf einem gemeinsamen Silizium-Interposer – einem Stück Silizium, dessen einzige Aufgabe es ist, dichte Verbindungen zwischen ihnen zu routen. TSMCs CoWoS (Chip-on-Wafer-on-Substrate) ist das kanonische Beispiel. Die Silizium-Interposer-Variante unterstützt Flächen bis zum 3,3-Fachen des Retikels (rund 2.700 mm²); neuere RDL- und brückenbasierte Varianten tauschen etwas Dichte gegen Kosten, Flexibilität und die Möglichkeit ein, noch größer zu skalieren. Statt alles durch einen riesigen Interposer zu routen, betten manche Designs kleine „Brücken“-Chips oder lokale Silizium-Interconnects nur dort ein, wo Bandbreite gebraucht wird – ein kostenbewusster Mittelweg.
HBM: Speicher als Stapelproblem
High-Bandwidth Memory ist selbst ein Advanced-Packaging-Produkt: ein Stapel von DRAM-Dies, die durch Through-Silicon-Vias verbunden sind und neben einem Logik-Die sitzen. KI-Beschleuniger stehen und fallen damit, wie schnell sie ihre Recheneinheiten versorgen können, was HBM zu einer der strategisch wichtigsten Komponenten der Branche gemacht hat.
HBM höher zu stapeln stößt an Physik und Ökonomie. Aktuelle HBM-Teile stapeln 8–12 Dies; der Weg in Richtung 20 oder mehr bedeutet, dass die winzigen Löt-Mikrobumps zwischen den Schichten zu viel Höhe verbrauchen und den Wärmewiderstand erhöhen, wie IEEE Spectrum dokumentiert hat. Der Migrationspfad führt zu Hybrid Bonding und dünneren Dies sowie zu breiteren Schnittstellen – die HBM-Generationen sind von rund 1.024 Verbindungen auf etwa 2.048 gewachsen, laut Branchenpräsentationen zum Hybrid Bonding.
Hybrid Bonding: wirklich in die Vertikale
Hybrid Bonding verbindet zwei Dies mit direkten Kupfer-zu-Kupfer-Verbindungen, ohne Lot. Dadurch kann der Abstand zwischen den Verbindungen dramatisch schrumpfen: Dichten von 10.000 bis einer Million Verbindungen pro Quadratmillimeter, bei einer Energie unter 0,05 Pikojoule pro Bit, gegenüber weniger als tausend pro mm² bei Löt-Mikrobumps. Der Gewinn sind kürzere Wege, weniger Leistung und die Möglichkeit, Cache oder Speicher direkt auf die Logik zu setzen. Die Kosten sind eine anspruchsvolle Prozesskontrolle, Oberflächenvorbereitung, Partikel-Empfindlichkeit und Ausrichtungsgenauigkeit – weshalb getestete Dies typischerweise Die-zu-Wafer statt Wafer-zu-Wafer gebondet werden.
UCIe: Chiplets zum Plug-and-Play machen
Damit Chiplet-Architekturen ihr Versprechen der Wiederverwendung einlösen, muss ein Die von einem Anbieter mit einem Die von einem anderen sprechen. UCIe ist der offene Standard, der das möglich machen soll, und definiert eine Die-zu-Die-Physikschicht, eine Link-Schicht und einen Protokollstapel, der auf PCI Express und Compute Express Link abbildet. Die Spezifikation umspannt bewusst zwei Packaging-Klassen – ein kostengünstiges Standard-Package für 2D-Integration und Advanced Packages für energieeffiziente 2,5D und 3D –, damit ein einziges Schnittstellendesign über Produkte hinweg wiederverwendet werden kann. Spätere Revisionen ergänzen Test, Debug und Manageability für Multi-Chiplet-Systeme sowie höhere Link-Raten.
Panel-Level-Packaging: der Jagd nach Skalierung
Advanced Packaging wird derzeit meist auf runden 300-mm-Wafern gefertigt, doch die Kosten für großflächiges Fan-out treiben die Branche zu quadratischen Panels, die weniger Material verschwenden und pro Schritt mehr Fläche verarbeiten. Yole Group erwartet, dass Panel-Level-Packaging bis 2031 mit mehr als 40 Prozent pro Jahr wächst, angetrieben von Fan-out und 2,5D-Integration für KI und HPC. Panel-Level-Prozesse sind ein führender Kandidat, um große Interposer mit ihrem Wachstum bezahlbar zu halten.
Die Akteure und eine neue Arbeitsteilung
Advanced Packaging zeichnet die Halbleiterlieferkette neu, weil es zwischen Frontend-Waferfertigung und klassischer Montage sitzt.
- Foundries. TSMC, Intel und Samsung haben Packaging zu einem Teil ihrer Plattformangebote gemacht und bündeln es mit Leading-Edge-Logik, sodass Kunden ein validiertes Compute-plus-Memory-plus-Interconnect-Modul erhalten. Das ist eine bedeutende Hebelwirkung: Leading-Edge-Logik und das Packaging, das sie nutzbar macht, kommen zunehmend als ein Paket.
- OSATs und Ausrüster. Auftragsfertiger für Montage und Test und die Unternehmen, die ihre Werkzeuge liefern – Thermokompressions-Bonder, Hybrid-Bonding-Systeme, Messtechnik und Panel-Handling-Anlagen –, besitzen einen Großteil des praktischen Know-hows. Die Nachfrage nach Ausrüstung verschiebt sich zu größeren Compound-Dies, Chip-on-Panel-Werkzeugen und Hybrid Bonding.
- EDA und IP. Multi-Die-Design ist heute ein Co-Design-Problem, das Die, Interposer, Package und Board umspannt. Es verlangt ein gemeinsames Datenmodell sowie neue Verifikations- und Wärmeanalysetools, und Standardschnittstellen wie UCIe sind es, die IP-Blöcke als Chiplets wiederverwendbar machen, statt sie neu zu entwerfen.
Die Grenze zwischen „Foundry“, „OSAT“ und „Systemunternehmen“ verschwimmt. Wer den hochdichten Interconnect kontrolliert, kontrolliert den Integrationspunkt – und die Marge.
Die Ökonomie: Known-Good-Die, Ausbeute und Kosten pro Transistor
Der Grund, warum Packaging strategisch wurde, ist Arithmetik.
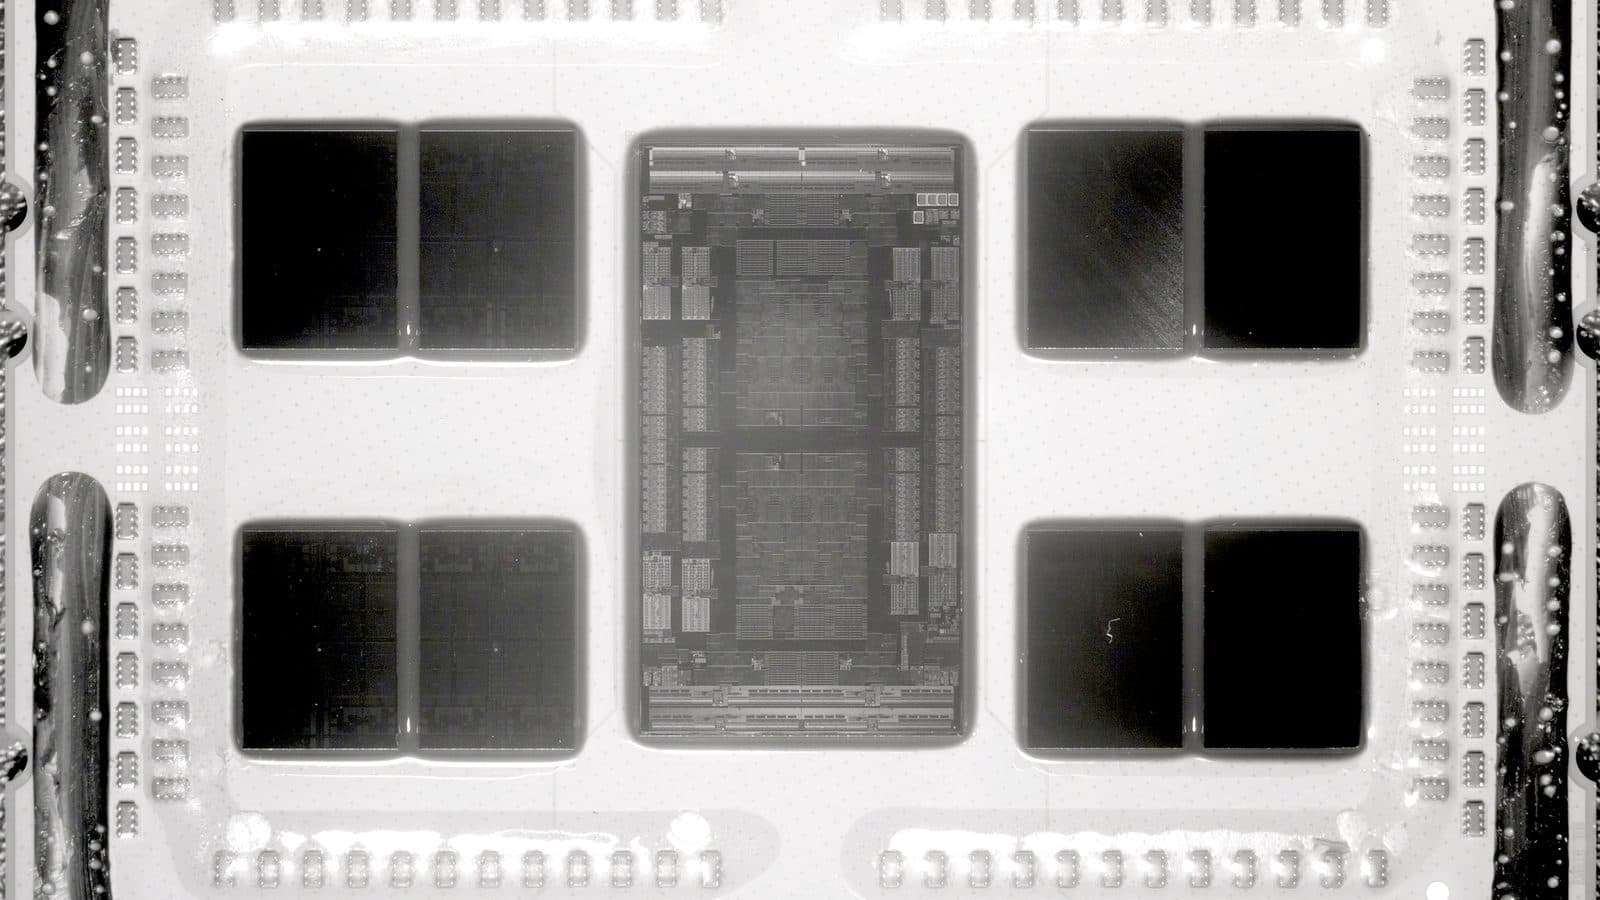
Ein monolithischer Die ist nur so gut wie seine schwächste Stelle. Teilt man ihn in vier kleinere Dies auf, ruiniert ein einziger tödlicher Defekt nur ein Viertel des Siliziums; jeder Die kann vor der Montage getestet werden, und die Überlebenden werden wieder zusammengesetzt. AMDs Ingenieure modellierten genau das für eine frühe Chiplet-CPU und schätzten, dass das Vier-Chiplet-Design etwa das 0,59-Fache der hypothetischen monolithischen Version kostete – obwohl es etwas mehr Silizium insgesamt verwendete.
Das ist die Oberseite. Die Unterseite ist, dass Packaging eigene Ausbeute- und Kostenschichten einführt:
- Known-Good-Die-Test. Jedes Chiplet muss getestet werden, bevor es in ein teures Package geht. Dieser Test kostet Geld und Durchlaufzeit, verhindert aber, dass ein einzelner toter Die eine hochwertige Baugruppe zerstört.
- Ausbeute auf Package-Ebene. Bonding-Defekte, Interposer-Defekte, Verwölbung und Partikel können ein fertig montiertes Modul töten. Die-zu-Wafer-Hybrid-Bonding hilft, indem verifizierte Dies auf verifizierte Basis-Dies gebondet werden.
- Integrationskosten. AMDs eigenes White Paper nennt Packaging-Komplexität, geringere Gesamtausbeute des Systems und Latenz als reale Strafen der Disaggregation. Ein Design aufzuteilen ist nicht kostenlos.
- Substratverfügbarkeit. Große, verwölbungsresistente organische und Glas-Substrate sind eine endliche Ressource, und die Nachfrage nach ihnen ist selbst zum Engpass geworden.
Das Nettoergebnis ist, dass der „Preis pro Transistor“ – die Kennzahl, die einst jeden Knoten rechtfertigte – heute nur noch ein Teil der Geschichte ist. Entscheidend sind Kosten pro Package, Kosten pro Watt und Kosten pro gelieferter Leistungseinheit, und die hängen stark davon ab, wie gut die Dies integriert sind.
Was das für CPUs, GPUs und Beschleuniger bedeutet
Das Chiplet-Playbook ist inzwischen in der ganzen Branche sichtbar, wird aber nicht überall gleich angewandt.
Bei CPUs geht es bei der Disaggregation vor allem um Kosten und Modularität. Ein Serverprozessor kann viele identische Compute-Dies mit einem separaten I/O-Die auf einem älteren, günstigeren Prozess kombinieren und dann die Kernzahl und den Cache einfach durch Hinzufügen von Dies skalieren. AMDs moderne EPYC-Generationen tragen bis zu 16 Compute-Chiplets um einen einzigen I/O-Die und teilen Silizium zwischen Produktfamilien und nutzen gute Dies weit effizienter als ein monolithisches Design.
Bei KI-Beschleunigern ist Packaging näher am Produkt selbst. Nvidia und AMD veranschaulichen zwei unterschiedliche Philosophien: Eine Analystenanalyse stellt Nvidias B200 – 208 Milliarden Transistoren auf zwei Chiplets – AMDs MI350 mit 185 Milliarden Transistoren auf acht gegenüber und rahmt das als Performance zuerst versus Kosten zuerst. Beide Ansätze räumen denselben Punkt ein: Die größten Beschleuniger lassen sich nicht mehr als einzelne Dies bauen, also setzt das Package – nicht der Transistor – die Grenzen für Speicherbandbreite, Energieversorgung und Skalierung.
Das ist auch der Grund, warum Packaging-Kapazität zu einem strategischen Nadelöhr geworden ist. Ein Design kann fertig und die Logik-Wafer können verfügbar sein, doch das Produkt kann ohne Interposer-, HBM- und Montagekapazität dennoch nicht ausgeliefert werden. In diesem Sinne hat sich der Schwerpunkt der Branche von der Fab auf das Package verlagert.
Vorbehalte und offene Probleme
Advanced Packaging ist kein Allheilmittel, und es führt neue Fehlermodi ein, während es alte löst.
- Hitze. Gestapelte Dies stauen Wärme, und Speicher-auf-Logik- sowie Logik-auf-Logik-Stapel erschweren die Kühlung genau dort, wo die Leistungsdichte am höchsten ist. Thermomanagement, nicht nur elektrisches Design, begrenzt heute die Leistung.
- Mechanische Spannung. Materialien mit unterschiedlichen Wärmeausdehnungskoeffizienten werden in großem Maßstab miteinander verbunden, was Verwölbung und Zuverlässigkeitsprobleme erzeugt, die mit der Package-Größe wachsen.
- Energieversorgung. Große Packages mit hohen transienten Strömen belasten das Stromversorgungsnetz; die Spannung unter schnellen Lastwechseln zu halten, ist ebenso ein Packaging- wie ein Schaltungsproblem.
- Test und Debug. Sind Dies erst gebondet, lassen sie sich schwer kontaktieren. Testzugang, Telemetrie und Debugging über mehrere Chiplets hinweg sind aktive Standardisierungsfelder.
- Reife des Ökosystems. Standardschnittstellen und interoperable Chiplets werden besser, aber der Plug-and-Play-Marktplatz für Chiplets ist noch mehr Wunsch als Realität. Viele Volumendesigns nutzen proprietäre Die-zu-Die-Links.
- Die eigene Steuer der Disaggregation. Arbeit über Dies zu verteilen kostet Latenz und Leistung pro Watt. Für latenz- oder kostenempfindliche Produkte können monolithische Designs weiterhin gewinnen.
Was zu beobachten ist
Die Richtung ist klar: mehr Dies, dichtere Verbindungen, größere Packages und mehr Wert des Systems, der auf der Integrationsschicht eingefangen wird. Die interessanten Fragen drehen sich darum, welche Techniken von Premium zu Mainstream übergehen.
- Glas-Substrate und Glas-Interposer, die flachere, dimensionsstabilere große Packages versprechen und das Verwölbungsproblem lindern könnten, das organische Substrate begrenzt.
- Panel-Level-Packaging, das seine Ausbeute und Gleichmäßigkeit beweisen muss, bevor es Wafer-Level-Flows für Volumenprodukte verdrängen kann.
- Hybrid Bonding im Speicher, das bestimmt, ob HBM weiter höher stapeln kann, ohne thermische und Höhenbudgets zu sprengen.
- UCIe und das Chiplet-Ökosystem, wo Test-, Manageability- und Compliance-Funktionen genauso viel zählen wie rohe Bandbreite.
- Co-Packaged Optics, das Hochgeschwindigkeitsverbindungen von Kupferleiterbahnen ins Package verlagert und den Interconnect von Rechenzentren umformen könnte.
- Kapazität und Kosten von Advanced Packaging, die praktische Grenze dafür, wie schnell all das skaliert.
All das macht Transistor-Skalierung nicht irrelevant. Leading-Edge-Logik ist weiterhin dort, wo die schnellste, effizienteste Rechenleistung lebt, und die Knoten schreiten weiter voran. Doch die Erträge kommen heute aus der Kombination der richtigen Dies im richtigen Package, nicht aus dem endlosen Verkleinern eines einzelnen Die. Die entscheidenden Wettkämpfe der Branche – um Leistung, um Kosten, darum, wer den Stack kontrolliert – werden auf der Package-Ebene ausgetragen. Das ist das neue Schlachtfeld, und es wird lange so bleiben.
Die Ein-Satz-Version
Transistoren zählen weiterhin, aber die Gewinne kommen heute aus der Integration: Chiplets, dichter Die-zu-Die-Interconnect und gestapelter Speicher, verpackt in einem einzigen System – weshalb das Packaging, nicht nur die Lithografie, entscheidet, was Chips leisten und was sie kosten.
Tags

TPW Editorial
Redaktion
Die Redaktion von TechPastWeek recherchiert und betreut jeden veröffentlichten Artikel. Jede Geschichte wird anhand von Primär- und glaubwürdigen Sekundärquellen geprüft und vor der Veröffentlichung redaktionell freigegeben.