Kimi K3 de Moonshot llega a Amazon Bedrock con caché de prompts para pesos abiertos
Amazon Web Services añadió Kimi K3 de Moonshot AI a Bedrock el 18 de septiembre de 2026, el primer modelo de pesos abiertos allí con caché de prompts.

En esta página
Puntos clave
- Amazon Web Services puso Kimi K3 de Moonshot AI a disposición general en Amazon Bedrock el 18 de septiembre de 2026.
- Moonshot describe Kimi K3 como el primer modelo abierto en alcanzar 2,8 billones de parámetros, con visión nativa y una ventana de contexto de 1.048.576 tokens.
- Kimi K3 es el primer modelo de pesos abiertos en Bedrock con caché de prompts explícita, donde un prefijo cacheado de al menos 1.024 tokens se conserva al menos 30 minutos.
- El modelo se ofrece mediante un perfil geográfico de EE. UU. (us.moonshotai.kimi-k3) para residencia de datos y un perfil global (global.moonshotai.kimi-k3) que enruta a cualquier región comercial compatible y cuesta alrededor de un 10 % menos.
- El anuncio de AWS se apoya en las propias cifras de Moonshot; no se publicaron datos de referencia independientes ni precios de la caché.
El 18 de septiembre de 2026, Amazon Web Services anunció que Kimi K3, el modelo más reciente de Moonshot AI, está disponible de forma general en Amazon Bedrock. AWS lo situó para el trabajo de programación y de conocimiento, y destacó un detalle como primicia: Kimi K3 es el primer modelo de pesos abiertos en Bedrock que admite caché de prompts explícita.
Lectura relacionada: OpenAI dice haber interrumpido una campaña de extracción de razonamiento vinculada a personas asociadas a Moonshot AI · Mezcla de expertos explicada: por qué los mayores modelos de IA activan solo una parte de sí mismos.
La escala es el titular. Moonshot describe Kimi K3 como su modelo más capaz y el primero abierto en alcanzar 2,8 billones de parámetros. El modelo incorpora visión nativa y una ventana de contexto de 1.048.576 tokens, que según la empresa encaja con sesiones largas de programación sobre repositorios grandes y con el análisis de varios documentos, incluidas páginas escaneadas y capturas de pantalla.
Según Moonshot, Kimi K3 ofrece una eficiencia de escalado unas 2,5 veces mejor que Kimi K2. AWS repite esa afirmación y no añade ninguna medición independiente propia.
Qué es Kimi K3
Kimi K3 apareció por primera vez en julio de 2026 a través de los propios productos de Moonshot: la aplicación Kimi, la aplicación de escritorio Kimi Work, la herramienta de terminal Kimi Code y la API de la compañía. Moonshot afirma que publicó los pesos antes del 27 de julio. La inclusión en Bedrock da al modelo un canal de distribución gestionado junto a esas vías directas, y lo suma a una cartera de Bedrock que ya incluye Kimi K2.5 y Kimi K2 Thinking.
La arquitectura es lo que hace singular al modelo. Según la tarjeta de modelo de Moonshot en GitHub, Kimi K3 es un diseño de mezcla de expertos: 2,8 billones de parámetros totales, de los cuales se activan 104.000 millones por token. Tiene 93 capas y 896 expertos, con 16 seleccionados por token más dos expertos compartidos. La pila de atención combina KDA con Gated MLA, y la visión pasa por un codificador MoonViT-V2 de 401 millones de parámetros. Los pesos se almacenan en MXFP4 con activaciones MXFP8.
"the world's first open 3T-class model" — Moonshot AI, tarjeta del modelo Kimi K3
Cómo obtiene su velocidad un modelo de mezcla de expertos: En un diseño MoE disperso, cada token se dirige a una pequeña fracción de la red. Kimi K3 activa 104.000 millones de sus 2,8 billones de parámetros para cada token, de modo que el cómputo por token se acerca mucho más a un modelo de 100.000 millones de parámetros que a los 2,8 billones completos. El total de parámetros fija la capacidad; la cifra activada determina el coste de servicio.
Esa distinción importa para quien lea la cifra de 2,8 billones como una aproximación al coste. Un modelo denso de ese tamaño sería impracticable de servir a escala. Uno disperso sigue siendo exigente, pero la cifra que predice el coste de inferencia son los 104.000 millones activados por token, más la memoria necesaria para mantener el conjunto completo de pesos.
Qué añade Bedrock
Colocar Kimi K3 en un hiperescalador cambia más la maquinaria que lo rodea que el propio modelo. AWS afirma que el modelo se ejecuta dentro del mismo límite de seguridad que sus modelos propietarios, con los mismos controles de acceso, cifrado y auditoría en toda la cartera de modelos de un cliente. Para las empresas que evaluaban modelos de pesos abiertos y se preocupaban por las compras, el registro y el cumplimiento, ese envoltorio suele ser el factor decisivo.
La caché de prompts es la incorporación más técnica. El modo explícito de Bedrock permite a un desarrollador marcar el final exacto de un prefijo de prompt reutilizable, tras al menos 1.024 tokens, adjuntando un prompt_cache_breakpoint a contenido de entrada compatible. Los tokens escritos en la caché se facturan a una tarifa más alta en el momento de la escritura, pero permanecen cacheados al menos 30 minutos. Las solicitudes posteriores que coinciden con el prefijo reciben precios de entrada con descuento y dejan de contar para las cuotas de tokens de entrada por minuto.
Para cargas de trabajo largas de programación o de agentes, ese patrón encaja de lleno. Las instrucciones del repositorio, las definiciones de herramientas y los documentos de referencia suelen ser idénticos entre llamadas, por lo que cachearlos elimina coste y latencia de entrada repetidos. AWS no publicó los precios exactos de la caché, lo que dificulta modelar el ahorro antes de que llegue una factura.
Este tipo de caché se ha convertido en un rasgo competitivo entre proveedores de modelos, porque ataca la parte de la inferencia de agentes que escala con la repetición y no con el tamaño de la tarea. Cuando un agente vuelve a leer el mismo repositorio o documento de políticas en cada paso de una ejecución larga, el lado de la entrada de la factura puede superar con creces el lado de la salida. Un punto de interrupción de caché permite al proveedor cobrar una vez por escribir ese prefijo y luego una tarifa menor por cada reutilización, lo que cambia la economía unitaria de un flujo de trabajo que de otro modo sería poco rentable de automatizar.
Hay dos perfiles de inferencia entre regiones. us.moonshotai.kimi-k3 mantiene la inferencia dentro de Estados Unidos para los requisitos de residencia de datos. global.moonshotai.kimi-k3 enruta una solicitud a cualquier región comercial de AWS compatible y cuesta alrededor de un 10 % menos, según TPS Report. El equilibrio está entre el control jurisdiccional y el precio, y AWS deja la elección al cliente.
Dónde encontrarlo: Se puede acceder a Kimi K3 en la consola de Bedrock, en Test > Playground, o mediante programación a través del endpoint bedrock-runtime. Bedrock lo expone con las API nativas Invoke y Converse y con las API compatibles con OpenAI Responses y Chat Completions. La superficie compatible con OpenAI es la que permite que herramientas como la CLI de Kimi Code apunten a Bedrock cambiando la URL base.
La economía de los pesos abiertos
Kimi K3 es la última incorporación a un cambio de cartera en Bedrock. Desde 2025 el servicio ha sumado modelos de pesos abiertos de DeepSeek, Google, MiniMax, Mistral AI, Moonshot AI, NVIDIA, OpenAI y Qwen. En 2026 AWS añadió capacidades de plataforma por encima: llamada a herramientas, salida estructurada, razonamiento, transmisión de respuestas y las API Responses y Chat Completions. Los nuevos modelos de pesos abiertos heredan esas funciones en lugar de exigir trabajo de integración por modelo.
Lo que AWS no ha dicho: El anuncio describe Kimi K3 con el lenguaje y las cifras del propio Moonshot, como también señaló Unite.AI. AWS no publicó resultados de referencia independientes para programación, razonamiento o visión, ni reveló los precios de escritura o lectura de la caché. Trate las afirmaciones de capacidad y eficiencia como afirmaciones del fabricante hasta que terceros prueben el modelo.
Es fácil malinterpretar los pesos abiertos como código abierto o como gratuito. No son ninguna de las dos cosas. Publicar los pesos permite a otros descargar, ajustar y alojar el modelo, sujeto a la licencia que Moonshot adjunta. No reduce el coste de ejecutar un modelo de este tamaño. Un modelo disperso de 2,8 billones de parámetros sigue necesitando una memoria de acelerador considerable y una pila de servicio, que es precisamente el problema que un endpoint gestionado como Bedrock pretende absorber.
La economía de los pesos abiertos ha cambiado en los últimos años. Para la mayoría de los equipos, alojar un modelo de clase frontera es más caro que alquilar acceso a la API, y el beneficio real de los pesos abiertos es la opcionalidad: poder moverse entre proveedores, ajustar el modelo o mantener los datos en un entorno controlado. La versión de esa historia en Bedrock es que un cliente puede usar un modelo de Moonshot bajo el mismo paraguas de gobernanza que los modelos de Anthropic o de la propia Amazon.
La caché de prompts encaja con esa lógica comercial. Los proveedores de inferencia compiten en parte por el coste de los tokens de entrada en cargas de agentes que reenvían gran contexto en cada paso. Ofrecer caché explícita, incluso sin tarifas publicadas, indica que AWS espera que Kimi K3 se use en sesiones largas, repetitivas y con muchas herramientas, más que en un chat de un solo turno.
El mercado de pesos abiertos también se ha vuelto más concurrido en la gama alta. Los modelos de cientos de miles de millones de parámetros son hoy rutina, y un lanzamiento de 2,8 billones de parámetros sube el techo de lo que un modelo descargable puede reclamar. Esa escala tiene una consecuencia práctica: menos organizaciones pueden servirlo por sí mismas, lo que empuja incluso el uso de pesos abiertos hacia endpoints gestionados y hace que la distribución en la nube sea más valiosa, no menos. La paradoja de un modelo abierto grande es que su tamaño puede volverlo más dependiente de las mismas plataformas que lo alojan.
Salvedades que conviene nombrar
La distancia entre el anuncio y el rendimiento verificado es amplia. El número de parámetros de Moonshot, su afirmación de eficiencia de 2,5x y su formulación "first open 3T-class model" son caracterizaciones de la propia empresa. Moonshot no ha publicado evaluaciones independientes de terceros para este lanzamiento, y AWS no aporta ninguna. El número de parámetros no es una prueba de referencia; no dice nada sobre cómo programa, razona o lee documentos el modelo en comparación con sus rivales.
El panorama de precios también es parcial. Existen tarifas por token de entrada y salida en la página de precios de Bedrock, pero las tarifas de escritura y lectura de caché no se publicaron en el material de lanzamiento. Sin ellas, la función estrella de caché no puede convertirse en una estimación de coste, algo que importa para los flujos de contexto largo a los que apunta el modelo.
También cuenta el ángulo de distribución. Moonshot es un laboratorio chino, y las empresas occidentales ponderan cada vez más el origen y los términos de licencia al elegir un modelo fundacional. "Pesos abiertos" no significa que la licencia no tenga restricciones, y los equipos que planean ajustar o revender deberían leer los términos en lugar de dar por hecho un uso permisivo.
Qué observar
Tres cosas convertirían este anuncio en una decisión. Primera, precios de caché publicados, que permitirían a los equipos modelar el coste de las cargas de agentes para las que se construyó la función. Segunda, pruebas de referencia de terceros sobre programación y recuperación de contexto largo, que contrastarían las afirmaciones de Moonshot con modelos que ya están en Bedrock. Tercera, señales de adopción, como si las herramientas de programación y los marcos de agentes añaden Kimi K3 como opción de primera clase o lo tratan como un endpoint más.
La pregunta más amplia es si la distribución por hiperescaladores se convierte en la vía por defecto para los grandes modelos de pesos abiertos. Cuando un modelo está disponible tanto como pesos descargables como servicio en la nube gobernado, el servicio en la nube suele ganar entre los compradores empresariales que valoran las compras y la auditoría por encima del control. Si Kimi K3 sigue ese patrón, la parte del lanzamiento que decidirá su adopción es el medidor de caché que AWS todavía no ha puesto precio.
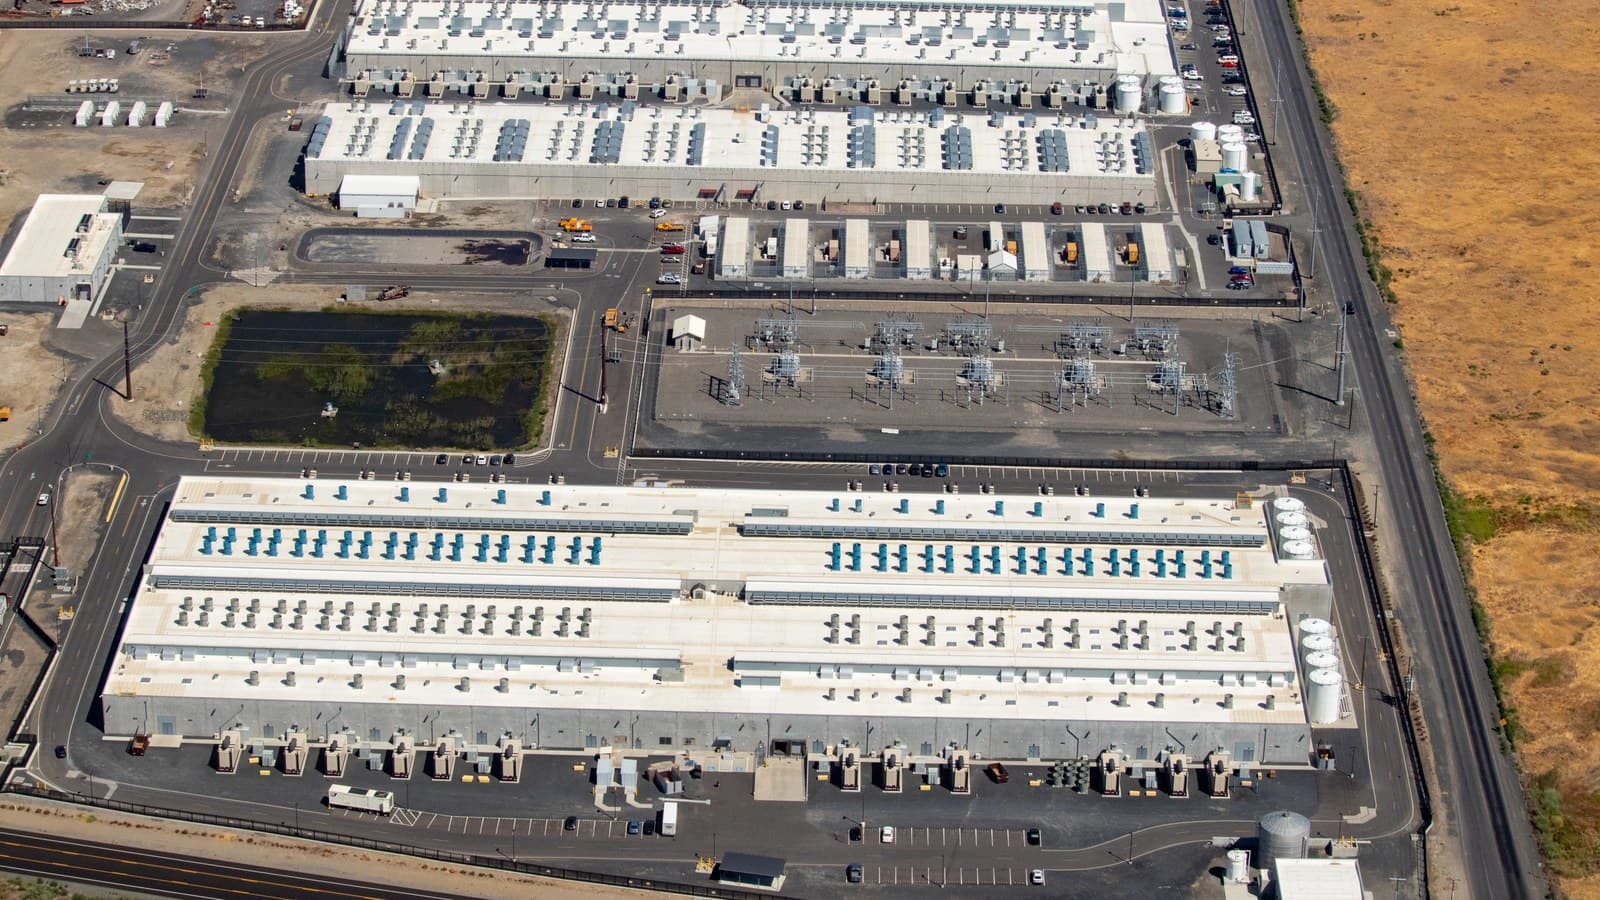
Portada: centro de datos de Amazon AWS en us-west-2, "Amazon AWS us-west-2 beach AZ.jpg" de Tedder vía Wikimedia Commons, con licencia CC BY-SA 4.0 (recortada a 16:9).
Etiquetas
Preguntas frecuentes
- ¿Qué es Kimi K3?
- Kimi K3 es un gran modelo de pesos abiertos de Moonshot AI. Moonshot lo describe como su modelo más capaz y el primero abierto en alcanzar 2,8 billones de parámetros, con visión nativa y una ventana de contexto de aproximadamente un millón de tokens.
- ¿Qué es la caché de prompts explícita en Amazon Bedrock?
- Permite a los desarrolladores marcar un prefijo de prompt reutilizable, tras al menos 1.024 tokens, con un prompt_cache_breakpoint. Los tokens cacheados se facturan a una tarifa de escritura más alta pero se conservan al menos 30 minutos, y las solicitudes posteriores que coinciden reciben precios de entrada con descuento y dejan de contar para las cuotas de tokens de entrada por minuto.
- ¿Cómo se accede a Kimi K3 en Amazon Bedrock?
- Mediante dos perfiles de inferencia entre regiones: us.moonshotai.kimi-k3 para residencia de datos en EE. UU., o global.moonshotai.kimi-k3, que enruta a cualquier región comercial compatible por alrededor de un 10 % menos. Está disponible en el playground de la consola de Bedrock y a través del endpoint bedrock-runtime.
- ¿Kimi K3 es gratis por ser de pesos abiertos?
- No. Los pesos abiertos significan que los pesos del modelo se publican, pero ejecutar un modelo de 2,8 billones de parámetros sigue requiriendo una capacidad de cómputo considerable, y en Bedrock es un servicio medido con precios por token de entrada y salida.

TPW Editorial
Redacción
El equipo editorial de TechPastWeek investiga y edita cada artículo que publicamos. Cada historia se contrasta con fuentes primarias y secundarias fiables, y un editor la revisa antes de publicarse.