SpaceXAI livre Grok 4.7 pour le code aux prix de Grok 4.6, avec ses propres benchmarks à l'appui
SpaceXAI a publié Grok 4.7 le 21 septembre 2026, le présentant comme son modèle de code le plus capable à ce jour, aux mêmes tarifs de 2 et 6 dollars par million de jetons que Grok 4.6.


Sur cette page
À retenir
- SpaceXAI a publié Grok 4.7 le 21 septembre 2026, le décrivant comme son modèle le plus capable pour le code et le travail de connaissance, aux mêmes 2 dollars par million de jetons d'entrée et 6 dollars par million de jetons de sortie que Grok 4.6.
- Le modèle repose sur un modèle de base plus grand et un apprentissage par renforcement plus long que Grok 4.6, et SpaceXAI affirme qu'il vérifie son propre travail plus soigneusement sur les tâches longues.
- SpaceXAI annonce un CursorBench 4.0 passant de 40,4 % à 46,3 % et un Terminal-Bench 4.0 de 20,3 % à 38,0 %, des chiffres d'éditeur non vérifiés indépendamment.
- La mesure indépendante raconte une histoire plus prudente : l'Artificial Analysis Intelligence Index place Grok 4.7 à 46, derrière Claude Fable 5.1 et GPT-6 à 53.
- Grok 4.7 est disponible via Cursor, Grok Build, l'API Grok et des passerelles tierces, mais pas encore dans l'application grand public Grok ni dans l'offre gratuite.
SpaceXAI a publié Grok 4.7 le 21 septembre 2026, le présentant comme le modèle le plus capable de l'entreprise à ce jour pour le code et le travail de connaissance. Il arrive avec les mêmes tarifs de jetons affichés que son prédécesseur, un modèle de base plus grand en dessous et une série d'améliorations de benchmarks que l'entreprise a publiées elle-même.
À lire aussi: Grok Voice Transcribe 2.0 revendique une précision doublée pour le même tarif de 10 cents · Claude Haiku 5.5 est le petit modèle le moins cher d'Anthropic à ce jour.
La sortie s'inscrit dans un rythme rapide pour l'entreprise d'IA d'Elon Musk, qui avait livré Grok 4.6 en août et Grok Voice Transcribe 2.0 quelques jours plus tôt. Grok 4.7 vise précisément le marché où les laboratoires d'IA se livrent la concurrence la plus rude : les agents d'ingénierie logicielle capables de travailler sur une tâche pendant des heures, d'exécuter des commandes et de vérifier leur propre production.
Le discours est simple. SpaceXAI affirme que Grok 4.7 a été entraîné avec une session d'apprentissage par renforcement plus longue sur un mélange de tâches plus difficile, pondéré vers des problèmes pouvant demander de nombreuses heures, et qu'il vérifie son propre travail plus soigneusement que Grok 4.6. La disponibilité est large : Cursor, Grok Build, l'API Grok, des outils de code tiers et des passerelles de modèles comme OpenRouter, Vercel et Cloudflare. L'annonce de Cursor confirme que le modèle est devenu disponible dans son éditeur le jour même.
Le prix est la stratégie
Le détail le plus lourd de conséquences est ce qui n'a pas changé. Grok 4.7 démarre à 2 dollars par million de jetons d'entrée et 6 dollars par million de jetons de sortie, les mêmes tarifs de base que SpaceXAI facturait pour Grok 4.6. L'entrée en cache coûte 0,50 dollar par million de jetons, et les requêtes atteignant ou dépassant 200 000 jetons passent à 4 dollars par million en entrée et 12 dollars par million en sortie.
Cette grille tarifaire se rapproche davantage des modèles ouverts chinois que de la frontière occidentale. Les meilleurs modèles de Claude et d'OpenAI ont généralement affiché des prix par jeton plus élevés, et tenir la barre tout en améliorant les capacités est une manière délibérée de concurrencer les développeurs sensibles au coût. The Decoder lit dans la tarification le signal le plus clair du lancement, en notant que les bas tarifs existent probablement pour une raison.
SpaceXAI vend aussi une variante plus rapide. Grok 4.7 Fast tourne sur une infrastructure de service plus véloce et coûte le double des tarifs standard, soit 4 dollars par million en entrée et 12 dollars par million en sortie. C'est l'option par défaut dans Cursor et Grok Build, mais elle n'est pas proposée via l'API publique, ce qui garde un certain contrôle sur la façon dont la capacité est consommée.
Le modèle lui-même est solide sur le papier. Il prend en charge une fenêtre de contexte de 500 000 jetons, une date de coupure des connaissances de mai 2026, l'entrée texte et image, et quatre niveaux de raisonnement, de faible à xhigh, avec high par défaut. Il peut recourir à l'appel de fonctions, à la recherche web, à la recherche X et à l'exécution de code. Ce sont des fonctions de base pour un modèle de code de frontière, et aucune n'est inhabituelle pour la classe.
Ce que vous obtenez : une fenêtre de contexte de 500 000 jetons, l'entrée texte et image, quatre niveaux de raisonnement et des outils pour l'appel de fonctions, la recherche web, la recherche X et l'exécution de code, à 2 dollars par million de jetons d'entrée et 6 dollars par million de jetons de sortie pour les requêtes standard.
Chiffres d'éditeur et chiffres indépendants
Les benchmarks publiés par SpaceXAI montrent des gains sur chaque mesure qu'il a choisie. Sur CursorBench 4.0, qui met à l'épreuve les tâches de code longues, Grok 4.7 obtient 46,3 pour cent contre 40,4 pour cent pour Grok 4.6. Sur DeepSWE v1.1, il passe de 65,2 pour cent à 71,0 pour cent. Le bond le plus important concerne Terminal-Bench 4.0, où l'entreprise annonce 20,3 pour cent pour Grok 4.6 et 38,0 pour cent pour Grok 4.7.
Ce sont des chiffres d'éditeur, et l'écart avec les tests indépendants constitue la mise en garde la plus importante du lancement. The Decoder rapporte que les résultats indépendants de Terminal-Bench 4.0 placent Grok 4.7 à environ 26 pour cent, bien en dessous des 38 pour cent de SpaceXAI et loin derrière GPT-6 Astra à 60 pour cent et Claude Fable 5.1 à 55 pour cent. Le même article note que même DeepSeek V4.1 Flash, un modèle moins cher, le dépasse sur cette mesure.
Sur l'Artificial Analysis Intelligence Index, plus large et combinant dix benchmarks, Grok 4.7 obtient 46 et se classe au milieu du peloton. Claude Fable 5.1 et GPT-6 mènent à 53 chacun. Ce n'est pas un mauvais résultat pour un modèle à ce prix, mais cela ne soutient pas non plus la prétention à être un leader de frontière.
Attention à la source des benchmarks : les chiffres de CursorBench, DeepSWE et Terminal-Bench fournis par SpaceXAI sont les siens. L'évaluation indépendante place le modèle sous le haut du panier en matière de code agentique, et les chiffres d'éditeur et de tiers pour un même test peuvent différer de plus de dix points de pourcentage.
L'écart compte parce que les acheteurs que SpaceXAI courtise font leur propre évaluation. Un développeur qui hésite entre Grok 4.7, Claude et GPT-6 lancera ses propres tâches et mesurera le coût, les corrections et le temps de complétion. Sur le prix, Grok 4.7 se bat dur. Sur la capacité de code brute, les chiffres indépendants suggèrent qu'il est derrière les leaders.
Un marché encombré avec de la place au bas de la gamme
Le contexte du lancement est un marché des agents de code scindé en paliers. En haut, GPT-6 Astra et Claude Fable 5.1 se disputent la capacité et affichent des prix premium. En dessous, un groupe de modèles moins chers se bat sur la valeur, et Grok 4.7 se situe dans ce groupe malgré le discours de frontière de SpaceXAI.
Cette position n'est pas mauvaise. Beaucoup d'équipes n'ont pas besoin du meilleur modèle absolu pour chaque tâche, et la revue de code, la génération de tests et la refactorisation de routine sont souvent satisfaisantes à moindre prix. Un modèle à peu près compétitif et bien moins cher peut gagner une large part du travail quotidien, tout en laissant les problèmes les plus difficiles au palier premium.
Il y a aussi une histoire de distribution. Grok 4.7 arrive dans Cursor et Grok Build en même temps que l'API, ce qui le place devant les développeurs dans les outils qu'ils utilisent déjà. Les routeurs de modèles et les passerelles cloud ajoutent d'autres voies, et l'ampleur de la disponibilité réduit la friction qui peut enrayer un lancement. La limite est qu'il n'est pas encore dans l'application grand public Grok ni dans l'offre gratuite, si bien que le grand public que SpaceXAI touche via sa plateforme sociale ne l'a pas encore vu.
La course dans laquelle entre Grok 4.7
Les agents de code sont devenus le front le plus concurrentiel de l'IA, car l'ingénierie logicielle est l'endroit le plus clair où la production d'un modèle peut être vérifiée et payée. GPT-6 Astra d'OpenAI et Claude Fable 5.1 d'Anthropic trônent au sommet des classements indépendants et se disputent la capacité, tandis qu'un palier inférieur mené par des modèles moins chers se bat sur le prix et le volume. Grok 4.7 se situe dans ce palier inférieur au vu des preuves, avec un tarif de frontière qui sous-cote nettement les leaders.
L'écart avec le sommet n'est pas énorme en termes absolus. Un score de 46 contre 53 à l'Artificial Analysis est une vraie différence, mais c'est le genre d'écart qui se réduit à chaque génération de modèles, et SpaceXAI publie des mises à jour rapidement. Ce qui sépare les paliers aujourd'hui tient moins à la capacité brute sur des tâches moyennes qu'à la fiabilité sur les travaux longs et à étapes multiples, où un agent doit planifier, agir, se remettre de ses erreurs et vérifier son propre travail. C'est exactement là que les chiffres indépendants de Terminal-Bench placent Grok 4.7 derrière.
Pour les acheteurs, la question pratique n'est pas de savoir quel modèle remporte un classement. C'est de savoir quel modèle termine une tâche donnée à un coût acceptable, et cela varie selon l'équipe. Un modèle légèrement plus faible mais plusieurs fois moins cher peut être le meilleur choix pour la revue, les tests et les modifications de routine, tandis que le travail d'architecture et de débogage le plus difficile reste au palier premium. Grok 4.7 est positionné pour prendre le premier type de travail, et l'ampleur de sa distribution, de Cursor aux grandes passerelles, est la façon dont SpaceXAI compte le gagner.
Ce qu'il faut surveiller
La première question est de savoir si le bas prix tiendra. SpaceXAI n'a pas dit si 2 et 6 dollars par million de jetons perdureront à mesure que la capacité croît, et l'histoire des prix de l'IA est faite de tarifs de lancement généreux suivis de hausses une fois un modèle installé. Les acheteurs qui planifient autour de ces chiffres devraient les traiter comme une offre actuelle plutôt qu'un plancher permanent.
La seconde est de savoir si l'écart de capacité se réduit. SpaceXAI publie des modèles rapidement, et chaque révision a amélioré la précédente. Si les benchmarks indépendants commencent à rejoindre les affirmations de l'éditeur, l'avantage de prix de Grok 4.7 devient beaucoup plus menaçant pour le palier premium. Si l'écart persiste, le modèle reste une option de valeur.
La troisième est la façon dont Cursor et les autres distributeurs positionnent le modèle. Faire de Grok 4.7 Fast l'option par défaut dans Cursor est un vote de confiance fort, et les options par défaut façonnent ce que les développeurs utilisent. Être le choix par défaut dans un outil populaire vaut plus qu'une place dans un classement, car cela supprime entièrement le choix pour les utilisateurs qui ne changent pas de modèle.
Pour les lecteurs qui pèsent un changement, le résumé honnête est celui-ci : Grok 4.7 est un modèle de code capable et peu coûteux, issu d'une entreprise qui progresse vite, avec des benchmarks d'éditeur qui exagèrent sa position face aux leaders. Les équipes attachées au prix et à la distribution devraient le tester. Celles qui ont besoin du meilleur code agentique devraient attendre que les résultats indépendants rattrapent le marketing.
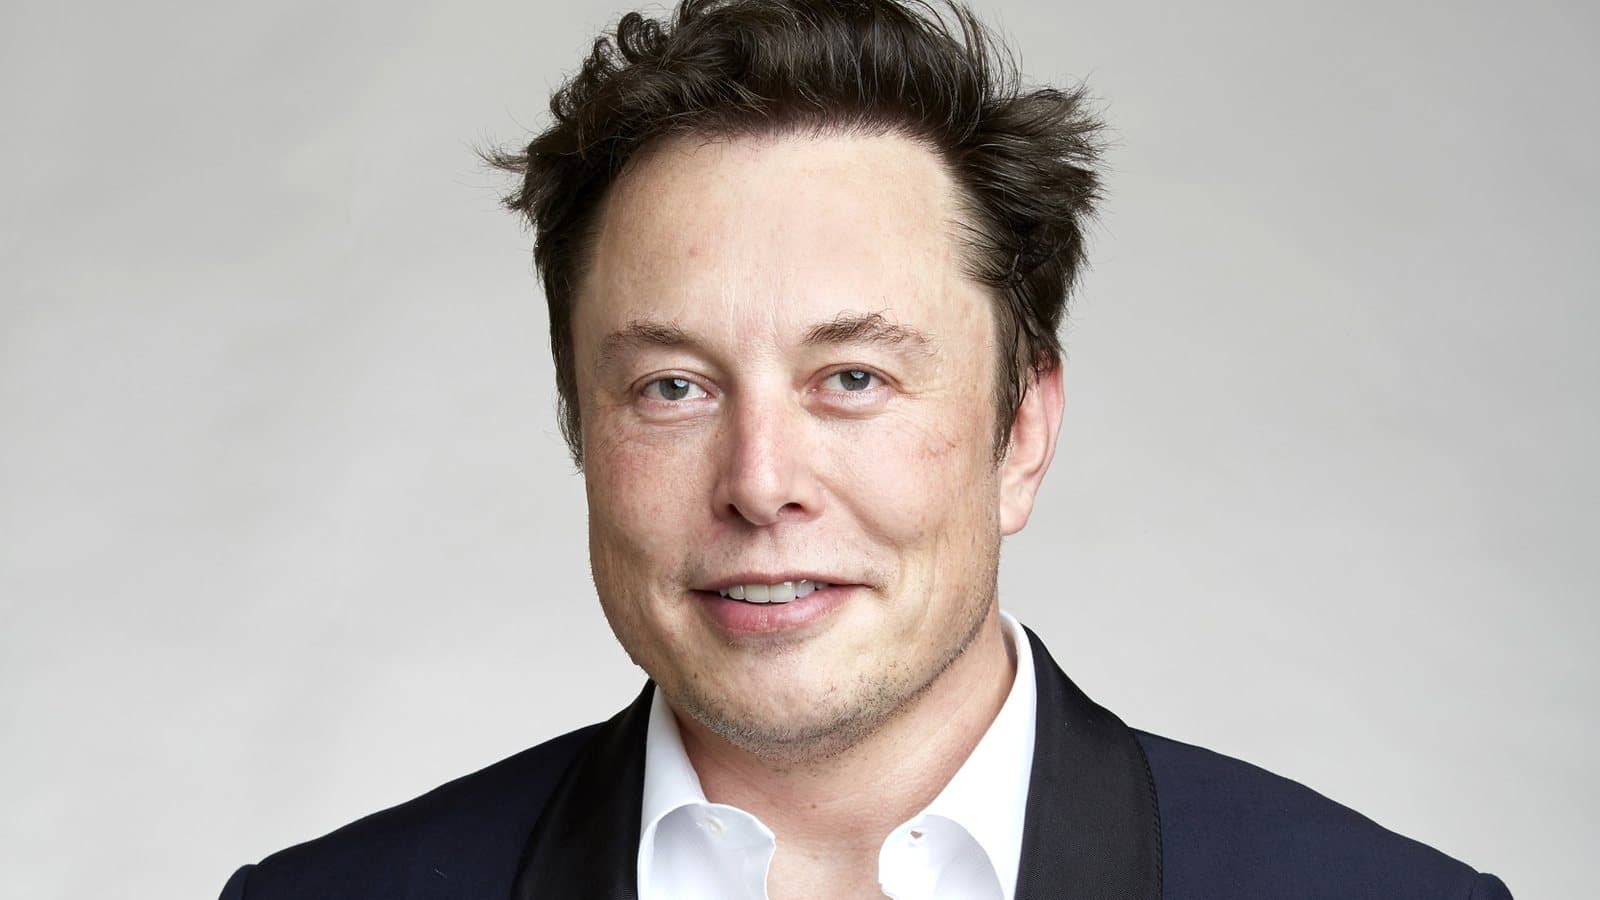
Couverture : photo Wikimedia Commons d'Elon Musk à une conférence le 28 mars 2024 par Wcamp9 (CC BY 4.0).
Étiquettes
Questions fréquentes
- Combien coûte Grok 4.7 ?
- SpaceXAI affiche Grok 4.7 à 2 dollars par million de jetons d'entrée, 0,50 dollar par million de jetons d'entrée en cache et 6 dollars par million de jetons de sortie pour les requêtes de moins de 200 000 jetons, les mêmes tarifs de base que Grok 4.6. Les requêtes atteignant ou dépassant cette taille coûtent 4 dollars par million en entrée et 12 dollars par million en sortie.
- Où Grok 4.7 est-il disponible ?
- Il est disponible dans Cursor, dans Grok Build, via l'API Grok et par des passerelles de modèles comme OpenRouter, Vercel et Cloudflare. Il n'est pas encore dans l'application grand public Grok ni dans l'offre gratuite, et une variante plus rapide, Grok 4.7 Fast, est limitée à Cursor et Grok Build.
- Quelle est la fenêtre de contexte de Grok 4.7 ?
- Il prend en charge une fenêtre de contexte de 500 000 jetons avec une date de coupure des connaissances en mai 2026. Il accepte l'entrée texte et image, propose quatre niveaux de raisonnement et peut recourir à l'appel de fonctions, à la recherche web, à la recherche X et à l'exécution de code.
- Grok 4.7 est-il le meilleur modèle de code ?
- Non, selon les tests indépendants. Les benchmarks de SpaceXAI montrent de forts gains par rapport à Grok 4.6, mais l'Artificial Analysis Intelligence Index place Grok 4.7 à 46 tandis que Claude Fable 5.1 et GPT-6 obtiennent 53, et les résultats indépendants de Terminal-Bench sont bien inférieurs au chiffre publié par SpaceXAI.

TPW Editorial
Rédaction
L'équipe éditoriale de TechPastWeek enquête et édite chaque article publié. Chaque sujet est recoupé avec des sources primaires et secondaires fiables, et un éditeur le relit avant publication.