Kimi K3 de Moonshot débarque sur Amazon Bedrock avec le cache de prompts pour poids ouverts
Amazon Web Services a ajouté Kimi K3 de Moonshot AI à Bedrock le 18 septembre 2026, le premier modèle à poids ouverts y bénéficiant du cache de prompts.

Sur cette page
À retenir
- Amazon Web Services a rendu Kimi K3 de Moonshot AI généralement disponible sur Amazon Bedrock le 18 septembre 2026.
- Moonshot décrit Kimi K3 comme le premier modèle ouvert à atteindre 2 800 milliards de paramètres, avec une vision native et une fenêtre de contexte de 1 048 576 tokens.
- Kimi K3 est le premier modèle à poids ouverts sur Bedrock à prendre en charge le cache de prompts explicite, où un préfixe mis en cache d'au moins 1 024 tokens est conservé au moins 30 minutes.
- Le modèle est proposé via un profil géographique américain (us.moonshotai.kimi-k3) pour la résidence des données, et un profil mondial (global.moonshotai.kimi-k3) qui route vers toute région commerciale prise en charge pour environ 10 % de moins.
- L'annonce d'AWS s'appuie sur les propres chiffres de Moonshot ; aucun résultat de référence indépendant ni tarif de cache n'a été publié.
Le 18 septembre 2026, Amazon Web Services a annoncé que Kimi K3, le plus récent modèle de Moonshot AI, est généralement disponible sur Amazon Bedrock. AWS l'a positionné pour le travail de programmation et de connaissance, et a mis en avant un détail comme une première : Kimi K3 est le premier modèle à poids ouverts sur Bedrock à prendre en charge le cache de prompts explicite.
À lire aussi: OpenAI affirme avoir déjoué une campagne d'extraction de raisonnement liée à des proches de Moonshot AI · Le mélange d'experts expliqué : pourquoi les plus grands modèles d'IA n'activent qu'une partie d'eux-mêmes.
L'échelle fait la une. Moonshot décrit Kimi K3 comme son modèle le plus capable et le premier modèle ouvert à atteindre 2 800 milliards de paramètres. Le modèle embarque une vision native et une fenêtre de contexte de 1 048 576 tokens, ce qui, selon l'entreprise, convient aux longues sessions de programmation sur de grands dépôts et au travail sur plusieurs documents, y compris des pages scannées et des captures d'écran.
Selon Moonshot, Kimi K3 offre une efficacité de mise à l'échelle environ 2,5 fois meilleure que Kimi K2. AWS reprend cette affirmation et n'y ajoute aucune mesure indépendante qui lui soit propre.
Qu'est-ce que Kimi K3
Kimi K3 est apparu pour la première fois en juillet 2026 via les propres produits de Moonshot : l'application Kimi, l'application de bureau Kimi Work, l'outil de terminal Kimi Code et l'API de l'entreprise. Moonshot affirme avoir publié les poids avant le 27 juillet. L'ajout à Bedrock donne au modèle un canal de distribution géré aux côtés de ces voies directes, et l'ajoute à un portefeuille Bedrock qui compte déjà Kimi K2.5 et Kimi K2 Thinking.
L'architecture est ce qui rend le modèle singulier. Selon la fiche modèle de Moonshot sur GitHub, Kimi K3 est une conception mélange d'experts : 2 800 milliards de paramètres au total, dont 104 milliards activés par token. Il compte 93 couches et 896 experts, avec 16 sélectionnés par token plus deux experts partagés. La pile d'attention combine KDA et Gated MLA, et la vision passe par un encodeur MoonViT-V2 de 401 millions de paramètres. Les poids sont stockés en MXFP4 avec des activations MXFP8.
"the world's first open 3T-class model" — Moonshot AI, fiche modèle Kimi K3
Comment un modèle mélange d'experts gagne en vitesse : Dans une conception MoE creuse, chaque token est routé vers une petite fraction du réseau. Kimi K3 active 104 milliards de ses 2 800 milliards de paramètres pour chaque token, si bien que le calcul par token est bien plus proche d'un modèle de 100 milliards de paramètres que des 2 800 milliards complets. Le total des paramètres fixe la capacité ; le nombre activé détermine le coût de service.
Cette distinction compte pour qui lit le chiffre de 2 800 milliards comme une approximation du coût. Un modèle dense de cette taille serait impraticable à servir à l'échelle. Un modèle creux reste exigeant, mais le chiffre qui prédit le coût d'inférence est celui des 104 milliards activés par token, plus la mémoire nécessaire pour contenir l'ensemble complet des poids.
Ce que Bedrock ajoute
Placer Kimi K3 chez un hyperscaler change davantage la mécanique qui l'entoure que le modèle lui-même. AWS affirme que le modèle s'exécute dans la même frontière de sécurité que ses modèles propriétaires, avec les mêmes contrôles d'accès, de chiffrement et d'audit sur l'ensemble du portefeuille de modèles d'un client. Pour les entreprises qui évaluaient des modèles à poids ouverts et s'inquiétaient des achats, de la journalisation et de la conformité, cet emballage est souvent le facteur décisif.
Le cache de prompts est l'ajout plus technique. Le mode explicite de Bedrock permet à un développeur de marquer la fin exacte d'un préfixe de prompt réutilisable, après au moins 1 024 tokens, en attachant un prompt_cache_breakpoint à un contenu d'entrée pris en charge. Les tokens écrits dans le cache sont facturés à un tarif plus élevé à l'écriture, mais restent en cache au moins 30 minutes. Les requêtes ultérieures qui correspondent au préfixe bénéficient d'un tarif d'entrée réduit et cessent de compter dans les quotas de tokens d'entrée par minute.
Pour les charges de travail longues de programmation ou d'agents, ce schéma tombe juste. Les instructions de dépôt, les définitions d'outils et les documents de référence sont généralement identiques d'un appel à l'autre, si bien les mettre en cache supprime un coût et une latence d'entrée répétés. AWS n'a pas publié les tarifs exacts du cache, ce qui rend l'économie difficile à modéliser avant qu'une facture n'arrive.
Ce type de cache est devenu un attribut concurrentiel chez les fournisseurs de modèles, parce qu'il attaque la part de l'inférence d'agents qui évolue avec la répétition et non avec la taille de la tâche. Quand un agent relit le même dépôt ou document de politique à chaque étape d'une longue exécution, le côté entrée de la facture peut dépasser largement le côté sortie. Un point d'arrêt de cache permet au fournisseur de facturer une fois l'écriture de ce préfixe, puis un tarif réduit pour chaque réutilisation, ce qui change l'économie unitaire d'un flux de travail autrement peu rentable à automatiser.
Deux profils d'inférence inter-régions sont proposés. us.moonshotai.kimi-k3 maintient l'inférence aux États-Unis pour les exigences de résidence des données. global.moonshotai.kimi-k3 route une requête vers toute région commerciale AWS prise en charge et coûte environ 10 % de moins, selon TPS Report. L'arbitrage se situe entre le contrôle juridictionnel et le prix, et AWS laisse le choix au client.
Où le trouver : Kimi K3 est accessible dans la console Bedrock sous Test > Playground, ou par programmation via le point de terminaison bedrock-runtime. Bedrock l'expose via les API natives Invoke et Converse et via les API compatibles OpenAI Responses et Chat Completions. C'est la surface compatible OpenAI qui permet à des outils comme la CLI Kimi Code de pointer vers Bedrock en changeant l'URL de base.
L'économie des poids ouverts
Kimi K3 est la dernière entrée d'un glissement de portefeuille chez Bedrock. Depuis 2025, le service a ajouté des modèles à poids ouverts de DeepSeek, Google, MiniMax, Mistral AI, Moonshot AI, NVIDIA, OpenAI et Qwen. En 2026, AWS a superposé des capacités de plateforme : appel d'outils, sortie structurée, raisonnement, diffusion des réponses et les API Responses et Chat Completions. Les nouveaux modèles à poids ouverts héritent de ces fonctions au lieu d'exiger un travail d'intégration par modèle.
Ce qu'AWS n'a pas dit : L'annonce décrit Kimi K3 avec le vocabulaire et les chiffres de Moonshot lui-même, comme l'a aussi relevé Unite.AI. AWS n'a publié aucun résultat de référence indépendant pour la programmation, le raisonnement ou la vision, et n'a pas divulgué les tarifs d'écriture ou de lecture du cache. Traitez les affirmations de capacité et d'efficacité comme des déclarations du fournisseur jusqu'à ce que des tiers testent le modèle.
Les poids ouverts sont faciles à confondre avec l'open source ou la gratuité. Ils ne sont ni l'un ni l'autre. Publier les poids permet à d'autres de télécharger, d'affiner et d'auto-héberger le modèle, sous réserve de la licence que Moonshot y attache. Cela ne réduit pas le coût d'exploitation d'un modèle de cette taille. Un modèle creux de 2 800 milliards de paramètres nécessite toujours une mémoire d'accélérateur considérable et une pile de service, précisément le problème qu'un point de terminaison géré comme Bedrock est censé absorber.
L'économie des poids ouverts a changé ces dernières années. Pour la plupart des équipes, auto-héberger un modèle de classe frontière coûte plus cher que louer l'accès à une API, et le véritable avantage des poids ouverts est la flexibilité : pouvoir changer de fournisseur, affiner, ou garder les données dans un environnement maîtrisé. La version Bedrock de cette histoire est qu'un client peut utiliser un modèle Moonshot sous le même parapluie de gouvernance que les modèles d'Anthropic ou d'Amazon.
Le cache de prompts s'inscrit dans cette logique commerciale. Les fournisseurs d'inférence rivalisent en partie sur le coût des tokens d'entrée pour les charges d'agents qui renvoient un grand contexte à chaque étape. Proposer un cache explicite, même sans tarifs publiés, signale qu'AWS s'attend à ce que Kimi K3 serve dans des sessions longues, répétitives et riches en outils, plutôt que dans un chat à un seul tour.
Le marché des poids ouverts s'est aussi densifié dans le haut de gamme. Les modèles de plusieurs centaines de milliards de paramètres sont désormais courants, et une sortie à 2 800 milliards de paramètres relève le plafond de ce qu'un modèle téléchargeable peut revendiquer. Cette échelle a une conséquence pratique : moins d'organisations peuvent le servir elles-mêmes, ce qui pousse même l'usage des poids ouverts vers des points de terminaison gérés et rend la distribution cloud plus précieuse, pas moins. Le paradoxe d'un grand modèle ouvert est que sa taille peut le rendre plus dépendant des plateformes qui l'hébergent.
Des réserves à nommer
L'écart entre l'annonce et la performance vérifiée est large. Le nombre de paramètres de Moonshot, son affirmation d'efficacité de 2,5x et sa formule "first open 3T-class model" relèvent de la caractérisation de l'entreprise elle-même. Moonshot n'a publié aucune évaluation indépendante de tiers pour cette sortie, et AWS n'en fournit aucune. Le nombre de paramètres n'est pas une référence ; il ne dit rien de la façon dont le modèle programme, raisonne ou lit des documents par rapport à ses rivaux.
Le tableau tarifaire est lui aussi partiel. Des tarifs d'entrée et de sortie existent sur la page de tarification de Bedrock, mais les tarifs d'écriture et de lecture du cache n'ont pas été publiés dans le matériel de lancement. Sans eux, la fonction phare de cache ne peut pas se traduire en estimation de coût, ce qui compte pour les flux à contexte long que le modèle cible.
L'angle de la distribution compte également. Moonshot est un laboratoire chinois, et les entreprises occidentales pèsent de plus en plus l'origine et les termes de licence au moment de choisir un modèle de fondation. "Poids ouverts" ne signifie pas que la licence est sans restriction, et les équipes qui prévoient d'affiner ou de revendre devraient lire les termes plutôt que de supposer un usage permissif.
Ce qu'il faut surveiller
Trois choses transformeraient cette annonce en décision. Premièrement, des tarifs de cache publiés, qui permettraient aux équipes de modéliser le coût des charges d'agents pour lesquelles la fonction est conçue. Deuxièmement, des benchmarks tiers sur la programmation et la récupération à long contexte, qui testeraient les affirmations de Moonshot face à des modèles déjà présents sur Bedrock. Troisièmement, des signaux d'adoption, notamment si les outils de programmation et les cadriciels d'agents ajoutent Kimi K3 comme option de premier ordre ou le traitent comme un point de terminaison de plus.
La question plus large est de savoir si la distribution par les hyperscalers devient la voie par défaut des grands modèles à poids ouverts. Quand un modèle est disponible à la fois comme poids téléchargeables et comme service cloud gouverné, le service cloud l'emporte souvent chez les acheteurs d'entreprise qui privilégient les achats et l'audit sur le contrôle. Si Kimi K3 suit ce schéma, la partie du lancement qui décidera de son adoption est le compteur de cache qu'AWS n'a pas encore tarifé.
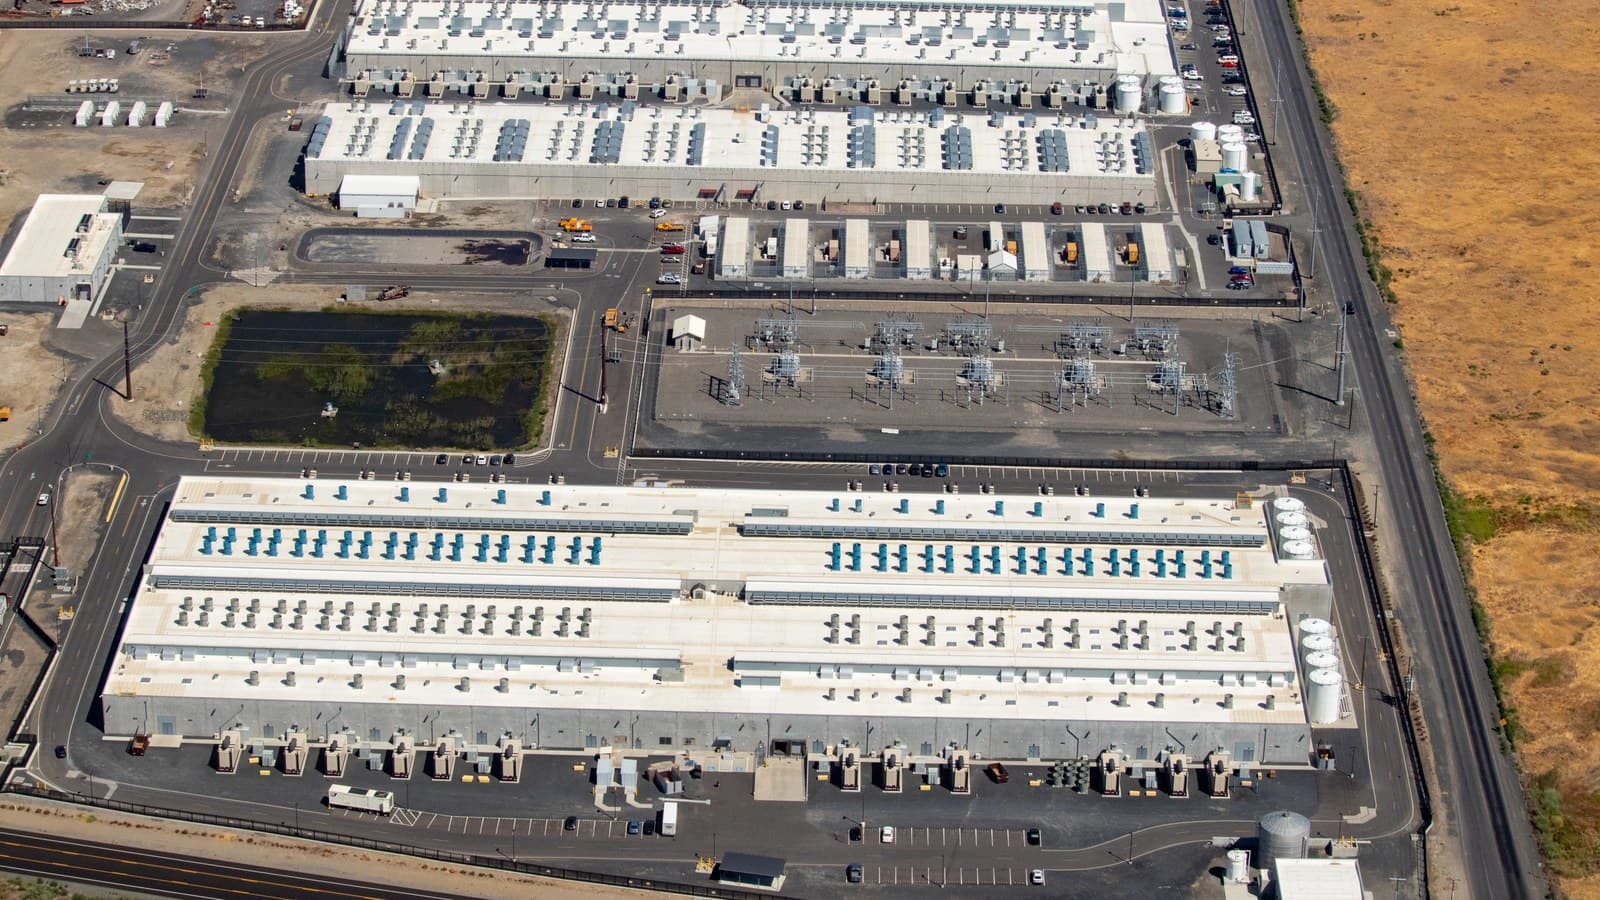
Couverture : centre de données Amazon AWS à us-west-2, "Amazon AWS us-west-2 beach AZ.jpg" de Tedder via Wikimedia Commons, sous licence CC BY-SA 4.0 (recadrée en 16:9).
Étiquettes
Questions fréquentes
- Qu'est-ce que Kimi K3 ?
- Kimi K3 est un grand modèle à poids ouverts de Moonshot AI. Moonshot le présente comme son modèle le plus capable et le premier modèle ouvert à atteindre 2 800 milliards de paramètres, avec une vision native et une fenêtre de contexte d'environ un million de tokens.
- Qu'est-ce que le cache de prompts explicite sur Amazon Bedrock ?
- Il permet aux développeurs de marquer la fin exacte d'un préfixe de prompt réutilisable, après au moins 1 024 tokens, en attachant un prompt_cache_breakpoint à un contenu d'entrée pris en charge. Les tokens écrits dans le cache sont facturés à un tarif plus élevé à l'écriture, puis conservés au moins 30 minutes, et les requêtes ultérieures correspondantes bénéficient d'un tarif d'entrée réduit et ne comptent plus dans les quotas de tokens d'entrée par minute.
- Comment accéder à Kimi K3 sur Amazon Bedrock ?
- Par deux profils d'inférence inter-régions : us.moonshotai.kimi-k3 pour la résidence des données aux États-Unis, ou global.moonshotai.kimi-k3, qui route vers toute région commerciale prise en charge pour environ 10 % de moins. Il est accessible dans le playground de la console Bedrock et via le point de terminaison bedrock-runtime.
- Kimi K3 est-il gratuit parce qu'il est à poids ouverts ?
- Non. Les poids ouverts signifient que les poids du modèle sont publiés, mais faire tourner un modèle de 2 800 milliards de paramètres exige toujours une puissance de calcul considérable, et sur Bedrock il s'agit d'un service facturé au token d'entrée et de sortie.

TPW Editorial
Rédaction
L'équipe éditoriale de TechPastWeek enquête et édite chaque article publié. Chaque sujet est recoupé avec des sources primaires et secondaires fiables, et un éditeur le relit avant publication.