Nvidia ouvre CUDA à Windows on Arm et offre aux développeurs un aperçu de Rubin
Le kit CUDA 13.4 de Nvidia atteint la disponibilité générale avec le développement natif sous Windows on Arm, un aperçu de l'architecture GPU Rubin et un MPS reconstruit.

Sur cette page
Le 9 septembre 2026, Nvidia a publié CUDA Toolkit 13.4, comblant ainsi un écart qui tenait sa plateforme de développement à l'écart de toute une catégorie d'ordinateurs. Le kit étend le développement CUDA à Windows on Arm, ce que Nvidia n'avait jamais proposé auparavant, et ouvre aussi une première voie vers Rubin, l'architecture GPU de nouvelle génération de l'entreprise. Le téléchargement public est CUDA 13.4.1, qui remplace l'aperçu développeur mis en ligne par Nvidia en juillet. (Blog technique de Nvidia, VideoCardz)
À lire aussi: DeepSeek ouvre une pile logicielle pour les puces Ascend de Huawei, avec CUDA en ligne de mire · Le DSX POD de Nvidia transforme une usine d'IA en conteneur maritime.
Le volet Windows on Arm est le titre principal. CUDA tourne sur du matériel Arm depuis des années, mais uniquement via Linux, sur des modules Jetson et des serveurs Arm64. Windows Arm64 natif était la cible manquante, et son absence maintenait la majeure partie de la pile dépendante de CUDA, de PyTorch et TensorRT aux outils professionnels de rendu et de simulation, à l'écart des machines Windows sous Arm. Le blog de Nvidia décrit cette publication comme l'extension de CUDA « à la plateforme Windows on Arm », en notant que les applications étaient « prises en charge depuis longtemps sur les plateformes Arm via Linux ».
Une chaîne d'outils propriétaire arrive
Les développeurs disposent de deux voies. Ils peuvent compiler des applications CUDA directement sur un système Windows Arm64, ou faire de la compilation croisée vers Arm64 depuis le kit Windows x86-64. Pour les équipes qui ne possèdent pas encore de matériel Arm, la seconde voie est la plus pratique, et il s'agit du même ordre d'opérations que l'industrie a connu il y a une décennie, lorsque les serveurs Arm étaient présentés pour la première fois comme une seconde architecture pour les centres de données.
Nvidia mentionne la prise en charge de Windows Arm64 dans plusieurs composants, dont NVCC, le runtime CUDA, cuBLAS, cuFFT et les outils de développement Nsight, selon VideoCardz. Guru3D rapporte le même ensemble et ajoute que les bibliothèques mathématiques de base du kit gagnent une prise en charge fonctionnelle de Windows on Arm pour ce que Nvidia appelle l'écosystème d'ordinateurs portables N1X, la plateforme à base d'Arm derrière les machines RTX Spark annoncées à Computex en juin.
Le pilote ne fait plus partie du paquet
À partir de CUDA 13.4, les programmes d'installation du SDK de Nvidia n'intègrent plus de pilote GPU. Les utilisateurs de Linux installent désormais un pilote développeur distinct (R616) depuis la page de téléchargement de Nvidia, un changement signalé en juillet dans les notes de l'aperçu développeur. Les utilisateurs de Windows étaient déjà sur une voie de pilote distincte.
Pourquoi ouvrir CUDA à Windows Arm compte
CUDA est le verrouillage le plus solide de Nvidia. Des piles d'accélération concurrentes existent (ROCm et HIP d'AMD, oneAPI et SYCL d'Intel, Metal et MLX d'Apple), mais aucune ne dispose de la base installée de CUDA ni du support de bibliothèques que les cadres d'IA supposent par défaut. Apporter cette pile à Windows on Arm consiste moins à cocher une case qu'à étendre la forteresse à la seule catégorie de PC où le logiciel de Nvidia n'était pas nativement présent.
Cela compte parce que la base de développeurs sur PC Arm est enfin assez large pour justifier de telles compilations. La série M d'Apple a banalisé les ordinateurs portables Arm pour le travail créatif et scientifique, la gamme Snapdragon X de Qualcomm a poussé Windows on Arm vers le grand public, et Microsoft a passé des années à améliorer ses outils Arm64 et son ABI de traduction Arm64EC. Chacune de ces machines pouvait faire tourner un système d'exploitation Arm, mais une application CUDA compilée uniquement pour x86 n'obtenait aucune accélération GPU dessus. Windows on Arm avait une histoire en matière de CPU et de graphiques intégrés, mais aucune voie propriétaire vers la plateforme de calcul de Nvidia.
Nvidia synchronise le logiciel avec son propre silicium. RTX Spark, la plateforme PC à base d'Arm de l'entreprise, associe des cœurs de CPU Grace à un GPU dérivé de Blackwell. Les recommandations de Nvidia à ses développeurs invitent les équipes à commencer le portage dès maintenant sur le matériel Windows on Arm qu'elles possèdent déjà, puis à valider sur RTX Spark une fois les systèmes et pilotes commercialisés disponibles. Livrer la chaîne d'outils avant le matériel est l'inverse du schéma qui a coulé les vagues précédentes de Windows on Arm, lorsque les machines arrivaient avec des logiciels qui n'avaient pas été recompilés pour elles.
Rubin arrive en aperçu, pas en produit
Le second titre est Rubin. CUDA 13.4 ajoute ce que Nvidia appelle une « prise en charge fonctionnelle de l'architecture NVIDIA Rubin (capacité de calcul 107) en tant qu'aperçu », permettant aux développeurs de compiler et de tester face à cette architecture avant que « la prise en charge CUDA de Rubin n'atteigne la disponibilité générale dans une version future de CUDA Toolkit ».
Le mécanisme est concret et facile à manquer. Le compilateur de Nvidia gagne une cible SM_107, et le jeu d'instructions PTX mis à jour inclut certaines capacités de Rubin, ce qui signifie que les bibliothèques et les cadres peuvent dès maintenant produire des binaires prêts pour Rubin et des pipelines d'intégration continue. Hardware Premium explicite la même distinction : Rubin dans la 13.4 est un aperçu fonctionnel, la disponibilité générale étant réservée à un kit ultérieur.
Un aperçu n'est pas une disponibilité générale
La prise en charge de Rubin ici est un aperçu développeur. Aucun matériel Rubin commercialisé ne la sous-tend, les notes de version de Nvidia décrivent l'aperçu comme un logiciel de pré-version, et l'entreprise déconseille explicitement d'utiliser les versions d'aperçu pour la production, la certification ou les benchmarks. Traitez tout chiffre de performance précoce de Rubin avec la même méfiance qu'une bêta de juillet.
Pour la feuille de route, le signal porte sur le séquencement plutôt que sur la vitesse. La prise en charge CUDA accompagne normalement une nouvelle architecture au moment ou près de son lancement, de sorte qu'un aperçu plusieurs mois avant la disponibilité générale donne une longueur d'avance aux mainteneurs de bibliothèques, aux auteurs de cadres et à la longue traîne habituelle d'applications CUDA. Il indique aussi au marché autour de quelle architecture Nvidia veut aligner l'écosystème ensuite, à un moment où ses composants actuels pour centres de données montent encore en puissance.
MPS V3 et le problème du GPU partagé
La version modernise aussi Multi-Process Service, le mécanisme qui permet à plusieurs processus de partager un même GPU sans simplement les sérialiser. MPS V3 remplace l'ancien modèle de contrôle par une interface en ligne de commande scriptable, des instances de serveur nommées et des espaces de noms pour organiser les charges de travail concurrentes. Elle ajoute la configuration TOML, des contrôles de partitionnement des multiprocesseurs de streaming et des limites de mémoire GPU intégrées aux cgroups.
L'effet pratique est un partitionnement programmatique : la performance de calcul, les frontières de mémoire et la priorité d'exécution peuvent toutes être définies par configuration plutôt qu'arrangées à la main. Pour les environnements conteneurisés et orchestrés, où plusieurs locataires ou tâches peuvent vouloir le même accélérateur, c'est la différence entre un partage au mieux et un isolement opposable. Nvidia le présente comme un moyen d'augmenter l'utilisation sans renoncer aux garanties de ressources, et oriente les développeurs vers un nouveau guide de démarrage rapide MPS V3.
D'autres ajouts plus modestes visent le même problème de déplacement et de placement efficaces des données. CUDA Compute Fabric Transport propose une API centrée sur le transport pour que les bibliothèques de communication déplacent des données à travers les fabric NVLink à l'aide de points de terminaison logiques nommés et d'opérations asynchrones put, get et de réduction, plutôt que de mapper chaque allocation distante dans l'espace d'adressage d'un processus. Les domaines de localité exposent des groupes de SM et de mémoire d'appareil qui peuvent être co-localisés, et une nouvelle API d'interrogation de la résidence de la mémoire unifiée, cudaMemGetLocationInfo, permet au code sensible aux performances de voir où se trouve réellement la mémoire gérée avant de planifier le travail.
Bibliothèques, Python et profilage
Les composants secondaires ont aussi été mis à jour. cuBLAS améliore la performance en double précision grâce à une émulation en virgule fixe utilisant le schéma Ozaki-II, et cuBLASLt gagne une planification dynamique pour les charges Grouped GEMM sur les GPU Blackwell pour centres de données, destinée aux motifs à nombreux groupes courants dans les modèles de mélange d'experts. CCCL 3.4 livre un cub::DeviceScan spécialisé par warp pour Blackwell qui, selon Nvidia, atteint jusqu'à 92 % d'utilisation de la bande passante mémoire, contre environ 50 % dans l'implémentation précédente, ainsi que des API CUB à appel unique et des algorithmes parallèles de la bibliothèque standard C++ sous une politique cuda::execution::gpu.
CUDA Python s'étend dans deux directions. cuda.core 1.1.0 ajoute la programmation de textures et de surfaces, la mémoire gérée sensible à NUMA, des flux de travail de graphes plus riches et des stubs de type .pyi qui donnent aux EDI et aux agents de codage de vraies signatures. cuda.compute 1.1 ajoute la compilation anticipée des algorithmes CCCL pour plusieurs architectures GPU, avec des artefacts sérialisés qui peuvent être livrés et désérialisés sur le matériel cible sans recompilation.
Côté outils, Nsight Systems 2026.5.1 ajoute la prise en charge de CUDA 13.4, des GPU Rubin et de Windows on Arm, et comporte une longue liste d'ajouts au profilage : jeux de métriques CPU, traçage des formes PyTorch, recettes d'analyse réseau et de stockage, et un cadre de plugins qui peut s'initialiser avant le démarrage d'une application. Nsight Python 1.0 automatise le profilage de noyaux depuis un script Python, et Nvidia propose aussi une couche d'IA, dont un serveur CUDA MCP hébergé qui connecte les agents de codage à la documentation CUDA.
Nvidia ne vend pas ici un GPU plus rapide. Elle vend de la portée : une chaîne d'outils CUDA qui peut désormais cibler les ordinateurs portables Arm vers lesquels son silicium se dirige, et un compilateur qui distingue déjà l'architecture d'après-demain.
Réserves et ce qu'il faut surveiller
La réserve évidente est que l'essentiel relève des fondations. CUDA 13.4 ne rendra pas un GPU existant plus rapide, et la prise en charge de Windows on Arm est un investissement de plateforme dont le retour dépend d'un matériel pas encore en rayon. L'aperçu de juillet comportait des aspérités que Nvidia a documentées pour les développeurs, notamment des transferts plus lents via la mémoire paginable et, dans certains flux de compilation PyTorch, des délais d'attente GPU ou des redémarrages système. La version en disponibilité générale de septembre est celle destinée à être utilisée, mais l'écosystème qui l'entoure, de cuDNN aux wheels de cadres, prendra du temps à se mettre en place.
L'aperçu de Rubin mérite sa propre mise en garde. La prise en charge en aperçu permet au code de se compiler et de s'exécuter là où les pilotes et un matériel compatible le permettent, mais il ne s'agit pas d'un lancement, et Nvidia ne s'est pas engagé sur une date de disponibilité générale. Quiconque lit un benchmark issu de versions d'aperçu doit supposer que les chiffres ne sont pas représentatifs, ce que les conditions d'aperçu de Nvidia indiquent précisément.
Les prochains points à suivre sont concrets. Premièrement, savoir si les premiers systèmes RTX Spark arrivent avec la pile CUDA que ce kit active, puisqu'une chaîne d'outils en avance sur son matériel ne rapporte que si le matériel suit. Deuxièmement, la vitesse à laquelle les principaux cadres publient des wheels Windows Arm64 qui l'utilisent, le véritable test pour savoir si « CUDA sur Windows on Arm » devient une option quotidienne ou reste un aperçu développeur en pratique. Troisièmement, le passage de Rubin de l'aperçu à la disponibilité générale, qui marquera le point où la chaîne d'outils de l'architecture est considérée comme stable. Pour l'instant, le logiciel est prêt avant le silicium, et cet ordre est délibéré.
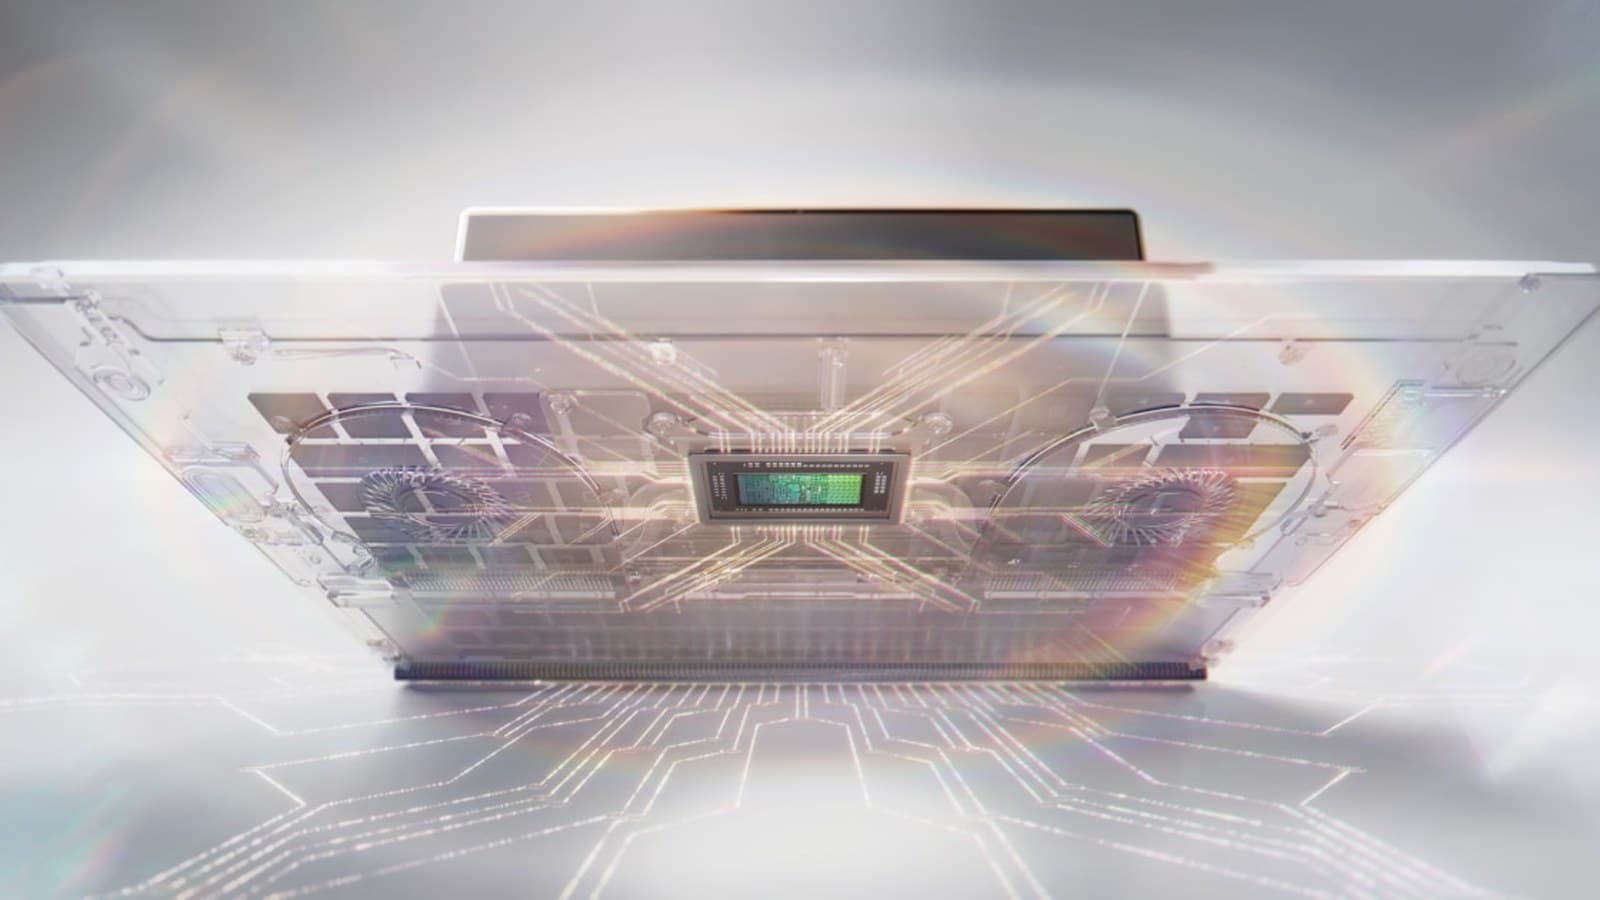
Image de couverture : rendu produit officiel de la Nvidia RTX Spark (ressource produit distribuée par l'entreprise depuis nvidia.com), recadré en 16:9.
Image de couverture : rendu officiel par Nvidia de l'ordinateur portable RTX Spark. Image : Nvidia.
Étiquettes

TPW Editorial
Rédaction
L'équipe éditoriale de TechPastWeek enquête et édite chaque article publié. Chaque sujet est recoupé avec des sources primaires et secondaires fiables, et un éditeur le relit avant publication.