Moonshots Kimi K3 erreicht Amazon Bedrock mit Prompt-Caching für offene Gewichte
Amazon Web Services nahm Moonshot AIs Kimi K3 am 18. September 2026 in Bedrock auf, als das erste Open-Weight-Modell dort mit explizitem Prompt-Caching.

Auf dieser Seite
Die wichtigsten Punkte
- Amazon Web Services machte Moonshot AIs Kimi K3 am 18. September 2026 auf Amazon Bedrock allgemein verfügbar.
- Moonshot bezeichnet Kimi K3 als erstes offenes Modell mit 2,8 Billionen Parametern, mit nativer Vision und einem Kontextfenster von 1.048.576 Token.
- Kimi K3 ist das erste Open-Weight-Modell auf Bedrock mit explizitem Prompt-Caching, bei dem ein zwischengespeicherter Prefix von mindestens 1.024 Token mindestens 30 Minuten lang vorgehalten wird.
- Das Modell wird über ein US-Geo-Profil (us.moonshotai.kimi-k3) für Datenresidenz und ein globales Profil (global.moonshotai.kimi-k3) angeboten, das an jede unterstützte kommerzielle Region weiterleitet und rund 10 Prozent günstiger ist.
- Die Ankündigung von AWS stützt sich auf Moonshots eigene Angaben; unabhängige Benchmark-Daten und Cache-Preise wurden nicht veröffentlicht.
Am 18. September 2026 teilte Amazon Web Services mit, dass Kimi K3, das neueste Modell von Moonshot AI, auf Amazon Bedrock allgemein verfügbar ist. AWS positionierte es für Coding- und Wissensarbeit und hob ein Detail als Premiere hervor: Kimi K3 ist das erste Open-Weight-Modell auf Bedrock, das explizites Prompt-Caching unterstützt.
Zum Weiterlesen: OpenAI erklärt, eine Kampagne zur Extraktion von Schlussfolgerungen mit Verbindung zu Moonshot-AI-Umfeld vereitelt zu haben · Mixture of Experts, erklärt: Warum die größten KI-Modelle nur einen Teil von sich aktivieren.
Der Maßstab ist die Schlagzeile. Moonshot beschreibt Kimi K3 als sein leistungsfähigstes Modell und als erstes offenes Modell, das 2,8 Billionen Parameter erreicht. Das Modell bringt native Vision und ein Kontextfenster von 1.048.576 Token mit, was laut Unternehmen für lange Coding-Sitzungen über große Repositories und für Arbeit mit mehreren Dokumenten einschließlich gescannter Seiten und Screenshots geeignet ist.
Moonshot zufolge erreicht Kimi K3 eine rund 2,5-mal bessere Skalierungseffizienz als Kimi K2. AWS wiederholt diese Angabe und fügt keine eigene unabhängige Messung hinzu.
Was Kimi K3 ist
Kimi K3 erschien erstmals im Juli 2026 über Moonshots eigene Produkte: die Kimi-App, die Desktop-App Kimi Work, das Terminalwerkzeug Kimi Code und die API des Unternehmens. Moonshot zufolge wurden die Gewichte bis zum 27. Juli veröffentlicht. Die Bedrock-Aufnahme gibt dem Modell einen verwalteten Vertriebskanal neben diesen direkten Wegen und ergänzt ein Bedrock-Portfolio, das bereits Kimi K2.5 und Kimi K2 Thinking enthält.
Die Architektur macht das Modell ungewöhnlich. Laut Moonshots GitHub-Modellkarte ist Kimi K3 ein Mixture-of-Experts-Design: 2,8 Billionen Parameter insgesamt, von denen 104 Milliarden pro Token aktiviert werden. Es hat 93 Schichten und 896 Experten, wobei pro Token 16 ausgewählt werden plus zwei geteilte Experten. Der Attention-Stack kombiniert KDA mit Gated MLA, und die Vision läuft über einen MoonViT-V2-Encoder mit 401 Millionen Parametern. Die Gewichte liegen in MXFP4 mit MXFP8-Aktivierungen vor.
"the world's first open 3T-class model" — Moonshot AI, Kimi-K3-Modellkarte
Wie ein Mixture-of-Experts-Modell seine Geschwindigkeit erhält: In einem sparse MoE-Design wird jeder Token nur an einen kleinen Teil des Netzwerks geleitet. Kimi K3 aktiviert 104 Milliarden seiner 2,8 Billionen Parameter für jeden einzelnen Token, sodass der Rechenaufwand pro Token viel näher an einem Modell mit 100 Milliarden Parametern liegt als an den vollen 2,8 Billionen. Die Gesamtzahl der Parameter bestimmt die Kapazität; die aktivierte Zahl treibt die Betriebskosten.
Dieser Unterschied ist wichtig für alle, die die Zahl von 2,8 Billionen als Näherung für die Kosten lesen. Ein dichtes Modell dieser Größe ließe sich im großen Maßstab kaum betreiben. Ein sparse Modell ist weiterhin anspruchsvoll, aber die Zahl, die die Inferenzkosten vorhersagt, sind die 104 Milliarden pro Token aktivierten Parameter, plus der Speicher, der für den vollständigen Gewichtssatz nötig ist.
Was Bedrock hinzufügt
Kimi K3 auf einem Hyperscaler zu platzieren, verändert mehr die umgebende Maschinerie als das Modell selbst. AWS zufolge läuft das Modell innerhalb derselben Sicherheitsgrenze wie die proprietären Modelle, mit denselben Kontrollen für Zugriff, Verschlüsselung und Auditing über das Modellportfolio eines Kunden hinweg. Für Unternehmen, die Open-Weight-Modelle prüften und Bedenken bei Beschaffung, Protokollierung und Compliance hatten, ist diese Verpackung oft der entscheidende Faktor.
Das Prompt-Caching ist die technischere Ergänzung. Der explizite Modus von Bedrock erlaubt es Entwicklern, das genaue Ende eines wiederverwendbaren Prompt-Prefix nach mindestens 1.024 Token zu markieren, indem ein prompt_cache_breakpoint an unterstützten Eingabeinhalten angebracht wird. Die in den Cache geschriebenen Token werden beim Schreiben teurer abgerechnet, bleiben aber mindestens 30 Minuten im Cache. Spätere Anfragen, die zum Prefix passen, erhalten vergünstigte Input-Preise und zählen nicht mehr gegen die Input-Token-pro-Minute-Kontingente.
Für lang laufende Coding- oder Agent-Workloads passt dieses Muster genau. Repository-Anweisungen, Werkzeugdefinitionen und Referenzdokumente sind über Aufrufe hinweg meist identisch, sodass ihr Caching wiederholte Input-Kosten und Latenz vermeidet. AWS veröffentlichte keine genauen Cache-Preise, was die Einsparungen schwer kalkulierbar macht, bevor eine Rechnung eintrifft.
Caching dieser Art ist zu einem Wettbewerbsmerkmal unter Modellanbietern geworden, weil es den Teil der Agenten-Inferenz angreift, der mit der Wiederholung statt mit der Aufgabengröße skaliert. Wenn ein Agent bei jedem Schritt eines langen Laufs dasselbe Repository oder Richtliniendokument erneut liest, kann die Input-Seite der Rechnung die Output-Seite weit übersteigen. Ein Cache-Breakpoint lässt den Anbieter das Schreiben dieses Prefix einmal berechnen und dann einen niedrigeren Satz für jede Wiederverwendung, was die Stückkosten eines Workflows verändert, der sich sonst kaum automatisieren ließe.
Zwei regionsübergreifende Inferenzprofile stehen zur Wahl. us.moonshotai.kimi-k3 hält die Inferenz für Anforderungen an die Datenresidenz innerhalb der Vereinigten Staaten. global.moonshotai.kimi-k3 leitet eine Anfrage an jede unterstützte kommerzielle AWS-Region weiter und kostet laut TPS Report rund 10 Prozent weniger. Der Kompromiss liegt zwischen rechtlicher Kontrolle und Preis, und AWS überlässt die Wahl dem Kunden.
Wo man es findet: Kimi K3 ist in der Bedrock-Konsole unter Test > Playground erreichbar oder programmatisch über den bedrock-runtime-Endpunkt. Bedrock stellt es über die nativen APIs Invoke und Converse sowie über OpenAI-kompatible Responses- und Chat-Completions-APIs bereit. Die OpenAI-kompatible Oberfläche ist es, die Werkzeuge wie die Kimi Code CLI mit einer geänderten Basis-URL auf Bedrock richten lässt.
Die Ökonomie offener Gewichte
Kimi K3 ist der jüngste Eintrag in einer Portfolio-Verschiebung bei Bedrock. Seit 2025 hat der Dienst Open-Weight-Modelle von DeepSeek, Google, MiniMax, Mistral AI, Moonshot AI, NVIDIA, OpenAI und Qwen aufgenommen. 2026 legte AWS Plattformfunktionen darüber: Tool-Calling, strukturierte Ausgabe, Reasoning, Response-Streaming sowie die Responses- und Chat-Completions-APIs. Neue Open-Weight-Modelle erben diese Funktionen, statt pro Modell Integrationsarbeit zu erfordern.
Was AWS nicht gesagt hat: Die Ankündigung beschreibt Kimi K3 mit Moonshots eigener Sprache und eigenen Zahlen, wie Unite.AI ebenfalls anmerkte. AWS veröffentlichte keine unabhängigen Benchmark-Ergebnisse für Coding, Reasoning oder Vision und legte keine Preise für Cache-Schreiben oder Cache-Lesen offen. Behandeln Sie die Fähigkeits- und Effizienzangaben als Herstellerangaben, bis Dritte das Modell testen.
Offene Gewichte werden leicht als Open Source oder als kostenlos missverstanden. Beides sind sie nicht. Veröffentlichte Gewichte lassen andere das Modell herunterladen, feinabstimmen und selbst hosten, vorbehaltlich der Lizenz, die Moonshot beifügt. Sie senken nicht die Kosten für den Betrieb eines so großen Modells. Ein sparse Modell mit 2,8 Billionen Parametern braucht weiterhin erheblichen Beschleunigerspeicher und einen Serving-Stack, und genau dieses Problem soll ein verwalteter Endpunkt wie Bedrock auffangen.
Die Ökonomie offener Gewichte hat sich in den vergangenen Jahren verschoben. Für die meisten Teams ist das Selbsthosting eines Modells der Frontier-Klasse teurer als der Bezug von API-Zugang, und der eigentliche Nutzen offener Gewichte ist Optionalität: die Möglichkeit, zwischen Anbietern zu wechseln, feinabzustimmen oder Daten in einer kontrollierten Umgebung zu halten. Bedrocks Version dieser Geschichte besagt, dass ein Kunde ein Moonshot-Modell unter demselben Governance-Dach wie Anthropics oder Amazons eigene Modelle nutzen kann.
Prompt-Caching passt zu dieser kommerziellen Logik. Inferenzanbieter konkurrieren teilweise über die Input-Token-Kosten für Agenten-Workloads, die bei jedem Schritt großen Kontext erneut senden. Explizites Caching anzubieten, selbst ohne veröffentlichte Sätze, signalisiert, dass AWS erwartet, dass Kimi K3 in langen, repetitiven, werkzeuglastigen Sitzungen statt im Einmal-Chat genutzt wird.
Der Markt für offene Gewichte ist an der Spitze auch dichter geworden. Modelle in der Größenordnung von Hunderten Milliarden Parametern sind inzwischen Routine, und eine Veröffentlichung mit 2,8 Billionen Parametern hebt die Obergrenze dessen, was ein herunterladbares Modell für sich beanspruchen kann. Diese Größe hat eine praktische Folge: Weniger Organisationen können sie selbst betreiben, was auch die Nutzung offener Gewichte in Richtung verwalteter Endpunkte verschiebt und die Cloud-Distribution wertvoller statt weniger wertvoll macht. Das Paradox eines großen offenen Modells ist, dass seine Größe es stärker von den Plattformen abhängig machen kann, die es hosten.
Nennenswerte Vorbehalte
Die Lücke zwischen Ankündigung und verifizierter Leistung ist groß. Moonshots Parameterzahl, die Effizienzangabe von 2,5x und die Formulierung "first open 3T-class model" stammen vom Unternehmen selbst. Moonshot hat für diese Veröffentlichung keine unabhängigen Bewertungen Dritter vorgelegt, und AWS liefert keine. Die Parameterzahl ist kein Benchmark; sie sagt nichts darüber aus, wie das Modell im Vergleich zur Konkurrenz programmiert, schlussfolgert oder Dokumente liest.
Auch das Preisbild ist unvollständig. Input- und Output-Token-Sätze stehen auf der Bedrock-Preisseite, aber die Sätze für Cache-Schreiben und Cache-Lesen wurden im Startmaterial nicht veröffentlicht. Ohne sie lässt sich die beworbene Caching-Funktion nicht in eine Kostenschätzung überführen, was für die langkontextigen Workflows zählt, auf die das Modell zielt.
Auch der Vertriebsaspekt zählt. Moonshot ist ein chinesisches Labor, und westliche Unternehmen wägen Herkunft und Lizenzbedingungen zunehmend ab, wenn sie ein Foundation-Modell wählen. "Open Weight" bedeutet nicht, dass die Lizenz uneingeschränkt ist, und Teams, die eine Feinabstimmung oder einen Weiterverkauf planen, sollten die Bedingungen lesen, statt eine permissive Nutzung anzunehmen.
Worauf man achten sollte
Drei Dinge würden aus einer Ankündigung eine Entscheidung machen. Erstens veröffentlichte Cache-Preise, mit denen Teams die Kosten der Agenten-Workloads modellieren könnten, für die die Funktion gebaut ist. Zweitens Benchmarks Dritter zu Coding und Langkontext-Retrieval, die Moonshots Angaben gegen bereits auf Bedrock verfügbare Modelle prüfen würden. Drittens Signale der Akzeptanz, etwa ob Coding-Werkzeuge und Agenten-Frameworks Kimi K3 als erstklassige Option aufnehmen oder als einen weiteren Endpunkt behandeln.
Die weitere Frage ist, ob die Hyperscaler-Distribution zum Standardweg für große Open-Weight-Modelle wird. Wenn ein Modell sowohl als herunterladbare Gewichte als auch als gouvernanter Cloud-Dienst verfügbar ist, gewinnt der Cloud-Dienst oft bei Unternehmenskäufern, die Beschaffung und Audit über Kontrolle stellen. Folgt Kimi K3 diesem Muster, entscheidet über seine Akzeptanz jener Teil des Starts, den AWS noch nicht bepreist hat: der Cache-Zähler.
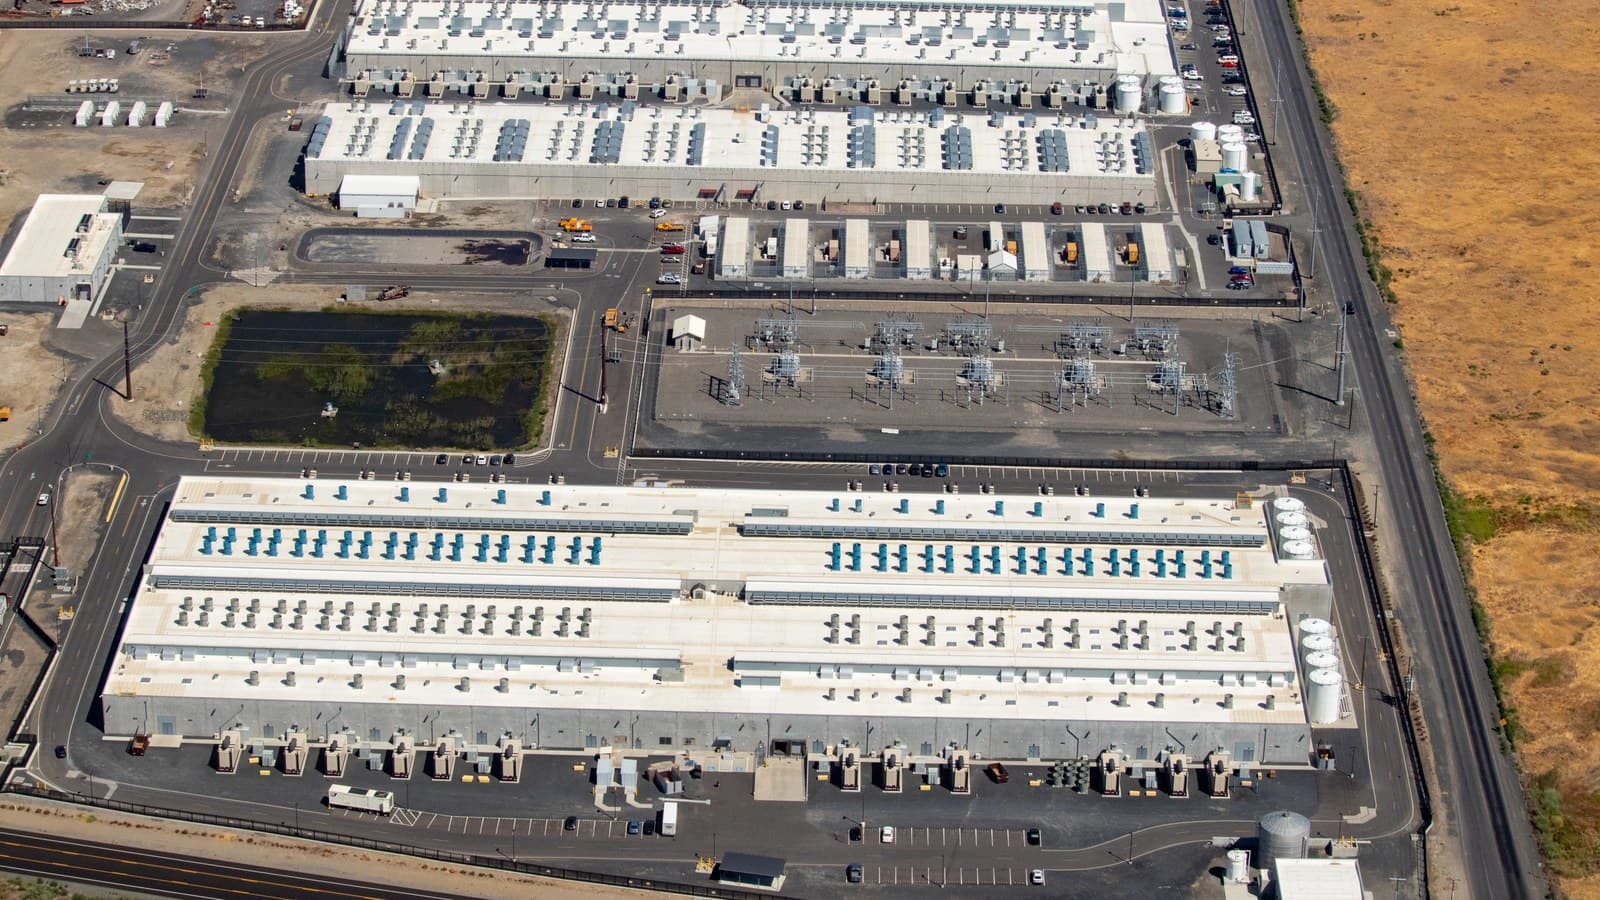
Titelbild: Amazon-AWS-Rechenzentrum in us-west-2, "Amazon AWS us-west-2 beach AZ.jpg" von Tedder über Wikimedia Commons, lizenziert unter CC BY-SA 4.0 (auf 16:9 zugeschnitten).
Tags
Häufige Fragen
- Was ist Kimi K3?
- Kimi K3 ist ein großes Open-Weight-Modell von Moonshot AI. Moonshot beschreibt es als sein leistungsfähigstes Modell und als erstes offenes Modell mit 2,8 Billionen Parametern, mit nativer Vision und einem Kontextfenster von rund einer Million Token.
- Was ist explizites Prompt-Caching auf Amazon Bedrock?
- Entwickler können einen wiederverwendbaren Prompt-Prefix nach mindestens 1.024 Token mit einem prompt_cache_breakpoint markieren. Zwischengespeicherte Token werden beim Schreiben teurer abgerechnet, aber mindestens 30 Minuten vorgehalten, und passende spätere Anfragen erhalten vergünstigte Input-Preise und zählen nicht mehr gegen die Input-Token-pro-Minute-Kontingente.
- Wie greift man auf Kimi K3 in Amazon Bedrock zu?
- Über zwei regionsübergreifende Inferenzprofile: us.moonshotai.kimi-k3 für US-Datenresidenz oder global.moonshotai.kimi-k3, das an jede unterstützte kommerzielle Region weiterleitet und rund 10 Prozent günstiger ist. Es ist im Bedrock-Konsolen-Playground und über den bedrock-runtime-Endpunkt verfügbar.
- Ist Kimi K3 kostenlos, weil es offene Gewichte hat?
- Nein. Offene Gewichte bedeuten, dass die Modellgewichte veröffentlicht sind, aber der Betrieb eines Modells mit 2,8 Billionen Parametern erfordert weiterhin erhebliche Rechenleistung, und auf Bedrock ist es ein kostenpflichtiger Dienst mit Preisen pro Input- und Output-Token.

TPW Editorial
Redaktion
Die Redaktion von TechPastWeek recherchiert und betreut jeden veröffentlichten Artikel. Jede Geschichte wird anhand von Primär- und glaubwürdigen Sekundärquellen geprüft und vor der Veröffentlichung redaktionell freigegeben.