SpaceXAI liefert Grok 4.7 fürs Coden zu Grok-4.6-Preisen, mit passenden Hersteller-Benchmarks
SpaceXAI veröffentlichte Grok 4.7 am 21. September 2026 und nennt es sein bisher fähigstes Coding-Modell, mit denselben Token-Preisen von 2 $ und 6 $ wie Grok 4.6.


Auf dieser Seite
Die wichtigsten Punkte
- SpaceXAI veröffentlichte Grok 4.7 am 21. September 2026 und beschreibt es als sein fähigstes Modell fürs Coden und für Wissensarbeit, mit denselben 2 $ pro Million Eingabe-Token und 6 $ pro Million Ausgabe-Token wie Grok 4.6.
- Das Modell nutzt ein größeres Basismodell und einen längeren Reinforcement-Learning-Lauf als Grok 4.6, und SpaceXAI zufolge prüft es bei langen Aufgaben seine eigene Arbeit sorgfältiger.
- SpaceXAI meldet CursorBench 4.0 mit einem Anstieg von 40,4 % auf 46,3 % und Terminal-Bench 4.0 von 20,3 % auf 38,0 %, beides Herstellerangaben, die nicht unabhängig überprüft wurden.
- Unabhängige Messungen zeichnen ein vorsichtigeres Bild: Der Artificial Analysis Intelligence Index setzt Grok 4.7 auf 46, hinter Claude Fable 5.1 und GPT-6 mit 53.
- Grok 4.7 ist über Cursor, Grok Build, die Grok-API und Drittanbieter-Gateways verfügbar, aber noch nicht in der Consumer-Grok-App oder der kostenlosen Stufe.
SpaceXAI veröffentlichte Grok 4.7 am 21. September 2026 und nannte es das bisher fähigste Modell des Unternehmens fürs Coden und für Wissensarbeit. Es kommt mit denselben nominellen Token-Preisen wie sein Vorgänger, einem größeren Basismodell darunter und einer Reihe von Benchmark-Verbesserungen, die das Unternehmen selbst veröffentlichte.
Zum Weiterlesen: Grok Voice Transcribe 2.0 verspricht doppelte Genauigkeit beim gleichen Preis von 10 Cent · Anthropics Claude Haiku 5.5 ist sein bisher günstigstes kleines Modell.
Die Veröffentlichung ist Teil eines schnellen Tempos bei Elon Musks KI-Unternehmen, das im August Grok 4.6 und Tage zuvor Grok Voice Transcribe 2.0 ausgeliefert hatte. Grok 4.7 zielt direkt auf den Markt, in dem die KI-Labore am härtesten konkurrieren: Software-Engineering-Agenten, die stundenlang an einer Aufgabe arbeiten, Befehle ausführen und ihre eigene Ausgabe prüfen können.
Das Versprechen ist unkompliziert. SpaceXAI zufolge wurde Grok 4.7 mit einem längeren Reinforcement-Learning-Lauf auf einer schwierigeren Aufgabenmischung trainiert, gewichtet zu Problemen, deren Bearbeitung viele Stunden dauern kann, und es überprüft seine eigene Arbeit sorgfältiger als Grok 4.6. Die Verfügbarkeit ist breit: Cursor, Grok Build, die Grok-API, Coding-Werkzeuge von Drittanbietern und Modell-Gateways wie OpenRouter, Vercel und Cloudflare. Cursors Ankündigung bestätigte, dass das Modell am selben Tag in seinem Editor verfügbar wurde.
Der Preis ist die Strategie
Das folgenreichste Detail ist das, was sich nicht geändert hat. Grok 4.7 beginnt bei 2 $ pro Million Eingabe-Token und 6 $ pro Million Ausgabe-Token, dieselben Grundpreise, die SpaceXAI für Grok 4.6 verlangte. Zwischengespeicherte Eingaben kosten 0,50 $ pro Million Token, und Prompts ab 200.000 Token wechseln zu 4 $ pro Million Eingabe und 12 $ pro Million Ausgabe.
Diese Preisliste liegt näher an chinesischen Open-Weight-Modellen als an der westlichen Spitze. Die Topmodelle von Claude und OpenAI trugen im Allgemeinen höhere Preise pro Token, und die Linie zu halten, während die Fähigkeiten steigen, ist ein bewusster Weg, um preissensible Entwickler zu werben. The Decoder las den Preis als das klarste Signal des Starts und merkte an, dass die niedrigen Sätze wohl einen Grund haben.
SpaceXAI verkauft zudem eine schnellere Variante. Grok 4.7 Fast läuft auf schnellerer Serving-Infrastruktur und kostet das Doppelte der Standardsätze, nämlich 4 $ pro Million Eingabe und 12 $ pro Million Ausgabe. Es ist die Standardeinstellung in Cursor und Grok Build, wird aber nicht über die öffentliche API angeboten, was etwas Kontrolle darüber behält, wie die Kapazität genutzt wird.
Das Modell selbst ist auf dem Papier leistungsfähig. Es unterstützt ein Kontextfenster von 500.000 Token, einen Wissensstand von Mai 2026, Text- und Bildeingabe sowie vier Reasoning-Stufen von low bis xhigh mit high als Standard. Es kann Function Calling, Websuche, X-Suche und Codeausführung nutzen. Das sind Grundvoraussetzungen für ein Frontier-Coding-Modell, und nichts davon ist für die Klasse ungewöhnlich.
Was Sie bekommen: ein Kontextfenster von 500.000 Token, Text- und Bildeingabe, vier Reasoning-Stufen und Werkzeuge für Function Calling, Websuche, X-Suche und Codeausführung, zu 2 $ pro Million Eingabe-Token und 6 $ pro Million Ausgabe-Token für Standard-Prompts.
Herstellerzahlen und unabhängige Zahlen
Die von SpaceXAI veröffentlichten Benchmarks zeigen Zuwächse bei jedem gewählten Maß. Bei CursorBench 4.0, das längere Coding-Aufgaben belastet, erreicht Grok 4.7 46,3 Prozent gegenüber 40,4 Prozent für Grok 4.6. Bei DeepSWE v1.1 steigt es von 65,2 Prozent auf 71,0 Prozent. Der größte Sprung liegt bei Terminal-Bench 4.0, wo das Unternehmen 20,3 Prozent für Grok 4.6 und 38,0 Prozent für Grok 4.7 meldet.
Das sind Herstellerangaben, und die Lücke zwischen ihnen und unabhängigen Tests ist der wichtigste Vorbehalt der Veröffentlichung. The Decoder berichtete, dass unabhängige Ergebnisse bei Terminal-Bench 4.0 Grok 4.7 bei etwa 26 Prozent verorten, weit unter SpaceXAIs 38 Prozent und deutlich hinter GPT-6 Astra mit 60 Prozent und Claude Fable 5.1 mit 55 Prozent. Derselbe Artikel merkte an, dass selbst DeepSeek V4.1 Flash, ein günstigeres Modell, es bei diesem Maß knapp überholt.
Beim breiteren Artificial Analysis Intelligence Index, der zehn Benchmarks kombiniert, erreicht Grok 4.7 eine 46 und landet im Mittelfeld. Claude Fable 5.1 und GPT-6 führen mit je 53. Das ist kein schlechtes Ergebnis für ein Modell mit so niedrigem Preis, aber es stützt auch nicht den Anspruch eines Frontier-Anführers.
Achten Sie auf die Benchmark-Quelle: Die CursorBench-, DeepSWE- und Terminal-Bench-Zahlen von SpaceXAI sind eigene. Unabhängige Bewertungen setzen das Modell beim agentischen Coding unterhalb der Spitzenklasse an, und Hersteller- und Drittanbieterzahlen für denselben Test können um mehr als zehn Prozentpunkte abweichen.
Die Diskrepanz zählt, weil die Käufer, um die SpaceXAI wirbt, ihre eigene Bewertung vornehmen. Ein Entwickler, der zwischen Grok 4.7, Claude und GPT-6 wählt, wird eigene Aufgaben laufen lassen und Kosten, Korrekturen und Zeit bis zur Fertigstellung messen. Beim Preis konkurriert Grok 4.7 hart. Bei der rohen Coding-Fähigkeit deuten die unabhängigen Zahlen darauf hin, dass es den Anführern hinterherhinkt.
Ein voller Markt mit Platz am Preisende
Der Kontext für den Start ist ein Coding-Agenten-Markt, der sich in Stufen aufgeteilt hat. An der Spitze konkurrieren GPT-6 Astra und Claude Fable 5.1 über Fähigkeit und tragen Premium-Preise. Darunter konkurriert eine Gruppe günstigerer Modelle über das Preis-Leistungs-Verhältnis, und trotz SpaceXAIs Frontier-Rahmung sitzt Grok 4.7 in dieser Gruppe.
Diese Position ist keine schlechte. Viele Teams brauchen nicht für jede Aufgabe das absolut beste Modell, und Code-Review, Testgenerierung und routinemäßiges Refactoring sind zu einem niedrigeren Preis oft gut genug. Ein Modell, das ungefähr konkurrenzfähig und viel günstiger ist, kann einen großen Anteil der Alltagsarbeit gewinnen und die härtesten Probleme der Premium-Stufe überlassen.
Es gibt auch eine Vertriebsgeschichte. Grok 4.7 erscheint in Cursor und Grok Build zeitgleich mit der API, was es Entwicklern in den Werkzeugen präsentiert, die sie ohnehin nutzen. Modell-Router und Cloud-Gateways fügen weitere Wege hinzu, und die Breite der Verfügbarkeit verringert die Reibung, die einen Start ausbremsen kann. Die Grenze ist, dass es noch nicht in der Consumer-Grok-App oder der kostenlosen Stufe ist, sodass die breite Öffentlichkeit, die SpaceXAI über seine Social-Plattform erreicht, es noch nicht gesehen hat.
Das Rennen, in das Grok 4.7 eintritt
Coding-Agenten sind zur umkämpftesten Front der KI geworden, weil Software-Engineering der klarste Ort ist, an dem die Ausgabe eines Modells überprüft und bezahlt werden kann. OpenAIs GPT-6 Astra und Anthropics Claude Fable 5.1 stehen an der Spitze der unabhängigen Ranglisten und konkurrieren über Fähigkeit, während eine niedrigere Stufe, angeführt von günstigeren Modellen, über Preis und Volumen konkurriert. Nach der Beweislage landet Grok 4.7 in dieser niedrigeren Stufe, mit einem Frontier-Preisschild, das die Anführer scharf unterbietet.
Die Lücke zur Spitze ist in absoluten Zahlen nicht enorm. Ein Artificial-Analysis-Wert von 46 gegen 53 ist ein realer Unterschied, aber es ist die Art von Abstand, die mit jeder Modellgeneration schrumpft, und SpaceXAI hat schnell Updates veröffentlicht. Was die Stufen heute trennt, ist weniger die rohe Fähigkeit bei durchschnittlichen Aufgaben als die Zuverlässigkeit bei langen, mehrstufigen Aufträgen, bei denen ein Agent planen, handeln, Fehler überwinden und seine eigene Arbeit prüfen muss. Genau dort setzen die unabhängigen Terminal-Bench-Zahlen Grok 4.7 hinter die Konkurrenz.
Für Käufer lautet die praktische Frage nicht, welches Modell eine Rangliste gewinnt. Sie lautet, welches Modell eine gegebene Aufgabe zu akzeptablen Kosten erledigt, und das variiert von Team zu Team. Ein Modell, das etwas schwächer, aber mehrere Male günstiger ist, kann die bessere Wahl für Review, Tests und Routineänderungen sein, während die härteste Architektur- und Debugging-Arbeit bei der Premium-Stufe bleibt. Grok 4.7 ist darauf positioniert, die erste Art von Arbeit zu übernehmen, und die Breite seines Vertriebs, von Cursor bis zu den großen Gateways, ist der Weg, auf dem SpaceXAI sie gewinnen will.
Was zu beobachten ist
Die erste Frage ist, ob der niedrige Preis hält. SpaceXAI hat nicht gesagt, ob 2 $ und 6 $ pro Million Token bestehen bleiben, während die Kapazität skaliert, und die Geschichte der KI-Preise ist eine von großzügigen Starttarifen, auf die Erhöhungen folgen, sobald ein Modell etabliert ist. Käufer, die mit diesen Zahlen planen, sollten sie als aktuelles Angebot statt als dauerhafte Untergrenze behandeln.
Die zweite ist, ob sich die Fähigkeitslücke schließt. SpaceXAI hat Modelle schnell ausgeliefert, und jede Überarbeitung war besser als die letzte. Nähern sich die unabhängigen Benchmarks den Herstellerangaben an, wird der Preisvorteil von Grok 4.7 für die Premium-Stufe deutlich bedrohlicher. Bleibt die Lücke, bleibt das Modell eine Preis-Option.
Die dritte ist, wie Cursor und andere Vertriebspartner das Modell positionieren. Grok 4.7 Fast in Cursor zur Standardeinstellung zu machen, ist ein starkes Vertrauensvotum, und Standards prägen, was Entwickler nutzen. In einem populären Werkzeug die Standardeinstellung zu sein, ist mehr wert als ein Platz in einer Rangliste, weil es die Wahl für Nutzer, die das Modell nicht wechseln, vollständig aufhebt.
Für Leser, die einen Wechsel abwägen, lautet die ehrliche Zusammenfassung so: Grok 4.7 ist ein leistungsfähiges, günstiges Coding-Modell von einem Unternehmen, das sich schnell verbessert, mit Hersteller-Benchmarks, die seine Position gegenüber den Anführern überzeichnen. Teams, denen Preis und Vertrieb wichtig sind, sollten es testen. Teams, die das beste agentische Coding brauchen, sollten warten, bis die unabhängigen Ergebnisse zum Marketing aufschließen.
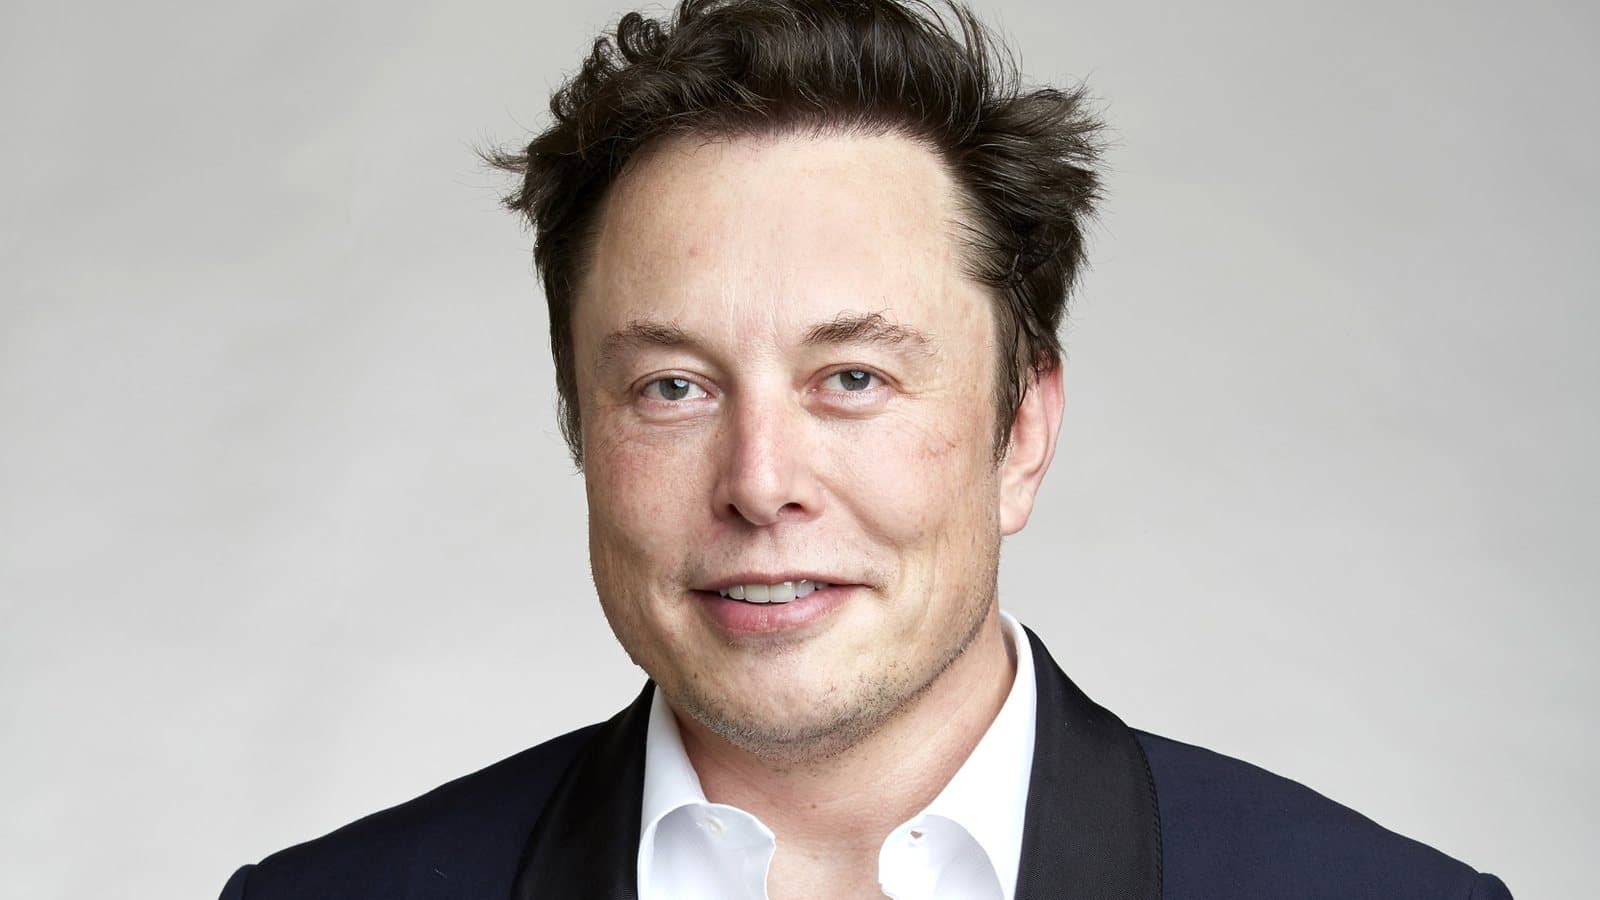
Cover: Wikimedia-Commons-Foto von Elon Musk auf einer Konferenz am 28. März 2024 von Wcamp9 (CC BY 4.0).
Tags
Häufige Fragen
- Wie viel kostet Grok 4.7?
- SpaceXAI listet Grok 4.7 mit 2 $ pro Million Eingabe-Token, 0,50 $ pro Million zwischengespeicherte Eingabe-Token und 6 $ pro Million Ausgabe-Token für Prompts unter 200.000 Token, dieselben Grundpreise wie Grok 4.6. Prompts ab dieser Größe kosten 4 $ pro Million Eingabe und 12 $ pro Million Ausgabe.
- Wo ist Grok 4.7 verfügbar?
- Es ist in Cursor, in Grok Build, über die Grok-API und über Modell-Gateways wie OpenRouter, Vercel und Cloudflare verfügbar. Noch nicht dabei sind die Consumer-Grok-App und die kostenlose Stufe, und eine schnellere Variante Grok 4.7 Fast ist auf Cursor und Grok Build beschränkt.
- Wie groß ist das Kontextfenster von Grok 4.7?
- Es unterstützt ein Kontextfenster von 500.000 Token mit einem Wissensstand von Mai 2026. Es akzeptiert Text- und Bildeingabe, unterstützt vier Reasoning-Stufen und kann Function Calling, Websuche, X-Suche und Codeausführung nutzen.
- Ist Grok 4.7 das beste Coding-Modell?
- Nach unabhängigen Tests nicht. Die eigenen Benchmarks von SpaceXAI zeigen deutliche Zuwächse gegenüber Grok 4.6, doch der Artificial Analysis Intelligence Index setzt Grok 4.7 auf 46, während Claude Fable 5.1 und GPT-6 mit 53 punkten, und unabhängige Terminal-Bench-Ergebnisse liegen deutlich unter der von SpaceXAI veröffentlichten Zahl.

TPW Editorial
Redaktion
Die Redaktion von TechPastWeek recherchiert und betreut jeden veröffentlichten Artikel. Jede Geschichte wird anhand von Primär- und glaubwürdigen Sekundärquellen geprüft und vor der Veröffentlichung redaktionell freigegeben.