La apuesta china de 100.000 GPUs: JD Cloud y Moore Threads construyen un clúster de IA nacional
JD Cloud y Moore Threads construirán un clúster de 100.000 GPUs sobre silicio chino, el primero de su escala en una gran nube nacional. El problema es el software.

En esta página
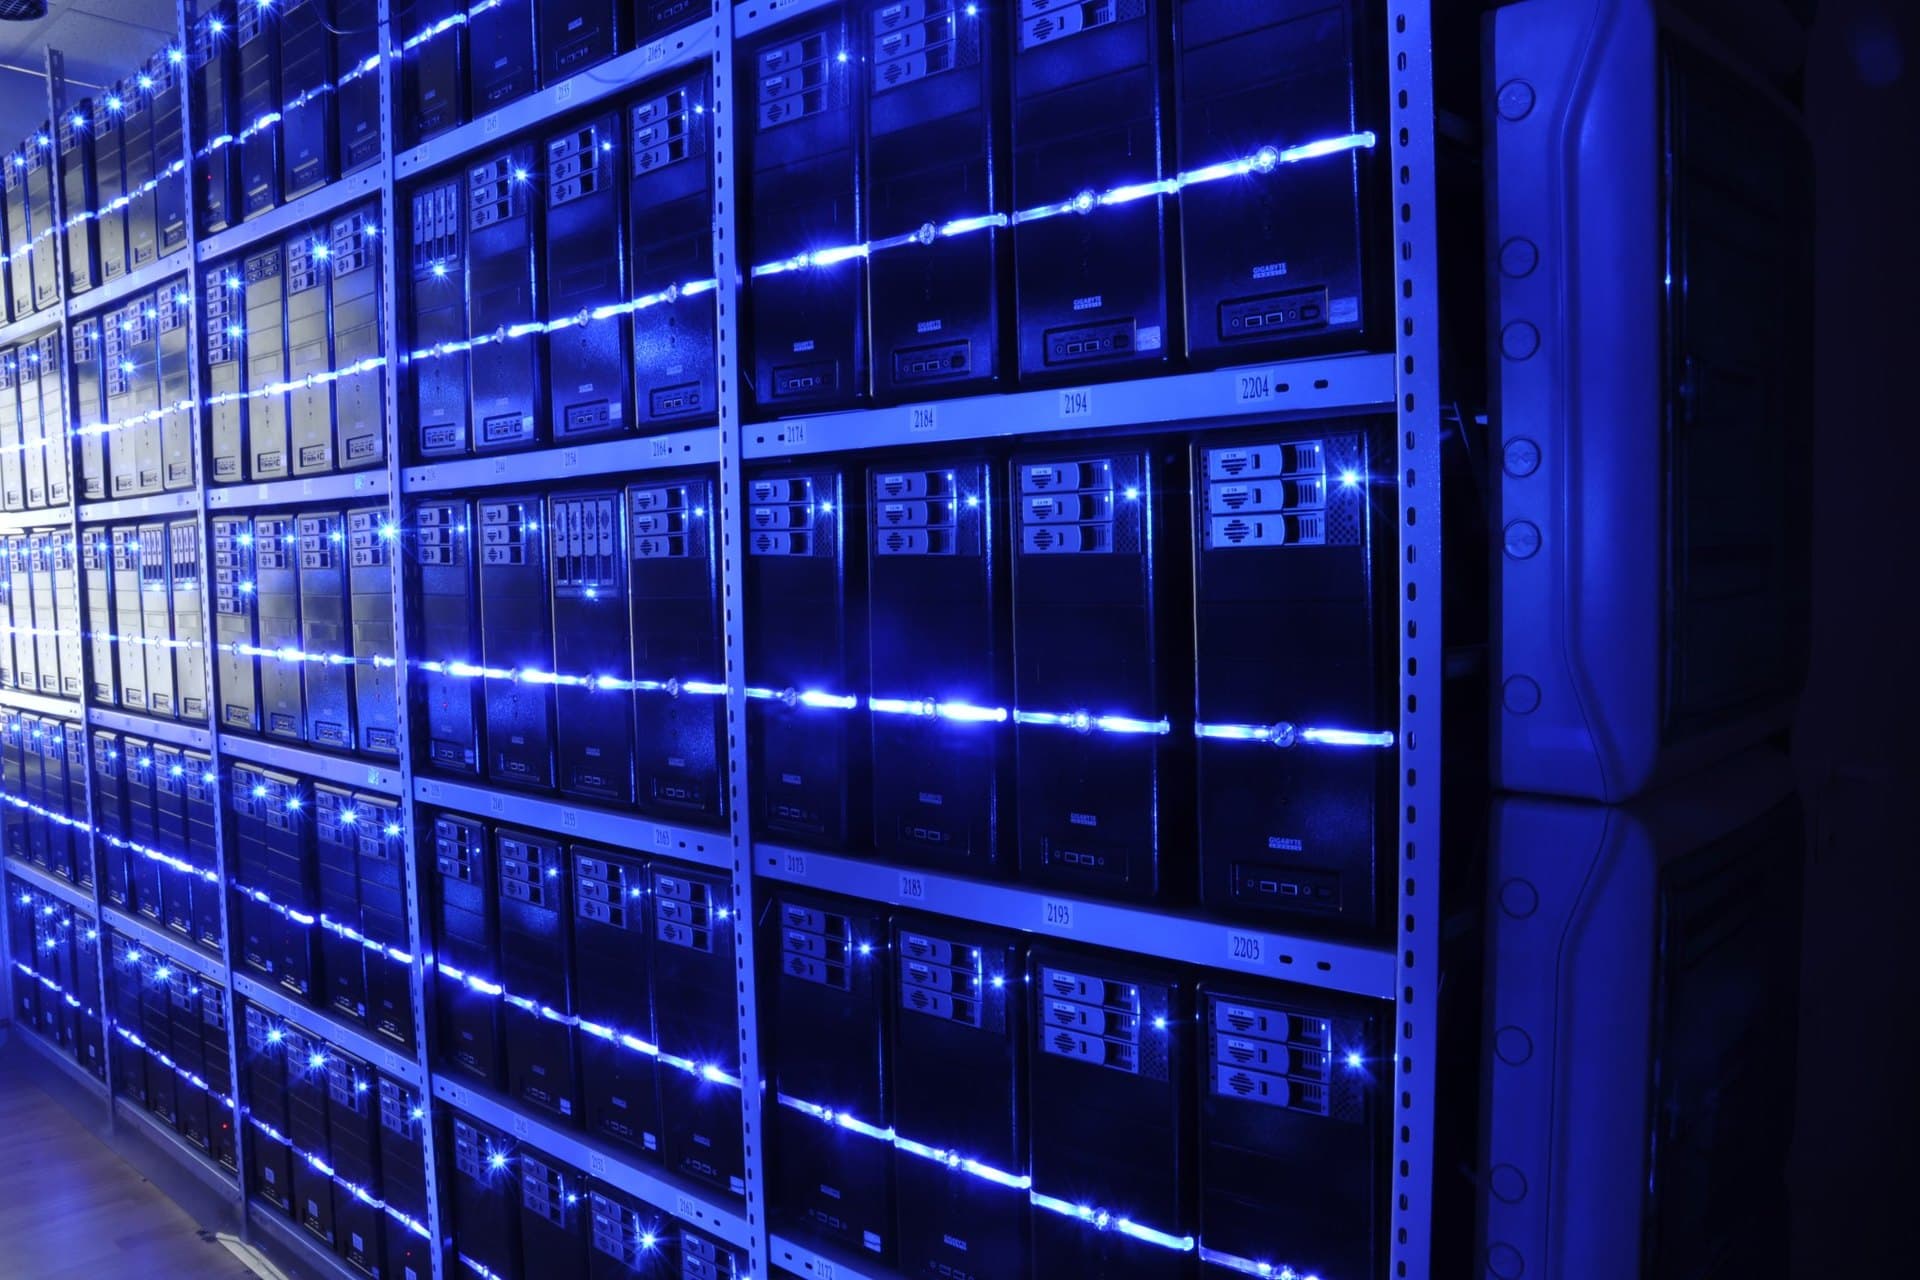
El gigante chino del comercio electrónico y la nube JD planea construir un clúster de computación con 100.000 GPUs impulsado íntegramente por silicio nacional. El proyecto, presentado en la Global Technology Explorers Conference de JD el 9 de septiembre en Pekín, une a JD Cloud con Moore Threads, uno de los diseñadores de GPUs más observados de China.
Lectura relacionada: SK Hyper cifra en 350.000 millones de dólares los primeros 5 gigavatios de su despliegue de IA · Oracle envía una notificación de fuerza mayor sobre el campus Stargate de 18.000 millones en Nuevo México.
Si se materializa tal como se describe, sería el primer clúster de este tipo alojado por un gran proveedor chino de nube de IA: un hito en la larga campaña de Pekín por construir una pila de IA que no dependa de Nvidia.
Lo que se anunció
Los números titulares son simples y los detalles, llamativamente escasos:
- 100.000 GPUs, con aceleradores "de funcionalidad completa" de Moore Threads.
- Cargas de trabajo: entrenamiento de modelos a gran escala, inferencia e inteligencia corpórea (robótica), las tres categorías que más importan a los planificadores chinos.
- Operador: JD Cloud, con centros de datos principales en Pekín, Cantón, Shanghái y Suqian.
- Antecedentes: ambas empresas ya construyeron juntas un clúster de 10.000 GPUs, así que esto es una multiplicación por diez, no un arranque en frío.
Lo que JD tampoco revela importa igual de mucho: no hay fecha de finalización, ni benchmark del clúster completo, ni despliegue en operación. El anuncio es un plan, no un sistema en marcha.
El silicio que hay debajo
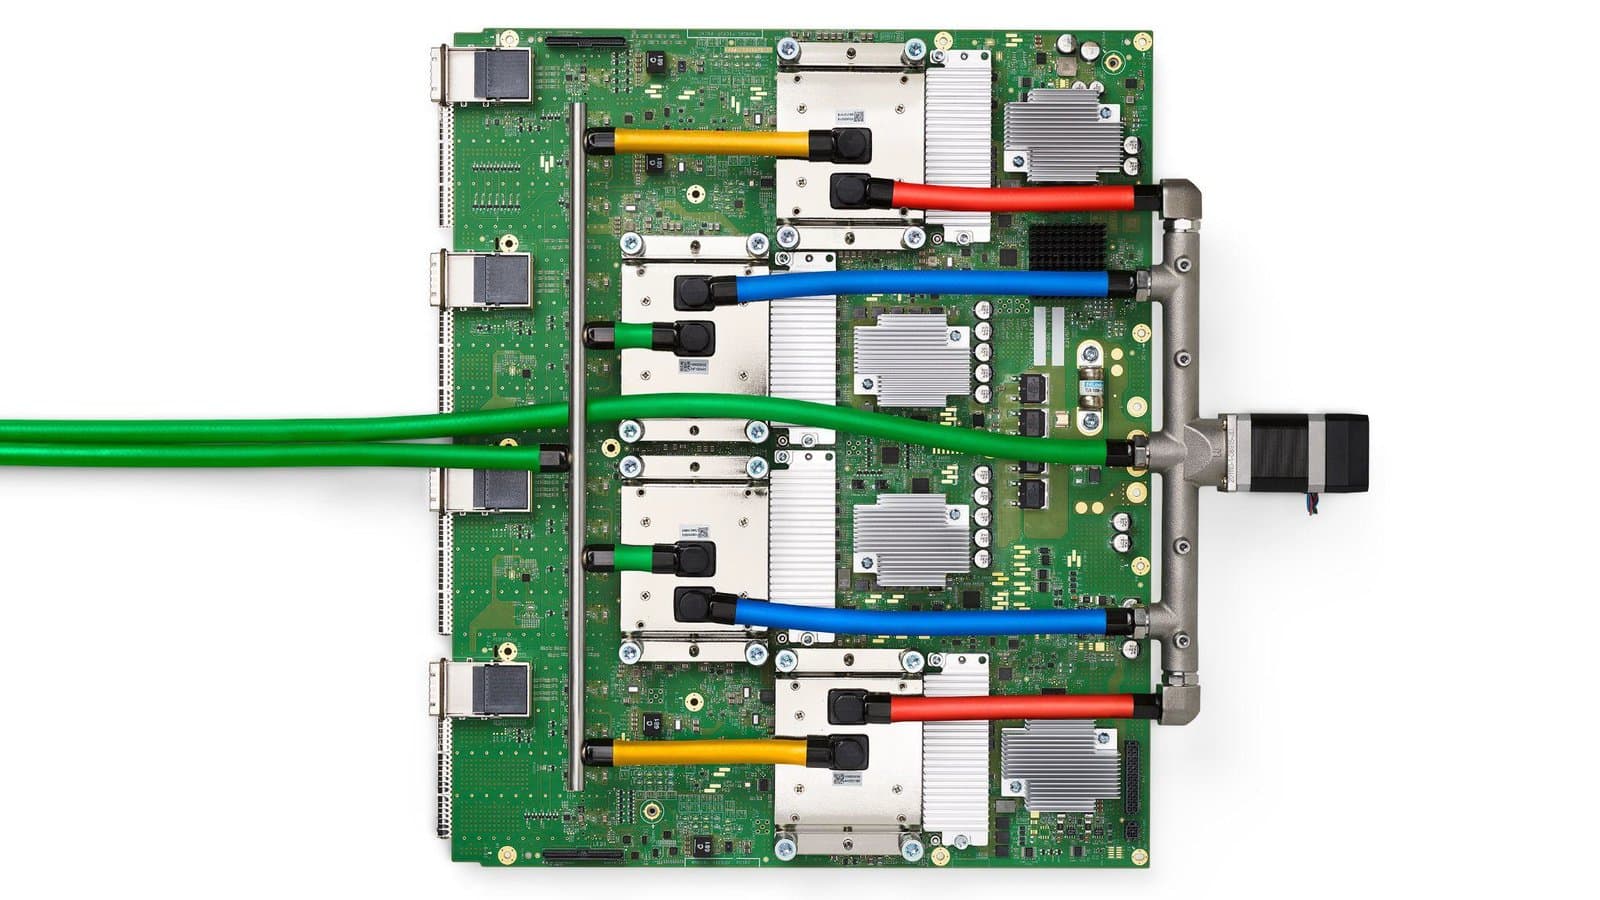
El actual buque insignia de Moore Threads es la MTT S5000, basada en el chip PH100 y la arquitectura "PingHu". La compañía promete soporte de precisión completa desde FP8 hasta FP64, el rango que importa tanto para entrenamiento como para inferencia. Los modelos más antiguos MTT S4000 y S3000 completan la oferta.
La hoja de ruta del fabricante, mostrada en su conferencia de desarrolladores a finales del año pasado, apunta a una arquitectura de nueva generación llamada "Huagang" que, según afirma, eleva la densidad de cómputo un 50 %, mejora la eficiencia energética diez veces y está diseñada explícitamente para escalar a clústeres de más de 100.000 GPUs. Sobre esa arquitectura acabaría apoyándose el clúster de JD.
Moore Threads no es un proyecto casero. Fundada en 2020 por el exejecutivo de Nvidia en China James Zhang Jianzhong, reunió capital de Sequoia China, GGV Capital y (de forma notable) ByteDance y Tencent, y cotiza en la Bolsa de Shanghái desde diciembre de 2025. También figura en la Entity List de la Oficina de Industria y Seguridad de EE. UU., lo que limita su acceso a tecnología de fabricación occidental avanzada.
Por qué ocurre ahora
La lógica es directa: los controles de exportación de EE. UU. han dificultado cada vez más la obtención de aceleradores Nvidia de gama alta en China, y Pekín ha respondido intentando fabricar su salida del problema. Todas las grandes nubes chinas están ahora bajo presión para demostrar un camino nacional para la computación de IA.
El argumento de la soberanía
Para los planificadores chinos, el objetivo de un clúster nacional de 100.000 GPUs no es solo el rendimiento, sino la resiliencia. Una cadena de suministro que puede cortarse es una cadena de suministro que puede usarse como palanca. El silicio nacional, por imperfecto que sea, es la póliza de seguro.
Los datos de mercado respaldan la ambición. Los analistas chinos proyectan que el mercado de GPUs del país superará los 1,3 billones de yuanes en 2029, mientras que la cuota de China en el mercado global de GPUs subiría del 15,6 % en 2024 hasta el 37,8 %. Es mucha demanda buscando un proveedor que no sea Nvidia.
La brecha que nadie oculta
Aquí la historia se vuelve más complicada y más honesta.
La pila de software de Moore Threads, MUSA, es el intento de la compañía de replicar lo que hace a Nvidia genuinamente dominante: CUDA. Incluso ofrece una herramienta de migración, MUSIFY, pensada para portar código CUDA a su hardware. Pero los socios entrevistados por medios chinos fueron francos: las GPUs nacionales aún están una o dos generaciones por detrás de los líderes globales tanto en rendimiento bruto como en madurez del ecosistema.
El patrón recuerda al ascenso de Huawei en telecomunicaciones: puede que los mercados occidentales nunca compren aceleradores de IA chinos, pero la demanda interna y los mercados emergentes podrían darles escala suficiente para mejorar. Si eso es un proyecto de cinco o de quince años es la pregunta abierta.
Las tres preguntas que deciden este proyecto:
  1. ¿Puede el hardware sostener entrenamiento a 100.000 GPUs
     sin colapsar por interconexión y tasas de fallo?
  2. ¿Puede MUSA abaratar tanto el portado de CUDA que los
     desarrolladores chinos dejen de verlo como un impuesto?
  3. ¿Puede la cadena de suministro entregar a escala bajo sanciones?
El panorama mayor
El anuncio llegó en la misma semana en que Nvidia intentaba comprar Hugging Face por 12.900 millones de dólares y en que Nvidia, Equinix y Together AI ampliaban la infraestructura de inferencia empresarial en Occidente. El despliegue de la IA es global y se está bifurcando: una pila anclada en Nvidia y CUDA, y una pila paralela que se ensambla en China bajo presión.
El clúster de 100.000 GPUs de JD es la señal más clara hasta ahora de hacia dónde se dirige la segunda pila. También recuerda que este tipo de anuncios son baratos, mientras que entregar clústeres a escala es brutalmente difícil.
Qué observar
Ignora por ahora el número 100.000. Espera el primer benchmark independiente de un clúster nacional terminado y observa la adopción de MUSA por parte de los desarrolladores. El silicio se puede comprar; los ecosistemas hay que ganárselos.
Etiquetas

TPW Editorial
Redacción
El equipo editorial de TechPastWeek investiga y edita cada artículo que publicamos. Cada historia se contrasta con fuentes primarias y secundarias fiables, y un editor la revisa antes de publicarse.