Nvidia abre CUDA a Windows on Arm y ofrece a los desarrolladores un avance de Rubin
El CUDA Toolkit 13.4 de Nvidia alcanza la disponibilidad general con desarrollo nativo en Windows on Arm, un avance de la arquitectura de GPU Rubin y un MPS reconstruido.

En esta página
El 9 de septiembre de 2026, Nvidia publicó el CUDA Toolkit 13.4 y, con ello, cerró una brecha que había dejado su plataforma para desarrolladores fuera de toda una clase de ordenadores. El kit amplía el desarrollo de CUDA a Windows on Arm, algo que Nvidia nunca había distribuido antes, y también abre una vía temprana hacia Rubin, la arquitectura de GPU de nueva generación de la empresa. La descarga pública es CUDA 13.4.1, que sustituye al avance para desarrolladores que Nvidia publicó en julio. (Nvidia Technical Blog, VideoCardz)
Lectura relacionada: DeepSeek libera como código abierto una pila de software para los chips Ascend de Huawei, con la vista puesta en CUDA · El DSX POD de Nvidia convierte una fábrica de IA en un contenedor marítimo.
La parte de Windows on Arm es el titular. CUDA lleva años funcionando en hardware Arm, pero solo a través de Linux, en módulos Jetson y servidores Arm64. El objetivo que faltaba era Windows Arm64 nativo, y su ausencia mantenía buena parte del stack dependiente de CUDA, desde PyTorch y TensorRT hasta herramientas profesionales de renderizado y simulación, fuera de las máquinas Windows basadas en Arm. El blog de Nvidia describe la versión como una ampliación de CUDA «a la plataforma Windows on Arm», y señala que las aplicaciones habían estado «mucho tiempo soportadas en plataformas Arm a través de Linux».
Llega una cadena de herramientas propia
Los desarrolladores tienen dos vías de entrada. Pueden compilar aplicaciones CUDA directamente en un sistema Windows Arm64, o compilar de forma cruzada para Arm64 desde el kit de Windows x86-64. Para los equipos que aún no tienen hardware Arm, la segunda ruta es la práctica, y es el mismo orden de operaciones que la industria vio hace una década, cuando los servidores Arm se presentaron por primera vez como una segunda arquitectura para los centros de datos.
Nvidia enumera compatibilidad con Windows Arm64 en componentes como NVCC, el runtime de CUDA, cuBLAS, cuFFT y las herramientas para desarrolladores Nsight, según VideoCardz. Guru3D informa del mismo conjunto y añade que las bibliotecas matemáticas centrales del kit ganan soporte funcional de Windows on Arm para lo que Nvidia llama el ecosistema de portátiles N1X, la plataforma basada en Arm detrás de las máquinas RTX Spark anunciadas en Computex en junio.
El controlador ya no viene en la caja
A partir de CUDA 13.4, los instaladores del SDK de Nvidia ya no incluyen un controlador de GPU. Los usuarios de Linux ahora instalan un Developer Driver (R616) aparte desde la página de descargas de Nvidia, un cambio que las notas del avance para desarrolladores señalaron en julio. Los usuarios de Windows ya seguían una ruta de controlador separada.
Por qué abrir CUDA a Windows Arm importa
CUDA es el mayor mecanismo de dependencia de Nvidia. Existen stacks de aceleración competidores (ROCm y HIP de AMD, oneAPI y SYCL de Intel, Metal y MLX de Apple), pero ninguno tiene la base instalada de CUDA ni el soporte de bibliotecas que los frameworks de IA dan por hecho. Llevar ese stack a Windows on Arm tiene menos que ver con marcar una casilla y más con extender la ventaja al único segmento de PC donde el software de Nvidia no tenía presencia nativa.
Eso importa porque la base de desarrolladores de PC con Arm es por fin lo bastante grande como para programar para ella. La serie M de Apple normalizó los portátiles Arm para el trabajo creativo y científico, la línea Snapdragon X de Qualcomm llevó Windows on Arm al gran público, y Microsoft ha pasado años mejorando sus herramientas Arm64 y su ABI de traducción Arm64EC. Todas esas máquinas podían ejecutar un sistema operativo Arm, pero una aplicación CUDA compilada solo para x86 no obtenía aceleración por GPU en ellas. Windows on Arm tenía una propuesta de CPU y gráficos integrados, pero ninguna vía propia hacia la plataforma de cómputo de Nvidia.
Nvidia está sincronizando el software con su propio silicio. RTX Spark, la plataforma de PC basada en Arm de la empresa, combina núcleos Grace con una GPU derivada de Blackwell. La propia guía para desarrolladores de Nvidia dice a los equipos que empiecen a portar ya en el hardware Windows on Arm que tengan, y que validen en RTX Spark cuando haya sistemas y controladores disponibles. Publicar la cadena de herramientas antes que el hardware es lo contrario del patrón que hundió oleadas anteriores de Windows on Arm, cuando las máquinas llegaban con software que no se había recompilado para ellas.
Rubin llega como avance, no como producto
El segundo titular es Rubin. CUDA 13.4 añade lo que Nvidia llama «soporte funcional para la arquitectura NVIDIA Rubin (capacidad de cómputo 107) como avance», lo que permite a los desarrolladores compilar y probar contra la arquitectura antes de que «el soporte de CUDA para Rubin alcance la disponibilidad general en una futura versión del CUDA Toolkit».
El mecanismo es concreto y fácil de pasar por alto. El compilador de Nvidia gana un objetivo SM_107, y el conjunto de instrucciones PTX actualizado incluye algunas capacidades de Rubin, lo que significa que las bibliotecas y los frameworks pueden empezar a construir ya binarios y canalizaciones de CI preparados para Rubin. Hardware Premium deja explícita la misma distinción: Rubin en la 13.4 es un avance funcional, y la disponibilidad general queda reservada para un kit posterior.
Un avance no es disponibilidad general
El soporte de Rubin aquí es un avance para desarrolladores. No hay hardware Rubin en el mercado que lo respalde, las notas de la versión de Nvidia describen el avance como software preliminar, y la empresa advierte explícitamente contra el uso de compilaciones preliminares para producción, certificación o pruebas comparativas. Trate cualquier cifra temprana de rendimiento de Rubin con la misma desconfianza que aplicaría a una beta de julio.
Para la hoja de ruta, la señal es de secuencia más que de velocidad. El soporte de CUDA suele acompañar a una arquitectura nueva en el lanzamiento o cerca de él, así que un avance meses antes de la disponibilidad general da a los mantenedores de bibliotecas, a los autores de frameworks y a la habitual cola larga de aplicaciones CUDA una ventaja de salida. También dice al mercado en torno a qué arquitectura quiere Nvidia alinear el ecosistema a continuación, en un momento en que sus piezas actuales para centros de datos siguen en plena rampa.
MPS V3 y el problema de la GPU compartida
La versión también moderniza Multi-Process Service, el mecanismo que permite a varios procesos compartir una GPU sin limitarse a serializarlos. MPS V3 sustituye el antiguo modelo de control por una interfaz de línea de comandos scriptable, instancias de servidor con nombre y espacios de nombres para organizar cargas de trabajo concurrentes. Añade configuración TOML, controles de partición de multiprocesadores de streaming y límites de memoria de GPU integrados con cgroups.
El efecto práctico es la partición programática: el rendimiento de cómputo, los límites de memoria y la prioridad de ejecución pueden definirse en la configuración en lugar de organizarse a mano. Para entornos en contenedores y orquestados, donde varios inquilinos o trabajos pueden querer el mismo acelerador, esa es la diferencia entre un uso compartido a mejor esfuerzo y un aislamiento exigible. Nvidia lo plantea como una forma de elevar la utilización sin renunciar a las garantías de recursos, y remite a los desarrolladores a un nuevo inicio rápido de MPS V3.
Hay adiciones menores dirigidas al mismo problema de mover y colocar datos de forma eficiente. CUDA Compute Fabric Transport ofrece una API centrada en el transporte para que las bibliotecas de comunicación muevan datos por las redes NVLink usando puntos finales lógicos con nombre y operaciones asíncronas de put, get y reducción, en lugar de mapear cada asignación remota en el espacio de direcciones de un proceso. Los dominios de localidad exponen grupos de SM y memoria de dispositivo que pueden ubicarse juntos, y una nueva API para consultar la residencia de la memoria unificada, cudaMemGetLocationInfo, permite al código sensible al rendimiento ver dónde reside realmente la memoria gestionada antes de programar el trabajo.
Bibliotecas, Python y perfilado
El reparto secundario también recibió actualizaciones. cuBLAS añade rendimiento de doble precisión mediante emulación en punto fijo con el esquema Ozaki-II, y cuBLASLt gana planificación dinámica para cargas de trabajo Grouped GEMM en GPU de centro de datos Blackwell, pensada para los patrones de muchos grupos habituales en los modelos de mezcla de expertos. CCCL 3.4 incluye un cub::DeviceScan especializado por warps para Blackwell que, según Nvidia, alcanza hasta un 92 por ciento de utilización del ancho de banda de memoria, frente a aproximadamente el 50 por ciento de la implementación anterior, junto con API de CUB de una sola llamada y algoritmos paralelos de la biblioteca estándar de C++ bajo una política cuda::execution::gpu.
CUDA Python se amplía en dos direcciones. cuda.core 1.1.0 añade programación de texturas y superficies, memoria gestionada con conocimiento de NUMA, flujos de trabajo de grafos más ricos y stubs de tipo .pyi que dan a los IDE y a los agentes de programación firmas reales. cuda.compute 1.1 añade compilación anticipada de algoritmos de CCCL para varias arquitecturas de GPU, con artefactos serializados que pueden distribuirse y deserializarse en el hardware de destino sin recompilar.
En el lado de las herramientas, Nsight Systems 2026.5.1 añade soporte para CUDA 13.4, GPU Rubin y Windows on Arm, y trae una larga lista de novedades de perfilado: conjuntos de métricas de CPU, trazado de formas de PyTorch, recetas de análisis de red y almacenamiento, y un marco de plugins que puede inicializarse antes de que arranque una aplicación. Nsight Python 1.0 automatiza el perfilado de kernels desde un script de Python, y Nvidia también promociona una capa de IA, incluido un servidor CUDA MCP alojado que conecta a los agentes de programación con la documentación de CUDA.
Nvidia no vende aquí una GPU más rápida. Vende alcance: una cadena de herramientas CUDA que ahora puede apuntar a los portátiles Arm hacia los que se dirige su silicio, y un compilador que ya ve la arquitectura posterior a la siguiente.
Advertencias y qué hay que vigilar
La advertencia obvia es que casi todo esto son cimientos. CUDA 13.4 no hará más rápida una GPU existente, y el soporte de Windows on Arm es una inversión de plataforma cuyo rendimiento depende de hardware que aún no está en las tiendas. El avance de julio llegó con asperezas que Nvidia documentó para los desarrolladores, incluidas transferencias más lentas sobre memoria paginable y, en algunos flujos de compilación de PyTorch, tiempos de espera de la GPU o reinicios del sistema. La versión de disponibilidad general de septiembre es la que está pensada para usarse, pero el ecosistema que la rodea, desde cuDNN hasta las ruedas de los frameworks, tardará en completarse.
El avance de Rubin merece su propia cautela. El soporte preliminar permite compilar y ejecutar código donde los controladores y el hardware compatible lo permitan, pero no es un lanzamiento, y Nvidia no se ha comprometido con una fecha para la disponibilidad general. Quien lea una prueba comparativa derivada de compilaciones preliminares debería asumir que las cifras no son representativas, que es exactamente lo que dicen los términos del avance de Nvidia.
Lo que hay que vigilar a continuación es concreto. Primero, si los primeros sistemas RTX Spark llegan con el stack de CUDA que habilita este kit, ya que una cadena de herramientas por delante de su hardware solo compensa si el hardware la sigue. Segundo, con qué rapidez los principales frameworks publican ruedas Arm64 para Windows que lo usen, que es la prueba real de si «CUDA en Windows on Arm» se convierte en una opción cotidiana o se queda en la práctica como un avance para desarrolladores. Tercero, el paso de Rubin de avance a disponibilidad general, que marcará el punto en que la cadena de herramientas de la arquitectura se considera estable. Por ahora, el software está listo antes que el silicio, y ese orden es deliberado.
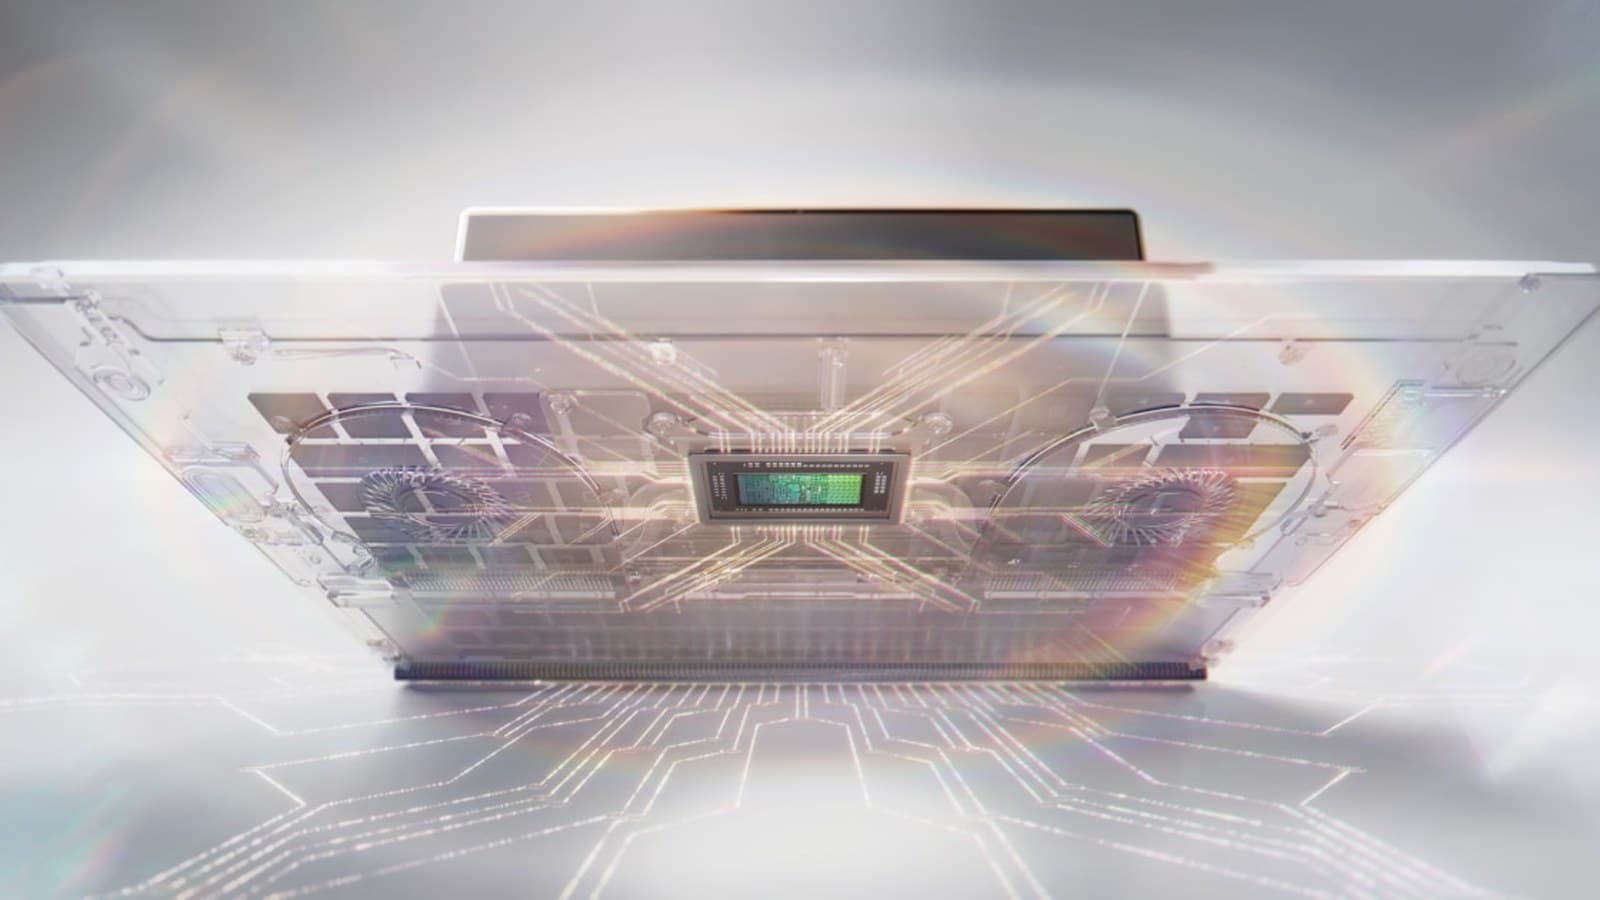
Imagen de portada: render oficial de producto RTX Spark de Nvidia (activo de producto distribuido por la empresa desde nvidia.com), recortado a 16:9.
Imagen de portada: render oficial de Nvidia del portátil RTX Spark. Imagen: Nvidia.
Etiquetas

TPW Editorial
Redacción
El equipo editorial de TechPastWeek investiga y edita cada artículo que publicamos. Cada historia se contrasta con fuentes primarias y secundarias fiables, y un editor la revisa antes de publicarse.