Le pari chinois des 100 000 GPU : JD Cloud et Moore Threads bâtissent un cluster d'IA national
JD Cloud et Moore Threads vont bâtir un cluster de 100 000 GPU sur du silicium chinois, le premier de cette ampleur chez un grand cloud national. Le hic : le logiciel.

Sur cette page
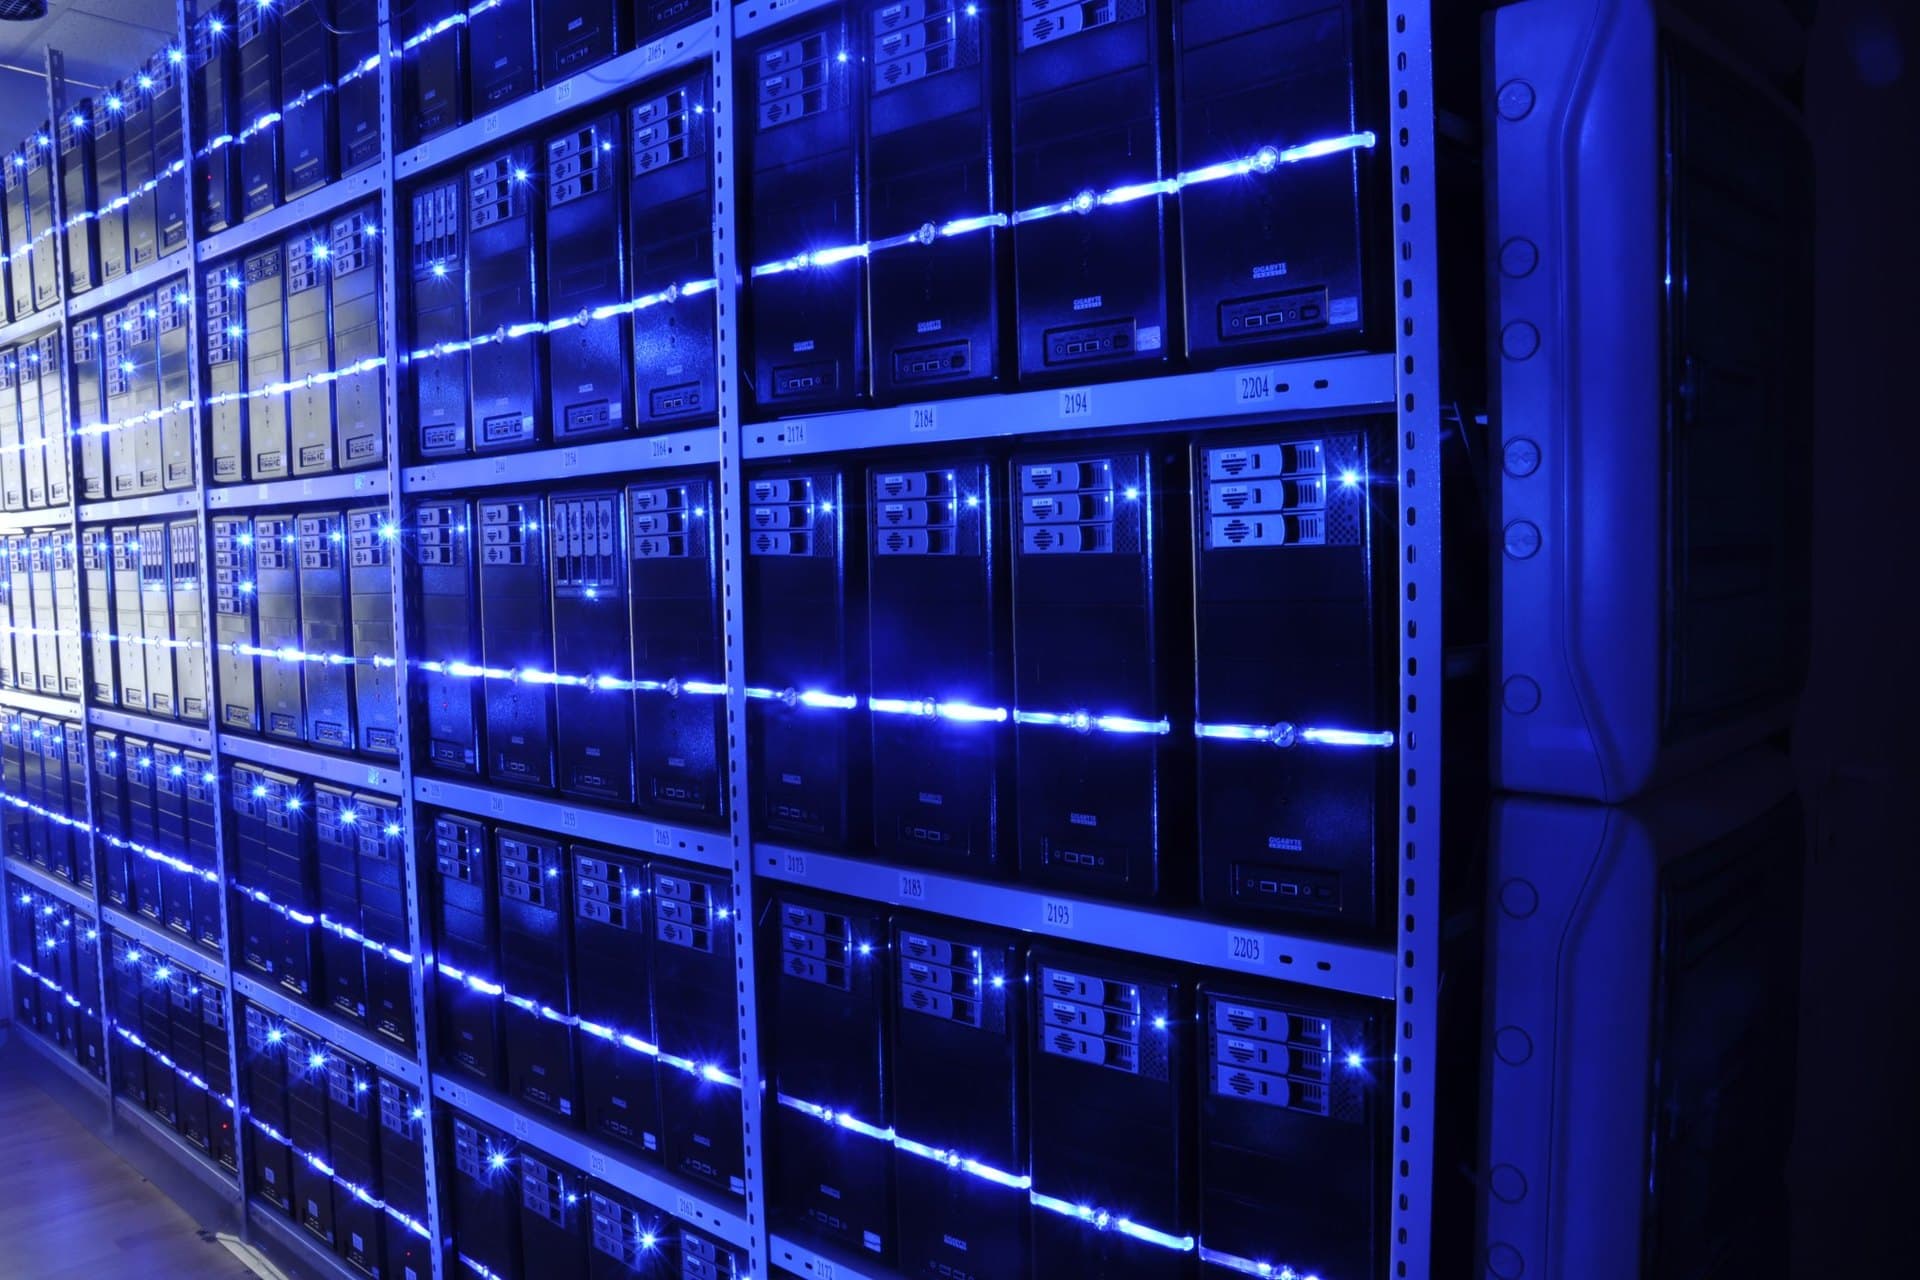
Le géant chinois du e-commerce et du cloud JD prévoit de construire un cluster de calcul de 100 000 GPU entièrement propulsé par du silicium national. Le projet, dévoilé lors de la Global Technology Explorers Conference de JD le 9 septembre à Pékin, associe JD Cloud à Moore Threads, l'un des concepteurs de GPU les plus scrutés de Chine.
À lire aussi: SK Hyper chiffre à 350 milliards de dollars les 5 premiers gigawatts de son programme d'IA · Oracle envoie une notification de force majeure pour le campus Stargate de 18 milliards de dollars au Nouveau-Mexique.
S'il voit le jour comme décrit, ce serait le premier cluster de ce type hébergé par un grand fournisseur chinois de cloud d'IA, un jalon dans la longue campagne de Pékin pour bâtir une pile d'IA qui ne dépende pas de Nvidia.
Ce qui a été annoncé
Les chiffres phares sont simples, et les détails étrangement minces :
- 100 000 GPU, utilisant des accélérateurs « pleinement fonctionnels » de Moore Threads.
- Charges de travail : entraînement de modèles à grande échelle, inférence et intelligence incarnée (robotique), les trois catégories qui comptent le plus pour les planificateurs chinois.
- Opérateur : JD Cloud, avec des centres de données principaux à Pékin, Canton, Shanghai et Suqian.
- Antécédents : les deux entreprises ont déjà bâti ensemble un cluster de 10 000 GPU; il s'agit donc d'un passage à l'échelle par dix, non d'un démarrage à froid.
Ce que JD ne divulgue pas compte tout autant : aucune date d'achèvement, aucun benchmark du cluster complet, aucun déploiement en exploitation. L'annonce est un plan, pas un système en marche.
Le silicium en dessous
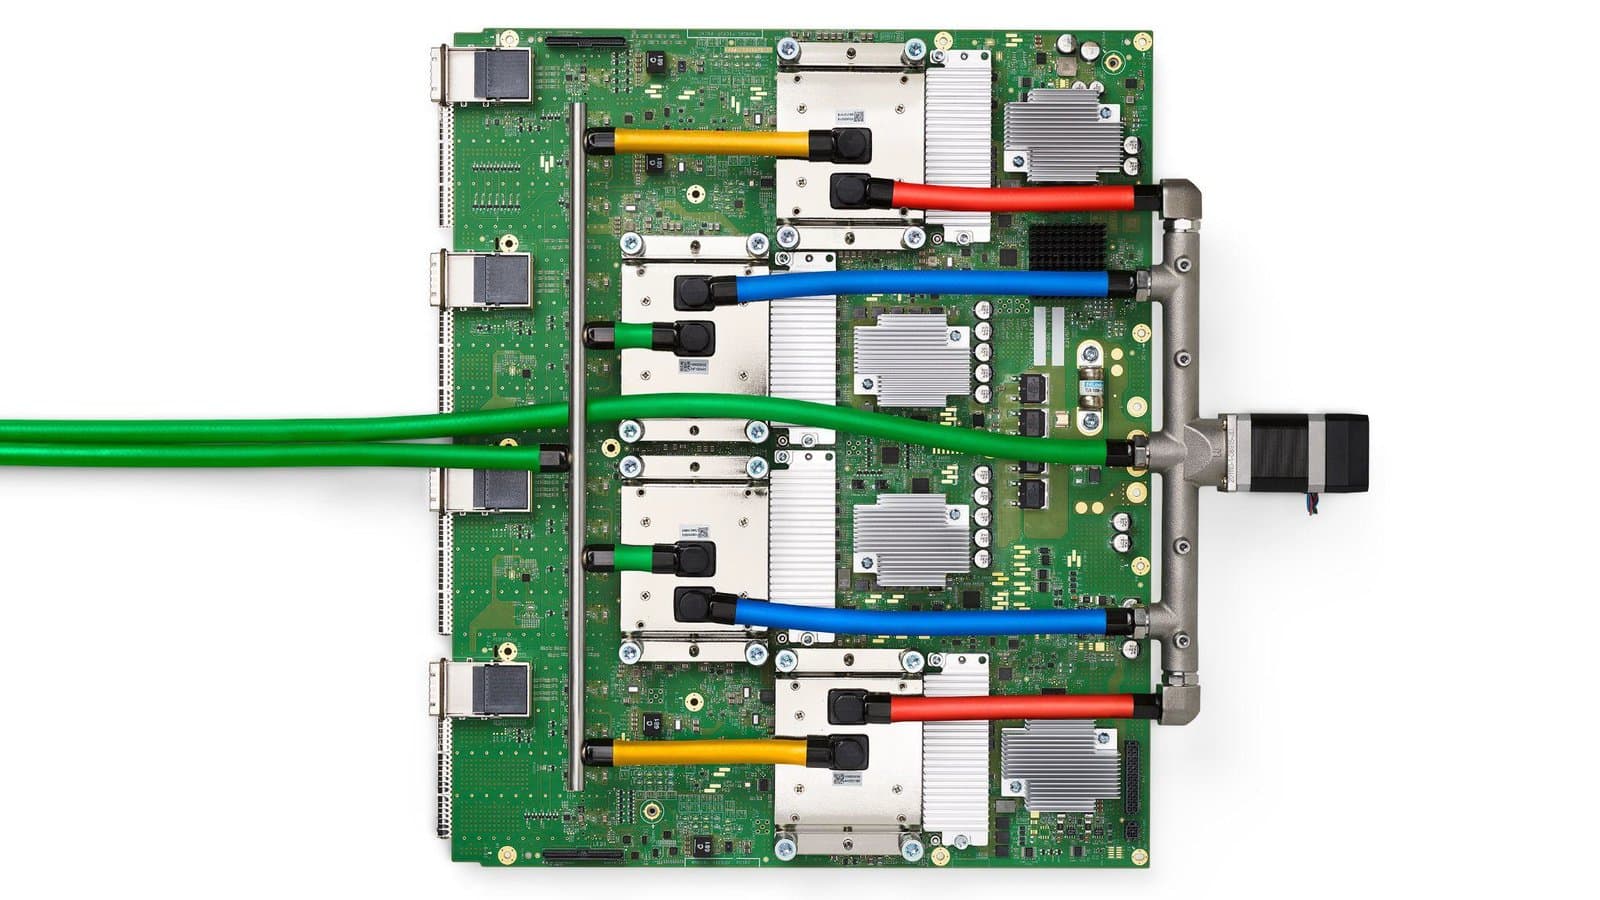
Le fer de lance actuel de Moore Threads est le MTT S5000, fondé sur la puce PH100 et l'architecture « PingHu ». L'entreprise promet une prise en charge de la précision complète de FP8 à FP64, la plage qui compte autant pour l'entraînement que pour l'inférence. Les modèles plus anciens MTT S4000 et S3000 complètent la gamme.
La feuille de route du fabricant, présentée lors de sa conférence développeurs fin de l'année dernière, pointe vers une architecture de nouvelle génération nommée « Huagang » qui, selon lui, augmente la densité de calcul de 50 %, améliore l'efficacité énergétique d'un facteur dix et est explicitement conçue pour passer à l'échelle de clusters de plus de 100 000 GPU. C'est sur cette architecture que le cluster de JD s'appuiera à terme.
Moore Threads n'est pas un projet artisanal. Fondée en 2020 par l'ancien cadre de Nvidia en Chine James Zhang Jianzhong, l'entreprise a levé des fonds auprès de Sequoia China, GGV Capital et (fait notable) ByteDance et Tencent, et est cotée à la Bourse de Shanghai depuis décembre 2025. Elle figure aussi sur l'Entity List du Bureau américain de l'industrie et de la sécurité, ce qui limite son accès aux technologies de fabrication occidentales avancées.
Pourquoi maintenant
La logique est simple : les contrôles à l'exportation américains ont rendu l'accès aux accélérateurs Nvidia haut de gamme de plus en plus difficile en Chine, et Pékin riposte en tentant de fabriquer sa sortie du problème. Chaque grand cloud chinois est désormais sous pression pour démontrer une voie nationale pour le calcul d'IA.
L'argument de la souveraineté
Pour les planificateurs chinois, l'enjeu d'un cluster national de 100 000 GPU n'est pas seulement la performance, mais la résilience. Une chaîne d'approvisionnement qui peut être coupée est une chaîne d'approvisionnement qui peut servir de levier. Le silicium national, aussi imparfait soit-il, est la police d'assurance.
Les données de marché soutiennent l'ambition. Les analystes chinois projettent que le marché national des GPU dépassera 1 300 milliards de yuans d'ici 2029, tandis que la part de la Chine dans le marché mondial des GPU passerait de 15,6 % en 2024 à 37,8 %. Cela représente beaucoup de demande à la recherche d'un fournisseur autre que Nvidia.
La faille que personne ne cache
C'est ici que l'histoire se complique, et devient plus honnête.
La pile logicielle de Moore Threads, MUSA, est la tentative de l'entreprise de répliquer ce qui rend Nvidia véritablement dominant : CUDA. Elle fournit même un outil de migration, MUSIFY, censé porter le code CUDA vers son matériel. Mais des partenaires interrogés par des médias chinois se sont montrés francs : les GPU nationaux accusent encore une à deux générations de retard sur les leaders mondiaux, tant en performance brute qu'en maturité de l'écosystème.
Le schéma rappelle l'ascension de Huawei dans les télécoms : les marchés occidentaux n'achèteront peut-être jamais d'accélérateurs d'IA chinois, mais la demande intérieure et les marchés émergents pourraient leur donner assez d'échelle pour progresser. Reste à savoir s'il s'agit d'un projet de cinq ou de quinze ans.
Les trois questions qui décident de ce projet :
  1. Le matériel peut-il soutenir un entraînement à
     100 000 GPU sans s'effondrer sous l'interconnexion
     et les taux de panne ?
  2. MUSA peut-il rendre le portage de CUDA assez bon marché
     pour que les développeurs chinois cessent de le subir ?
  3. La chaîne d'approvisionnement peut-elle livrer à cette
     échelle sous sanctions ?
Le tableau d'ensemble
L'annonce est tombée la même semaine où Nvidia cherchait à racheter Hugging Face pour 12,9 milliards de dollars et où Nvidia, Equinix et Together AI développaient l'infrastructure d'inférence d'entreprise en Occident. Le déploiement de l'IA est mondial et se bifurque : une pile ancrée dans Nvidia et CUDA, et une pile parallèle assemblée en Chine sous contrainte.
Le cluster de 100 000 GPU de JD est le signal le plus clair de la direction que prend la seconde pile. Il rappelle aussi que ce genre d'annonces est bon marché, tandis que livrer des clusters à cette échelle est brutalement difficile.
Ce qu'il faut surveiller
Ignorez pour l'instant le chiffre de 100 000. Attendez le premier benchmark indépendant d'un cluster national achevé et surveillez l'adoption de MUSA par les développeurs. Le silicium s'achète; les écosystèmes se méritent.
Étiquettes

TPW Editorial
Rédaction
L'équipe éditoriale de TechPastWeek enquête et édite chaque article publié. Chaque sujet est recoupé avec des sources primaires et secondaires fiables, et un éditeur le relit avant publication.