Nvidia öffnet CUDA für Windows on Arm und gibt Entwicklern eine Rubin-Vorschau
Nvidias CUDA Toolkit 13.4 erreicht die allgemeine Verfügbarkeit mit nativer Entwicklung für Windows on Arm, einer Vorschau der GPU-Architektur Rubin und einem neu aufgebauten MPS.

Auf dieser Seite
Am 9. September 2026 veröffentlichte Nvidia das CUDA Toolkit 13.4 und schloss damit eine Lücke, die seine Entwicklerplattform von einer ganzen Klasse von Computern ferngehalten hatte. Das Toolkit erweitert die CUDA-Entwicklung auf Windows on Arm, was Nvidia zuvor nie ausgeliefert hatte, und eröffnet zudem einen frühen Weg zu Rubin, der nächsten Generation der GPU-Architektur des Unternehmens. Der öffentliche Download ist CUDA 13.4.1, das die Entwicklervorschau ersetzt, die Nvidia im Juli veröffentlicht hatte. (Nvidia Technical Blog, VideoCardz)
Zum Weiterlesen: DeepSeek veröffentlicht einen Open-Source-Software-Stack für Huaweis Ascend-Chips mit Blick auf CUDA · Nvidias DSX POD macht aus einer KI-Fabrik einen Frachtcontainer.
Der Teil zu Windows on Arm ist die Schlagzeile. CUDA läuft seit Jahren auf Arm-Hardware, aber nur über Linux, auf Jetson-Modulen und Arm64-Servern. Natives Windows Arm64 war das fehlende Ziel, und seine Abwesenheit hielt den Großteil des CUDA-abhängigen Stacks, von PyTorch und TensorRT bis zu professionellen Rendering- und Simulationswerkzeugen, von Arm-basierten Windows-Rechnern fern. Nvidias Blog beschreibt die Veröffentlichung als Erweiterung von CUDA „auf die Windows-on-Arm-Plattform“ und merkt an, Anwendungen seien „lange auf Arm-Plattformen über Linux unterstützt“ worden.
Eine Toolchain aus erster Hand kommt an
Entwickler haben zwei Wege hinein. Sie können CUDA-Anwendungen direkt auf einem Windows-Arm64-System bauen oder für Arm64 aus dem Windows-x86-64-Toolkit crosskompilieren. Für Teams, die noch keine Arm-Hardware besitzen, ist der zweite Weg der praktische, und es ist dieselbe Reihenfolge der Schritte, die die Branche vor einem Jahrzehnt sah, als Arm-Server erstmals als zweite Architektur für Rechenzentren angepriesen wurden.
Nvidia listet Windows-Arm64-Unterstützung über Komponenten hinweg auf, darunter NVCC, die CUDA-Runtime, cuBLAS, cuFFT und die Nsight-Entwicklerwerkzeuge, laut VideoCardz. Guru3D berichtet dieselbe Auswahl und ergänzt, dass die zentralen Mathematikbibliotheken des Toolkits funktionale Windows-on-Arm-Unterstützung für das erhalten, was Nvidia das N1X-Laptop-Ökosystem nennt, die Arm-basierte Plattform hinter den RTX-Spark-Maschinen, die im Juni auf der Computex angekündigt wurden.
Der Treiber ist nicht mehr im Paket
Ab CUDA 13.4 bündeln Nvidias SDK-Installer keinen GPU-Treiber mehr. Linux-Nutzer installieren nun einen separaten Developer Driver (R616) von Nvidias Downloadseite, eine Änderung, die die Versionshinweise zur Entwicklervorschau im Juli ankündigten. Windows-Nutzer waren bereits auf einem separaten Treiberpfad.
Warum das Öffnen von CUDA für Windows Arm wichtig ist
CUDA ist Nvidias stärkste Bindung. Es gibt konkurrierende Beschleunigungsstacks (AMDs ROCm und HIP, Intels oneAPI und SYCL, Apples Metal und MLX), aber keiner trägt die installierte Basis von CUDA oder die Bibliotheksunterstützung, die KI-Framework standardmäßig voraussetzen. Diesen Stack nach Windows on Arm zu bringen, bedeutet weniger, ein Häkchen zu setzen, als den Burggraben in die eine PC-Kategorie hinein zu verlängern, in der Nvidias Software keine native Präsenz hatte.
Das ist wichtig, weil die Entwicklerbasis für Arm-PCs endlich groß genug ist, um für sie zu bauen. Apples M-Serie hat Arm-Laptops für kreative und wissenschaftliche Arbeit normalisiert, Qualcomms Snapdragon-X-Reihe hat Windows on Arm in den Mainstream gedrückt, und Microsoft hat jahrelang seine Arm64-Tooling und die Arm64EC-Übersetzungs-ABI verbessert. Jede dieser Maschinen könnte ein Arm-Betriebssystem ausführen, doch eine nur für x86 kompilierte CUDA-Anwendung erhielt darauf keine GPU-Beschleunigung. Windows on Arm hatte eine Geschichte für CPU und integrierte Grafik, aber keinen Erstanbieterweg zu Nvidias Compute-Plattform.
Nvidia taktet die Software auf seine eigene Hardware. RTX Spark, die Arm-basierte PC-Plattform des Unternehmens, kombiniert Grace-CPU-Kerne mit einer von Blackwell abgeleiteten GPU. Nvidias eigene Entwicklerhinweise raten Teams, jetzt mit der Portierung auf der vorhandenen Windows-on-Arm-Hardware zu beginnen und dann auf RTX Spark zu validieren, sobald Einzelhandelssysteme und Treiber verfügbar sind. Die Toolchain vor der Hardware auszuliefern, ist das Gegenteil des Musters, das frühere Windows-on-Arm-Wellen versenkte, als Maschinen mit Software ankamen, die nicht für sie neu gebaut worden war.
Rubin kommt als Vorschau, nicht als Produkt
Die zweite Schlagzeile ist Rubin. CUDA 13.4 fügt das hinzu, was Nvidia „funktionale Unterstützung für die Nvidia-Rubin-Architektur (Compute Capability 107) als Vorschau“ nennt, sodass Entwickler gegen die Architektur kompilieren und testen können, bevor „die CUDA-Unterstützung für Rubin in einer künftigen Version des CUDA Toolkits die allgemeine Verfügbarkeit erreicht“.
Der Mechanismus ist konkret und leicht zu übersehen. Nvidias Compiler erhält ein SM_107-Ziel, und der aktualisierte PTX-Befehlssatz enthält einige Rubin-Fähigkeiten, was bedeutet, dass Bibliotheken und Frameworks jetzt damit beginnen können, Rubin-fähige Binärdateien und CI-Pipelines zu bauen. Hardware Premium macht dieselbe Unterscheidung explizit: Rubin in 13.4 ist eine funktionale Vorschau, die allgemeine Verfügbarkeit bleibt einem späteren Toolkit vorbehalten.
Vorschau ist nicht GA
Die Rubin-Unterstützung hier ist eine Entwicklervorschau. Dahinter steht keine ausgelieferte Rubin-Hardware, Nvidias Versionshinweise beschreiben die Vorschau als Vorabsoftware, und das Unternehmen warnt ausdrücklich davor, Vorschaubuilds für Produktion, Zertifizierung oder Benchmarks zu verwenden. Behandeln Sie jede frühe Rubin-Leistungszahl mit derselben Skepsis, die Sie einer Juli-Beta entgegenbringen würden.
Für die Roadmap geht es beim Signal um die Reihenfolge, nicht um das Tempo. CUDA-Unterstützung begleitet normalerweise eine neue Architektur zum oder nahe dem Start, sodass eine Vorschau Monate vor der allgemeinen Verfügbarkeit Bibliotheksverwaltern, Framework-Autoren und dem üblichen langen Schwanz der CUDA-Anwendungen einen Vorsprung gibt. Sie sagt dem Markt zudem, auf welche Architektur Nvidia das Ökosystem als Nächstes ausrichten möchte, in einem Moment, in dem seine aktuellen Rechenzentrumsteile noch hochfahren.
MPS V3 und das Problem der geteilten GPU
Die Veröffentlichung modernisiert zudem den Multi-Process Service, den Mechanismus, der mehrere Prozesse eine GPU teilen lässt, ohne sie einfach zu serialisieren. MPS V3 ersetzt das ältere Steuerungsmodell durch eine skriptfähige Kommandozeilenschnittstelle, benannte Serverinstanzen und Namespaces zur Organisation gleichzeitiger Workloads. Es fügt TOML-Konfiguration, Partitionierungssteuerung für Streaming-Multiprozessoren und cgroup-integrierte GPU-Speichergrenzen hinzu.
Die praktische Wirkung ist programmatische Partitionierung: Rechenleistung, Speichergrenzen und Ausführungspriorität lassen sich alle in der Konfiguration festlegen, statt von Hand geregelt zu werden. Für containerisierte und orchestrierte Umgebungen, in denen mehrere Mandanten oder Jobs denselben Beschleuniger möchten, ist das der Unterschied zwischen Best-Effort-Teilen und durchsetzbarer Isolation. Nvidia rahmt es als Weg, die Auslastung zu erhöhen, ohne Ressourcengarantien aufzugeben, und verweist Entwickler auf einen neuen MPS-V3-Schnellstart.
Es gibt kleinere Ergänzungen, die auf dasselbe Problem abzielen, Daten effizient zu bewegen und zu platzieren. CUDA Compute Fabric Transport bietet eine transportzentrierte API, damit Kommunikationsbibliotheken Daten über NVLink-Fabrics bewegen können, mit benannten logischen Endpunkten und asynchronen Put-, Get- und Reduktionsoperationen, statt jede entfernte Zuweisung in den Adressraum eines Prozesses abzubilden. Locality Domains legen Gruppen von SMs und Gerätespeicher offen, die gemeinsam platziert werden können, und eine neue API zum Abfragen der Unified-Memory-Residenz, cudaMemGetLocationInfo, lässt leistungsempfindlichen Code sehen, wo verwalteter Speicher tatsächlich liegt, bevor Arbeit geplant wird.
Bibliotheken, Python und Profiling
Auch das Umfeld bekam Updates. cuBLAS erweitert die Doppelpräzisionsleistung durch Festkomma-Emulation mit dem Ozaki-II-Schema, und cuBLASLt erhält dynamische Planung für Grouped-GEMM-Workloads auf Blackwell-Rechenzentrums-GPUs, gerichtet auf die vielen Gruppenmuster, die in Mixture-of-Experts-Modellen üblich sind. CCCL 3.4 liefert eine warpspezialisierte cub::DeviceScan für Blackwell, die laut Nvidia bis zu 92 Prozent der Speicherbandbreite erreicht, gegenüber rund 50 Prozent in der vorigen Implementierung, zusammen mit Single-Call-CUB-APIs und parallelen Algorithmen der C++-Standardbibliothek unter einer cuda::execution::gpu-Policy.
CUDA Python wächst in zwei Richtungen. cuda.core 1.1.0 ergänzt Textur- und Surface-Programmierung, NUMA-bewussten verwalteten Speicher, reichhaltigere Graph-Workflows und .pyi-Typ-Stubs, die IDEs und Coding-Agenten echte Signaturen liefern. cuda.compute 1.1 ergänzt Ahead-of-Time-Kompilierung von CCCL-Algorithmen für mehrere GPU-Architekturen, mit serialisierten Artefakten, die ausgeliefert und auf der Zielhardware ohne Neukompilierung deserialisiert werden können.
Auf der Werkzeugseite ergänzt Nsight Systems 2026.5.1 Unterstützung für CUDA 13.4, Rubin-GPUs und Windows on Arm und trägt eine lange Liste von Profiling-Neuerungen: CPU-Metriksätze, PyTorch-Shape-Tracing, Rezepte für Netzwerk- und Speicheranalyse und ein Plugin-Framework, das vor dem Start einer Anwendung initialisiert werden kann. Nsight Python 1.0 automatisiert das Kernel-Profiling aus einem Python-Skript, und Nvidia bewirbt außerdem eine KI-Schicht, darunter einen gehosteten CUDA-MCP-Server, der Coding-Agenten mit der CUDA-Dokumentation verbindet.
Nvidia verkauft hier keine schnellere GPU. Es verkauft Reichweite: eine CUDA-Toolchain, die nun auf die Arm-Laptops zielen kann, in die seine Hardware strebt, und einen Compiler, der die übernächste Architektur bereits sehen kann.
Vorbehalte und was zu beobachten ist
Der offensichtliche Vorbehalt ist, dass das meiste davon Grundlagenarbeit ist. CUDA 13.4 wird eine bestehende GPU nicht schneller machen, und die Windows-on-Arm-Unterstützung ist eine Plattforminvestition, deren Ertrag von Hardware abhängt, die noch nicht in den Regalen steht. Die Juli-Vorschau kam mit rauen Kanten, die Nvidia für Entwickler dokumentierte, darunter langsamere Transfers über pagebaren Speicher und, in manchen PyTorch-Build-Workflows, GPU-Timeouts oder Systemneustarts. Die allgemein verfügbare Veröffentlichung im September ist die Version, die man nutzen soll, doch das Ökosystem darum herum, von cuDNN bis zu Framework-Wheels, braucht Zeit, um sich zu füllen.
Die Rubin-Vorschau verdient ihre eigene Vorsicht. Vorschauunterstützung lässt Code kompilieren und laufen, wo Treiber und kompatible Hardware es erlauben, aber es ist kein Start, und Nvidia hat sich nicht auf ein Datum für die GA festgelegt. Wer einen aus Vorschaubuilds abgeleiteten Benchmark liest, sollte annehmen, dass die Zahlen nicht repräsentativ sind, genau wie es Nvidias Vorschausbedingungen festhalten.
Was als Nächstes zu beobachten ist, ist konkret. Erstens, ob die ersten RTX-Spark-Systeme mit dem CUDA-Stack kommen, den dieses Toolkit ermöglicht, denn eine Toolchain vor ihrer Hardware zahlt sich nur aus, wenn die Hardware folgt. Zweitens, wie schnell große Frameworks Windows-Arm64-Wheels veröffentlichen, die sie nutzen, was der eigentliche Test dafür ist, ob „CUDA unter Windows on Arm“ zur Alltagsoption wird oder in der Praxis eine Entwicklervorschau bleibt. Drittens das Aufrücken von Rubin von der Vorschau zur allgemeinen Verfügbarkeit, das den Punkt markiert, an dem die Toolchain der Architektur als stabil gilt. Vorerst ist die Software vor dem Silizium bereit, und diese Reihenfolge ist Absicht.
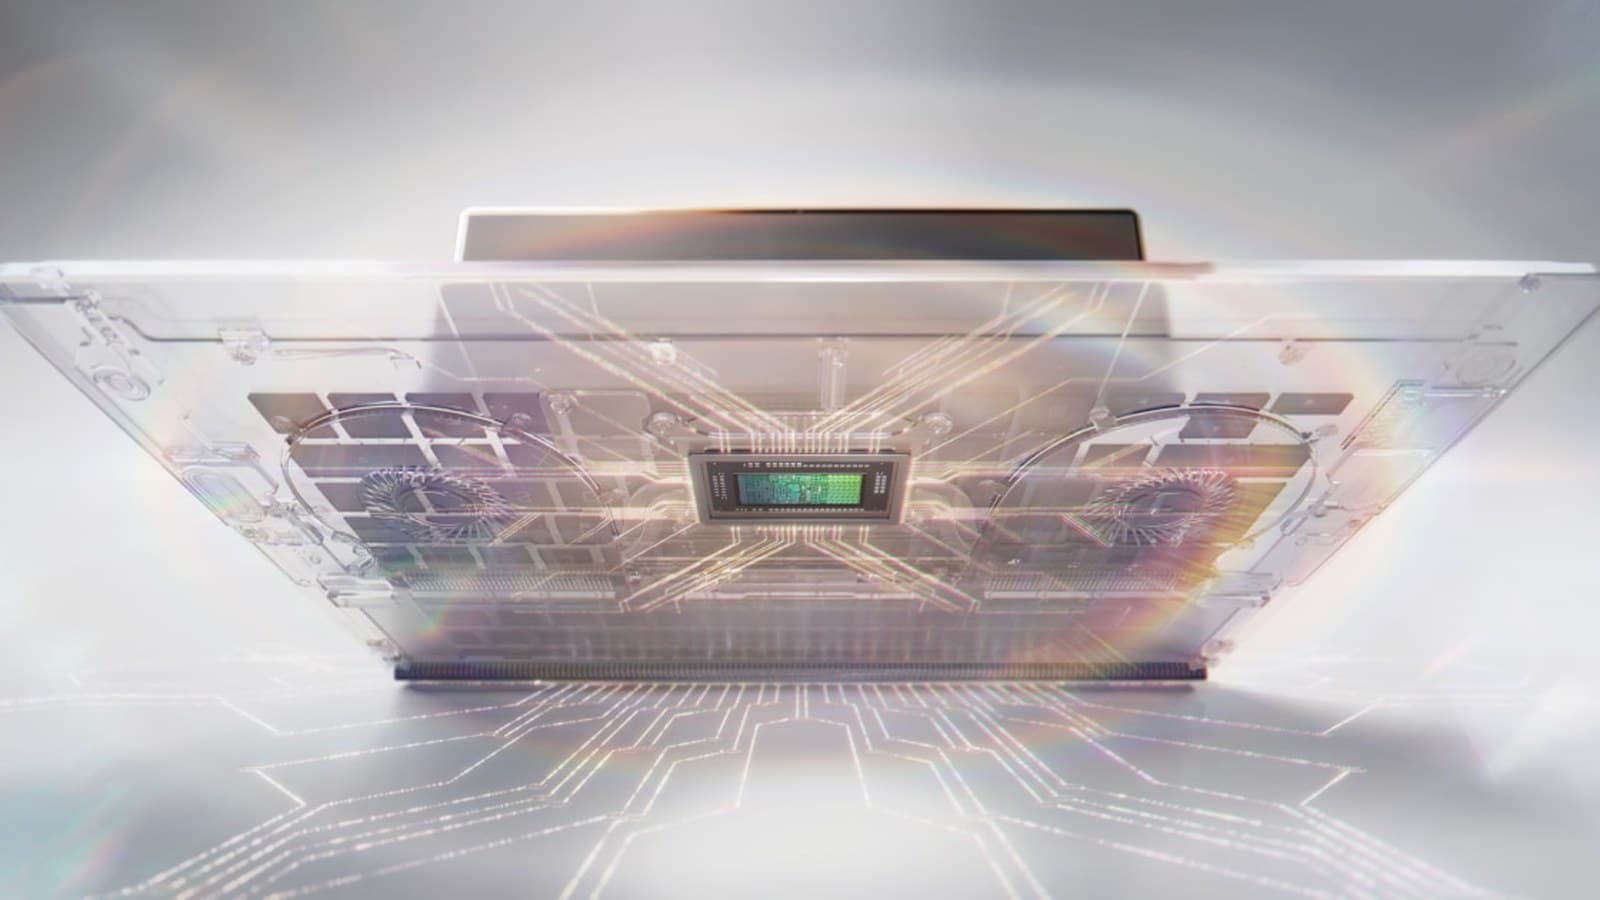
Titelbild: offizieller Produktrender des Nvidia RTX Spark (vom Unternehmen bereitgestelltes Produktasset von nvidia.com), auf 16:9 zugeschnitten.
Titelbild: offizieller Nvidia-Render des RTX-Spark-Laptops. Bild: Nvidia.
Tags

TPW Editorial
Redaktion
Die Redaktion von TechPastWeek recherchiert und betreut jeden veröffentlichten Artikel. Jede Geschichte wird anhand von Primär- und glaubwürdigen Sekundärquellen geprüft und vor der Veröffentlichung redaktionell freigegeben.