Chinas 100.000-GPU-Wette: JD Cloud und Moore Threads bauen einen heimischen KI-Cluster
JD Cloud und Moore Threads wollen einen Cluster mit 100.000 GPUs auf chinesischem Silizium bauen, der erste dieser Größe bei einer großen heimischen Cloud. Der Haken: die Software.

Auf dieser Seite
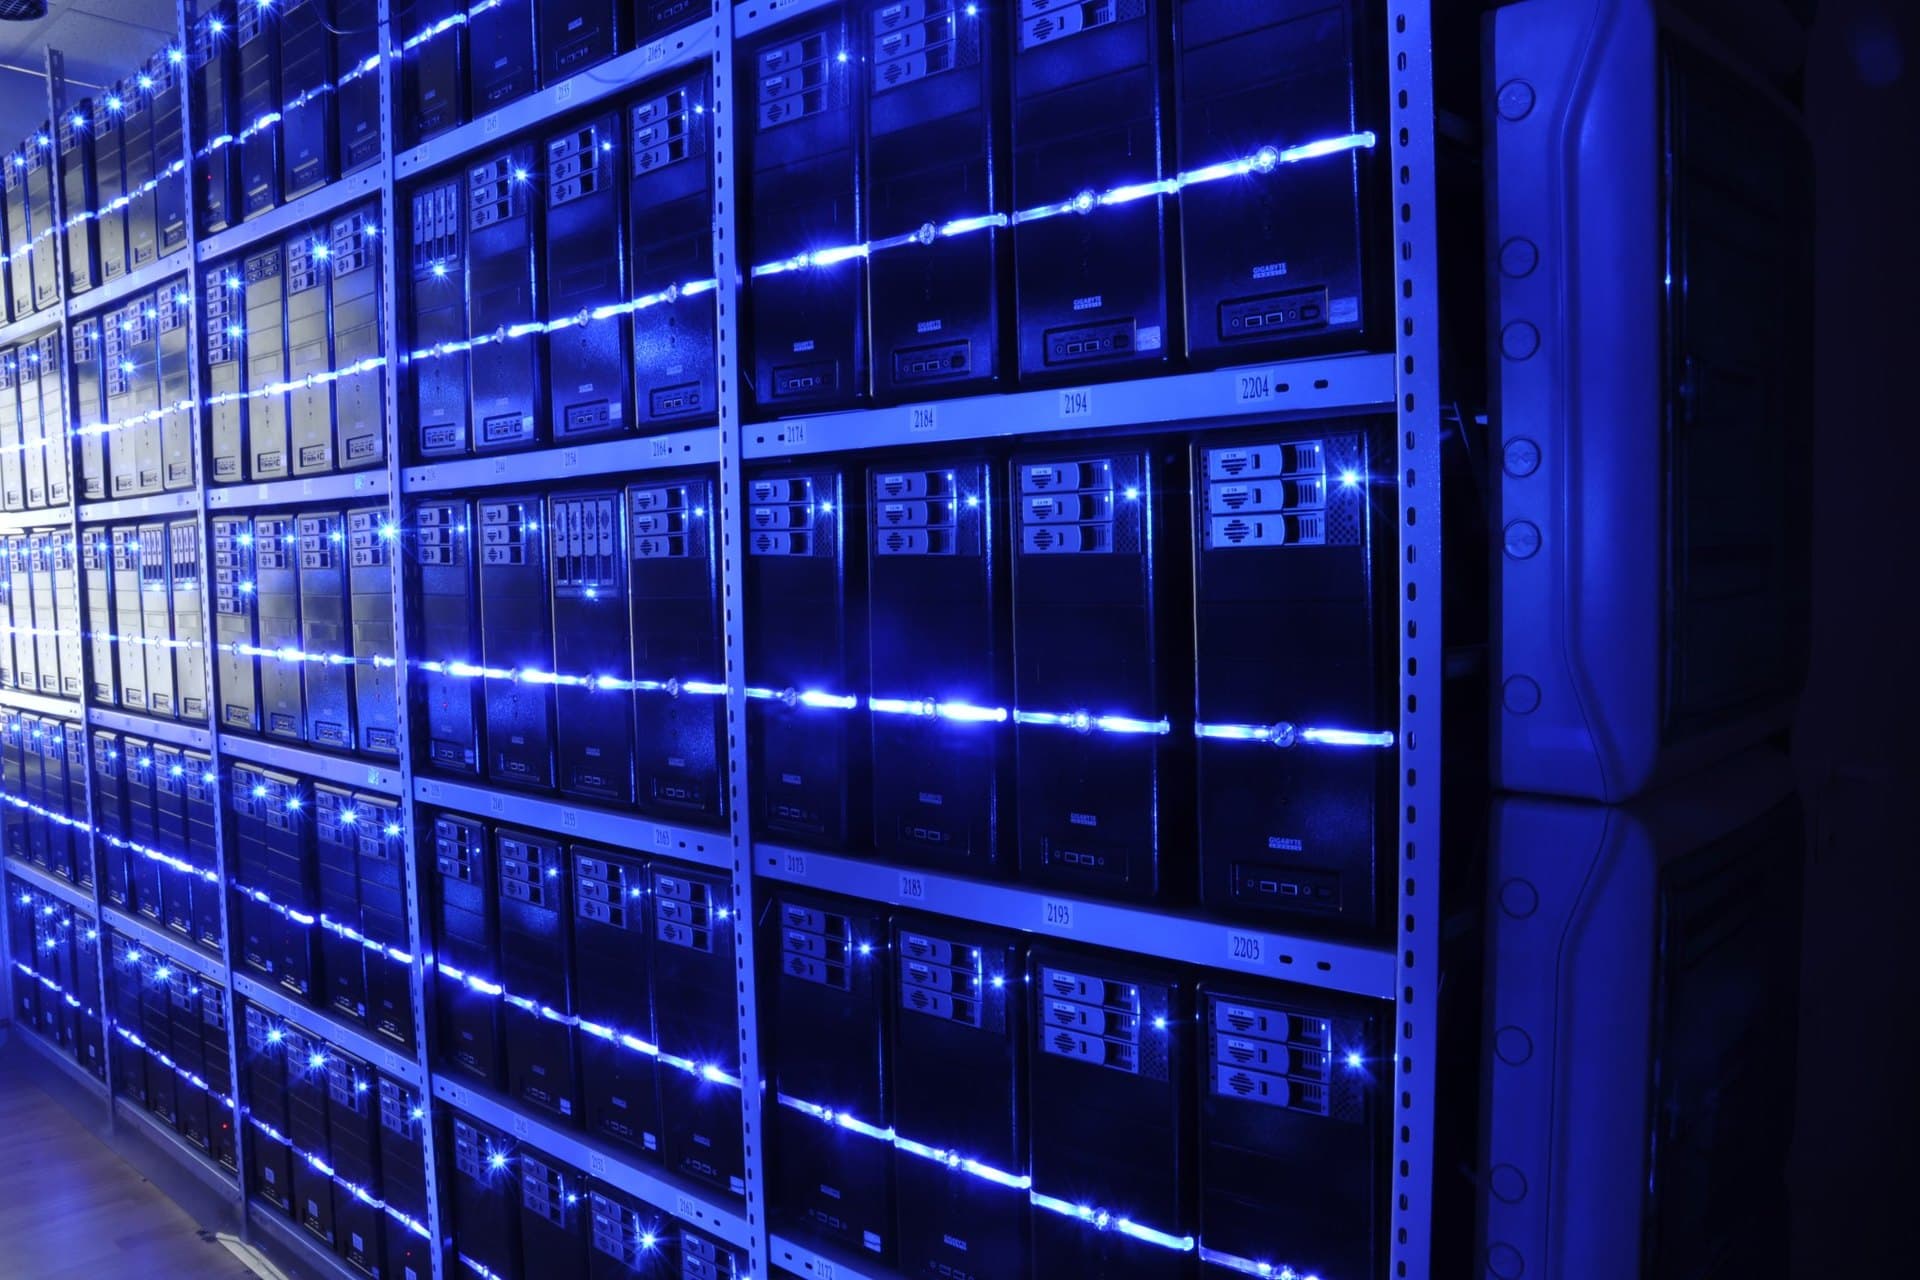
Der chinesische E-Commerce- und Cloud-Riese JD will einen Rechencluster mit 100.000 GPUs aufbauen, der vollständig auf heimischem Silizium basiert. Das Projekt, vorgestellt auf der Global Technology Explorers Conference von JD am 9. September in Peking, bringt JD Cloud mit Moore Threads zusammen, einem der aufmerksamsten beobachteten GPU-Entwickler Chinas.
Zum Weiterlesen: SK Hyper beziffert die ersten 5 Gigawatt seines KI-Ausbaus auf 350 Milliarden Dollar · Oracle reicht Force-Majeure-Mitteilung für 18-Milliarden-Dollar-Stargate-Campus in New Mexico ein.
Sollte es wie beschrieben umgesetzt werden, wäre es der erste Cluster dieser Art bei einem großen chinesischen KI-Cloud-Anbieter, ein Meilenstein in Pekings langem Bestreben, einen KI-Stack aufzubauen, der nicht von Nvidia abhängt.
Was angekündigt wurde
Die Schlagzahlen sind einfach, die Details auffällig dünn:
- 100.000 GPUs mit „vollfunktionalen" Beschleunigern von Moore Threads.
- Workloads: Training großer Modelle, Inferenz und embodied Intelligence (Robotik), die drei Kategorien, die chinesische Planer am meisten interessieren.
- Betreiber: JD Cloud mit Kerndatenzentren in Peking, Guangzhou, Shanghai und Suqian.
- Vorgeschichte: Beide Firmen haben bereits gemeinsam einen Cluster mit 10.000 GPUs gebaut, dies ist also eine Verzehnfachung, kein Kaltstart.
Was JD ebenso wenig offenlegt: kein Fertigstellungstermin, kein Benchmark für den gesamten Cluster und kein laufender Betrieb. Die Ankündigung ist ein Plan, kein laufendes System.
Das Silizium darunter
Das aktuelle Flaggschiff von Moore Threads ist die MTT S5000 auf Basis des PH100-Chips und der „PingHu"-Architektur. Das Unternehmen verspricht volle Präzisionsunterstützung von FP8 bis FP64, genau die Bandbreite, die für Training und Inferenz zählt. Die älteren Modelle MTT S4000 und S3000 runden das Portfolio ab.
Die Roadmap des Herstellers, vorgestellt auf seiner Entwicklerkonferenz Ende letzten Jahres, deutet auf eine nächste Architektur namens „Huagang" hin, die laut eigenen Angaben die Rechendichte um 50 % steigert, die Energieeffizienz verzehnfacht und ausdrücklich für Cluster jenseits von 100.000 GPUs ausgelegt ist. Auf dieser Architektur würde der JD-Cluster letztlich aufsetzen.
Moore Threads ist kein Bastelprojekt. 2020 vom ehemaligen Nvidia-China-Manager James Zhang Jianzhong gegründet, sammelte das Unternehmen Geld von Sequoia China, GGV Capital und (bemerkenswerterweise) ByteDance und Tencent ein und ging im Dezember 2025 an die Shanghaier Börse. Zugleich steht es auf der Entity List des US-Handelsministeriums, was den Zugang zu fortschrittlicher westlicher Fertigungstechnik einschränkt.
Warum das jetzt passiert
Die Logik ist einfach: US-Exportkontrollen haben den Zugang zu High-End-Nvidia-Beschleunigern in China zunehmend erschwert, und Peking reagiert, indem es sich aus dem Problem herausproduzieren will. Jede große chinesische Cloud steht nun unter Druck, einen heimischen Weg für KI-Rechenleistung nachzuweisen.
Das Argument der Souveränität
Für chinesische Planer geht es bei einem heimischen 100.000-GPU-Cluster nicht nur um Leistung, sondern um Widerstandsfähigkeit. Eine Lieferkette, die abgeschnitten werden kann, ist eine Lieferkette, die als Druckmittel dient. Heimisches Silizium ist, so unvollkommen es sein mag, die Versicherungspolice.
Die Marktdaten stützen den Ehrgeiz. Chinesische Analysten erwarten, dass der GPU-Markt des Landes bis 2029 1,3 Billionen Yuan übersteigt, während Chinas Anteil am globalen GPU-Markt von rund 15,6 % im Jahr 2024 auf 37,8 % steigen soll. Das ist eine Menge Nachfrage, die einen Nicht-Nvidia-Anbieter sucht.
Die Lücke, die niemand verheimlicht
Hier wird die Geschichte komplizierter, und ehrlicher.
Der Software-Stack von Moore Threads, MUSA, ist der Versuch, das nachzubauen, was Nvidia wirklich dominiert: CUDA. Das Unternehmen liefert sogar ein Migrationstool namens MUSIFY, das CUDA-Code auf seine Hardware portieren soll. Doch von chinesischen Medien befragte Partner waren offen: Heimische GPUs liegen bei reiner Leistung und Reife des Ökosystems noch etwa ein bis zwei Generationen hinter den globalen Spitzenreitern zurück.
Das Muster erinnert an den Aufstieg Huaweis im Telekommunikationsbereich: Westliche Märkte werden chinesische KI-Beschleuniger vielleicht nie kaufen, aber heimische Nachfrage und Schwellenländer könnten genug Skalierung liefern, um besser zu werden. Ob das ein Fünf- oder ein Fünfzehnjahresprojekt ist, bleibt die offene Frage.
Die drei Fragen, die dieses Projekt entscheiden:
  1. Hält die Hardware 100.000-GPU-Training stand,
     ohne unter Interconnect und Ausfallraten zu kollabieren?
  2. Macht MUSA das Portieren von CUDA-Workloads so günstig,
     dass chinesische Entwickler es nicht als Steuer empfinden?
  3. Kann die Lieferkette unter Sanktionen in dieser Größe liefern?
Das größere Bild
Die Ankündigung fiel in dieselbe Woche, in der Nvidia Hugging Face für 12,9 Milliarden Dollar übernehmen will und in der Nvidia, Equinix und Together AI die Enterprise-Inferenzinfrastruktur im Westen ausbauten. Der KI-Ausbau ist global, und er spaltet sich: ein Stack um Nvidia und CUDA, und ein paralleler Stack, der in China unter Druck zusammengesetzt wird.
Der 100.000-GPU-Cluster von JD ist das deutlichste Signal dafür, wohin der zweite Stack steuert. Er erinnert zugleich daran, dass solche Ankündigungen billig sind, während das Ausliefern von Clustern in dieser Größe brutal schwer ist.
Worauf man achten sollte
Ignorieren Sie vorerst die Zahl 100.000. Warten Sie auf den ersten unabhängigen Benchmark eines fertiggestellten heimischen Clusters und beobachten Sie die Entwicklerakzeptanz von MUSA. Silizium kann man kaufen; Ökosysteme muss man sich verdienen.
Tags

TPW Editorial
Redaktion
Die Redaktion von TechPastWeek recherchiert und betreut jeden veröffentlichten Artikel. Jede Geschichte wird anhand von Primär- und glaubwürdigen Sekundärquellen geprüft und vor der Veröffentlichung redaktionell freigegeben.