El chip de IA de Meta, diseñado con Broadcom y fabricado por TSMC, llega a los centros de datos a principios de 2027
Meta desplegará su chip de inferencia MTIA 450, diseñado con Broadcom y fabricado por TSMC, en centros de datos en la primera mitad de 2027, mientras escala su silicio propio.

En esta página
Puntos clave
- Meta planea empezar a desplegar su chip de IA de tercera generación MTIA 450, con el nombre en clave Arke, en centros de datos en la primera mitad de 2027, según un informe de Bloomberg del 15 de septiembre de 2026.
- El chip está codiseñado con Broadcom y fabricado por TSMC; las primeras 12 unidades llegaron de TSMC el 1 de septiembre de 2026 y se situaron dentro del 2 al 3 por ciento de las simulaciones de Meta.
- Meta se ha comprometido a más de 1 gigavatio de estos chips en un periodo de 12 meses, medido por potencia, y espera que el despliegue se acelere después.
- Meta canceló su chip combinado de entrenamiento e inferencia, Olympus, en parte por el coste, y apuesta por diseños solo de inferencia.
- El siguiente chip, MTIA 500 o Astrid, debería terminar su diseño en aproximadamente un mes y llegar a los centros de datos para finales de 2027.
Meta Platforms planea empezar a instalar una nueva generación de aceleradores de IA propios en sus centros de datos en la primera mitad de 2027, un movimiento que según la compañía reducirá el coste y la energía que dedica a ejecutar modelos en Facebook, Instagram y WhatsApp.
Lectura relacionada: TSMC logra su sexto trimestre récord consecutivo mientras la demanda de IA supera la oferta · Taiwán planea tipificar como delito las exportaciones no autorizadas de chips de IA a China.
El chip es el MTIA 450, con el nombre en clave Arke, y es la tercera generación de la línea Meta Training and Inference Accelerator de Meta. Meta lo diseña con Broadcom y encarga su fabricación a TSMC, según un informe de Bloomberg publicado el 15 de septiembre de 2026. Las primeras doce unidades llegaron de TSMC el 1 de septiembre, y los resultados iniciales se situaron dentro del 2 al 3 por ciento del rendimiento que habían previsto las simulaciones de Meta. El primer día de pruebas, el equipo ejecutó modelos de Meta, DeepSeek y Alibaba sobre el silicio.
Ese detalle importa más de lo que parece a primera vista. Ejecutar tres familias de modelos distintas el primer día, dos de ellas creadas fuera de Meta, es una señal temprana de que el chip se evalúa con una variedad de arquitecturas y no se ajusta a una única carga de trabajo interna. La precisión del primer lote frente a la simulación es la métrica que los equipos de chips siguen más de cerca, porque un diseño que falla mucho rara vez se recupera según lo previsto. Bloomberg informó de que las muestras iniciales no mostraban defectos de diseño, aunque señaló que aún quedan varios meses de depuración y optimización y que el rendimiento de fabricación de TSMC todavía está aumentando.
Doce chips, un gigavatio
La cifra destacada del plan de Meta no es el tamaño del primer lote. Es la escala a la que se ha comprometido a continuación.
Meta dice que se ha comprometido a más de 1 gigavatio de estos chips en un periodo de 12 meses, medido por consumo eléctrico, y espera que el despliegue se acelere después. La potencia es la unidad de cuenta práctica para un operador de centros de datos, porque se corresponde directamente con la superficie, la refrigeración y la capacidad eléctrica que consume un despliegue. Un gigavatio de aceleradores propios en un año es un compromiso lo bastante grande como para moldear la cadena de suministro de Meta, no un proyecto piloto.
La cifra se enmarca en una expansión mucho mayor. Reuters informó en julio de 2026 de que Meta pretende casi duplicar su capacidad informática total hasta los 14 gigavatios en 2027, frente a unos 7 gigavatios este año. Los chips propios son una porción de esa expansión, junto a las GPU compradas.
Comprobación de escala: el compromiso de 1 gigavatio de chips propios de Meta se mide en una ventana de 12 meses y es independiente del objetivo de 14 gigavatios de capacidad informática total para 2027. Los chips MTIA están pensados para trabajar junto a las GPU de Nvidia y AMD, no para sustituirlas por completo.
Para qué está hecho Arke y para qué no
El MTIA 450 está diseñado para la inferencia de propósito general, la tarea de ejecutar un modelo ya entrenado para producir respuestas, en lugar de para trabajos que exigen tiempos de respuesta casi instantáneos. El propio artículo técnico de Meta de marzo de 2026 explica el razonamiento: el ancho de banda de memoria es el factor más importante en el rendimiento de la inferencia de IA generativa, así que Meta duplicó el ancho de banda de memoria de alto rendimiento del anterior MTIA 400 al 450 e introdujo tipos de datos de baja precisión ajustados para la inferencia. Describió ese ancho de banda como «muy superior al de los principales productos comerciales existentes».
El siguiente chip va más allá. Meta dice que el MTIA 500 eleva el ancho de banda de la HBM otro 50 por ciento respecto al 450, aumenta la capacidad de HBM hasta un 80 por ciento y sube el rendimiento de MX4 un 43 por ciento. Usa una disposición 2x2 de chiplets de cómputo más pequeños rodeada de varias pilas de HBM y dos chiplets de red. El MTIA 450 está previsto para su despliegue masivo a principios de 2027; el MTIA 500, para su despliegue masivo durante 2027.
Las especificaciones expresan directamente la carga de trabajo. Los modelos de recomendación y clasificación, que alimentan los feeds de Meta desde hace años, son problemas limitados por la memoria, y la inferencia generativa también se ha vuelto uno a medida que crecen los modelos. Un chip que gasta su presupuesto de silicio en ancho de banda de memoria y aritmética agresiva de baja precisión está optimizado para el servicio, no para el trabajo intensivo en cómputo de entrenar nuevos modelos de frontera. Meta ha dicho que la línea MTIA no está pensada para entrenar los mayores modelos de lenguaje, y la cobertura independiente en Hot Chips en agosto describió el MTIA 400 como orientado sobre todo al entrenamiento de LLM, aunque señalaba que las GPU de Nvidia y AMD siguen siendo más adecuadas para esa tarea, según informó The Register.
Por qué la inferencia y por qué se canceló Olympus
El enfoque de Meta en la inferencia es un estrechamiento deliberado. La compañía trabajaba en un chip con el nombre en clave Olympus que habría gestionado tanto el entrenamiento como la inferencia, y desechó ese esfuerzo para concentrarse en diseños solo de inferencia. El coste fue un factor importante.
«Cuando empiezas a acumular gigavatios y gigavatios de capacidad, de verdad te importa el coste», dijo a Bloomberg Yee Jiun Song, vicepresidente de ingeniería de Meta. Señaló que un chip capaz de hacer tanto entrenamiento como inferencia podría ser alrededor de un 30 por ciento más caro, una diferencia que calificó de «completamente inaceptable» a esa escala.
La aritmética que hay detrás de ese comentario es sencilla. A volúmenes de gigavatios, un recargo del 30 por ciento por chip se acumula en una suma enorme, y una pieza que solo es aceptable en dos tareas puede perder frente a otra excelente en una. Dividir la hoja de ruta permite a Meta comprar GPU de terceros para el entrenamiento, donde las cargas de trabajo y las arquitecturas de los modelos se mueven más rápido y la flexibilidad es lo más importante, y usar silicio propio para la inferencia estable y de gran volumen que sigue patrones predecibles. Es la misma división por la que han optado Amazon, Google y Microsoft, con distinto énfasis.
A Astrid le queda un mes para terminar el diseño
El chip posterior a Arke ya está cerca sobre el papel. Meta espera que el MTIA 500, con el nombre en clave Astrid, complete su diseño en aproximadamente un mes y entre en los centros de datos para finales de 2027, con un despliegue más amplio que Arke. Bloomberg informó de que Astrid está pensado para un uso más amplio, lo que sugiere que Meta espera que supere un listón más alto de rendimiento por dólar.
Después de Astrid, Meta pretende centrar la atención en la velocidad y el rendimiento, y TrendForce señaló que la tecnología de interconexión de fibra óptica podría aportar más mejoras de rendimiento. La propia cadencia es una estrategia: Meta ha estado lanzando generaciones de MTIA con intervalos de unos seis meses, más rápido que el ritmo anual o más lento típico de los chips de IA de terceros, para poder incorporar rápidamente las lecciones de una generación en la siguiente. Meta ha descrito este enfoque de «velocidad» como una forma de mantener el silicio alineado con arquitecturas de modelos que cambian deprisa.
La ola de silicio propio a la que se suma Meta
Meta no construye en el vacío. Todos los grandes hiperescaladores y varios laboratorios de IA diseñan ya sus propios aceleradores para las cargas de trabajo que dominan sus centros de datos, un cambio que lleva una década gestándose.
El TPU de Google es el programa más antiguo y maduro, ya con ocho generaciones. Amazon utiliza Trainium para el entrenamiento e Inferentia para la inferencia, vendidos como instancias de nube alquilables. El Maia 200 de Microsoft, una pieza centrada en la inferencia sobre el proceso de 3 nanómetros de TSMC, funciona dentro de Azure. OpenAI presentó su primer chip propio, con el nombre en clave Jalapeño, junto a Broadcom en junio de 2026, un diseño solo de inferencia previsto para desplegarse a finales de 2026.
Broadcom está detrás de varios de estos esfuerzos. La compañía codiseña chips para Google, Meta y OpenAI, y los analistas del sector sitúan su cuota del mercado de diseño de aceleradores propios cerca del 70 por ciento. En la práctica, eso significa que la ola de silicio propio es menos una historia de empresas que van por su cuenta que la de unos pocos socios de diseño, una fundición dominante y un puñado de proveedores de memoria que se estrechan en un nuevo tipo de cadena de suministro. Todos los programas importantes, incluido el de Meta, fabrican en TSMC, como señala el repaso de Tom's Hardware del panorama.
El muro de la memoria
Esa dependencia compartida apunta a la restricción que puede importar más. Todas las generaciones de MTIA dependen en gran medida de la memoria de alto rendimiento, y la HBM es el insumo más escaso de la cadena de suministro de IA ahora mismo.
La escasez no es un pico temporal. Una investigación del CSIS descrita en septiembre de 2026 apuntaba a una escasez mundial de memoria que se espera que persista durante todo 2027 y posiblemente hasta 2028, impulsada por la concentración de la producción de HBM en tres proveedores y los largos plazos necesarios para construir nuevas fábricas. J.P. Morgan Global Research estimó que los precios de la DRAM subirían más de un 400 por ciento desde principios de 2024 hasta finales de 2026, y la propia Meta elevó su previsión de gasto de capital en 10.000 millones de dólares, alegando mayores costes de hardware de IA y de memoria.
Los ingenieros de Meta han sido sinceros sobre la exposición. Song dijo a CNBC a principios de este año que la compañía estaba «absolutamente preocupada por el suministro de HBM», aunque afirmó que se había asegurado suficiente para respaldar los despliegues previstos, según informó TrendForce en marzo. Meta ha firmado acuerdos a largo plazo con Samsung Electronics para memoria, Sandisk para almacenamiento flash y Sumitomo Electric para equipos de fibra óptica, según la revisión de Reuters de un memo interno. Diseñar un chip en torno a la HBM es una apuesta; conseguir suficiente a un precio tolerable es otra distinta.
La comparación con Nvidia y por qué no está demostrada
Meta hace una afirmación rotunda sobre dónde se sitúa su silicio. La compañía dice que sus chips pueden ejecutar modelos de IA con más eficiencia que «lo que Nvidia tenga en el mercado en ese momento», un planteamiento que tanto Bloomberg como TrendForce atribuyen a Meta.
Esa afirmación no está verificada. Meta no ha publicado comparativas directas con las piezas actuales de Nvidia, y «más eficiente» no es una métrica estandarizada. Puede referirse al rendimiento por vatio, al coste por token, al caudal por rack o a alguna combinación, y la respuesta puede variar según la carga de trabajo. El silicio propio tiene una larga historia de superar a la generación anterior del hardware de Nvidia y quedarse por detrás de la actual en capacidad bruta, y la comparación justa depende de qué modelos, tamaños de lote y formatos de precisión se usen. Hasta que existan pruebas independientes, la afirmación debe tratarse como posicionamiento de un proveedor y no como un resultado medido.
Sin embargo, hay una razón estructural para esperar mejoras reales en casos concretos. Un chip hecho solo para inferencia puede eliminar la generalidad que una GPU de terceros debe cargar, y Meta controla su propia pila de servicio, sus compiladores y su mezcla de cargas de trabajo. Las empresas que conocen su tráfico con precisión pueden capturar ahorros que una pieza de propósito general no puede igualar. La pregunta abierta es cuánto de la afirmación sobrevive al contacto con la carga de trabajo de producción completa de Meta.
Qué hay que observar
Tres cosas mostrarán si el programa de chips de Meta cumple la promesa que hace.
La primera es si la diferencia del 2 al 3 por ciento frente a la simulación se mantiene cuando Meta pasa de una docena de muestras de ingeniería al volumen. Las muestras de ingeniería favorecen a un diseño; el rendimiento de fabricación, el comportamiento térmico a escala de rack y la madurez del software tienden a reducir o ampliar esa diferencia, y Meta ha dicho que aún quedan varios meses de depuración y optimización.
La segunda es el suministro de HBM. El objetivo de despliegue de Meta se expresa en gigavatios, pero sus chips se expresan en ancho de banda de memoria, y ambos están ligados. Si la HBM homologada sigue escasa durante 2027, incluso un chip potente puede verse limitado por lo que lo rodea.
La tercera es si Astrid llega según lo previsto. Un diseño completado en aproximadamente un mes y un despliegue para finales de 2027 es una secuencia agresiva, y un solo retraso de una generación basta para reiniciar la cadencia que da su ventaja al enfoque de Meta. Nvidia, mientras tanto, sigue lanzando sus propias plataformas de nueva generación, así que la comparación que Meta invita se seguirá poniendo a prueba en público.
Por ahora, los hechos verificados son más estrechos que la ambición. Meta tiene un chip de inferencia de tercera generación en pruebas, doce unidades en la mano, un compromiso de 1 gigavatio y un sucesor en diseño. Si la economía acompaña es la parte que se resolverá en 2027.
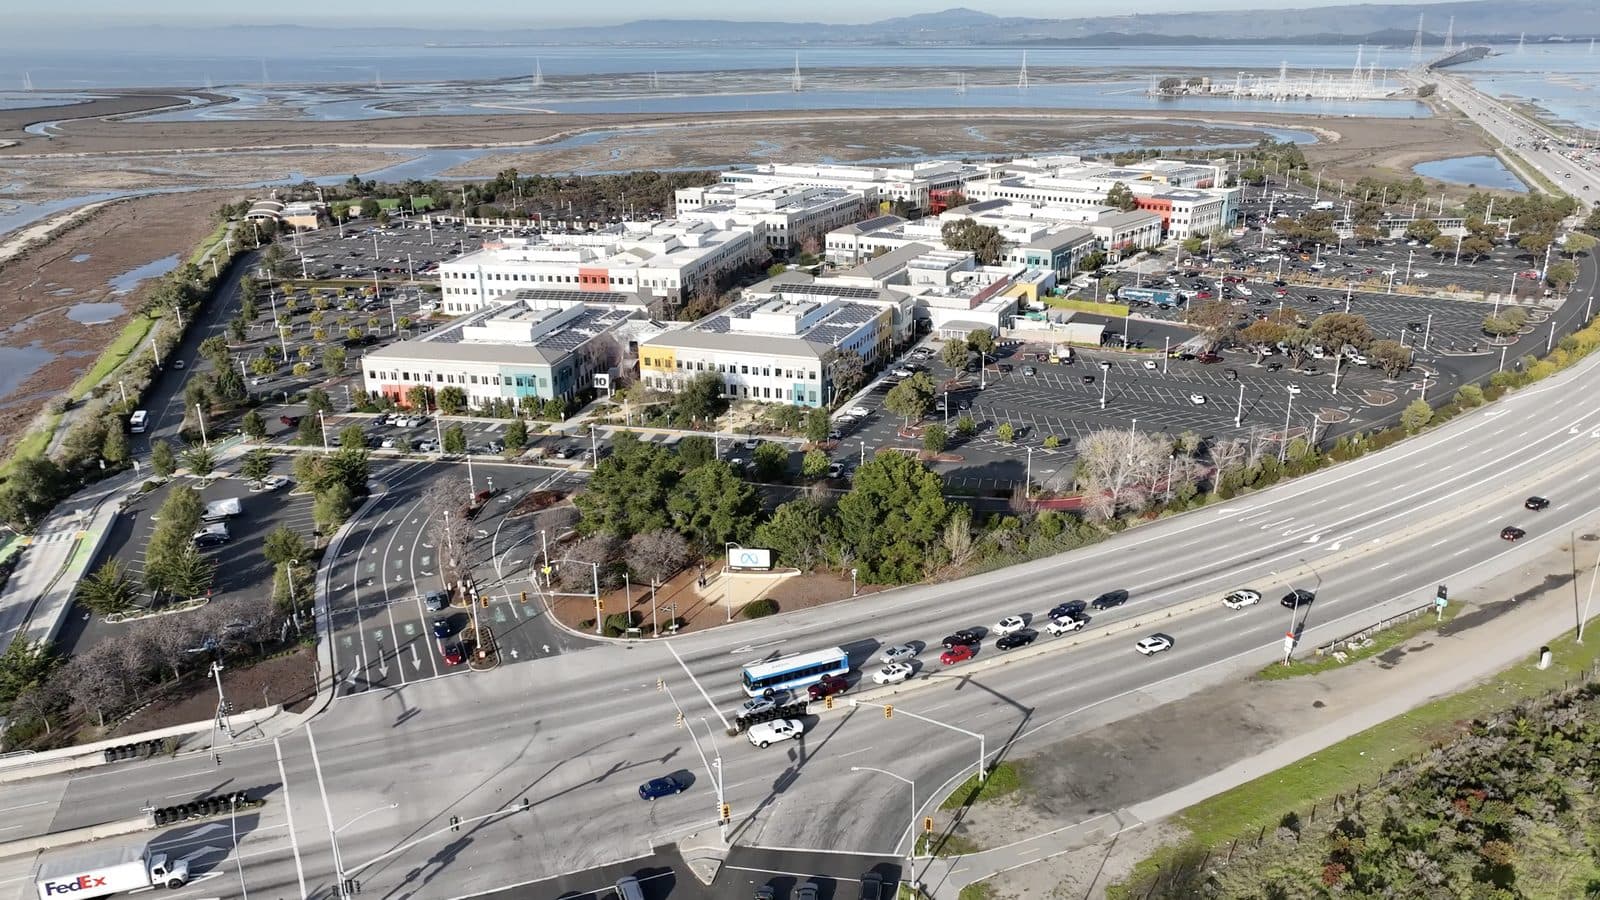
Portada: vista aérea de la sede de Meta en Menlo Park, California, por InvadingInvader (CC BY-SA 4.0) vía Wikimedia Commons, recortada a 16:9.
Etiquetas
Preguntas frecuentes
- ¿Qué es el chip MTIA 450 de Meta?
- MTIA 450, con el nombre en clave Arke, es la tercera generación de la línea Meta Training and Inference Accelerator propia de Meta. Está diseñado con Broadcom y fabricado por TSMC, y apunta a la inferencia de IA de propósito general en lugar de a cargas de trabajo de latencia ultrabaja. Meta planea desplegarlo en centros de datos en la primera mitad de 2027.
- ¿Cuándo desplegará Meta sus chips de IA propios?
- Bloomberg informó el 15 de septiembre de 2026 de que Meta planea empezar a desplegar el MTIA 450 en la primera mitad de 2027. Su sucesor, el MTIA 500 o Astrid, debería terminar su diseño en aproximadamente un mes y entrar en los centros de datos para finales de 2027.
- ¿Está verificada la afirmación de Meta de que sus chips superan a Nvidia?
- No. Meta dice que sus chips ejecutan modelos de IA con más eficiencia que «lo que Nvidia tenga en el mercado en ese momento», pero es una afirmación de la empresa y no un benchmark verificado de forma independiente. Meta no ha publicado resultados comparativos directos con las piezas actuales de Nvidia.
- ¿Por qué fabrica Meta sus propios chips de IA?
- Meta dice que el silicio propio reduce el coste y la energía necesarios para ejecutar modelos de IA a escala. Diseñar para sus propias cargas de trabajo le permite ajustar el ancho de banda de memoria, la precisión y la eficiencia. Meta sigue comprando GPU de Nvidia y AMD para el entrenamiento y otras cargas de trabajo.

TPW Editorial
Redacción
El equipo editorial de TechPastWeek investiga y edita cada artículo que publicamos. Cada historia se contrasta con fuentes primarias y secundarias fiables, y un editor la revisa antes de publicarse.